


Майамский стартап Subquadratic заявляет о 1000-кратном росте эффективности ИИ с моделью SubQ; исследователи требуют независимых доказательств.
Источник: VentureBeat · Michael Nuñez


Малоизвестный стартап из Майами под названием Subquadratic во вторник вышел из тени с громким заявлением: им удалось создать первую большую языковую модель, которая полностью преодолевает математическое ограничение, определявшее — и ограничивавшее — все основные ИИ-системы с 2017 года.
Компания утверждает, что ее первая модель SubQ 1M-Preview является первой LLM, построенной на полностью субквадратичной архитектуре, в которой вычислительные затраты растут линейно с длиной контекста. Если это утверждение подтвердится, это станет настоящим переломным моментом в масштабировании ИИ-систем. По словам представителей компании, при работе с 12 миллионами токенов их архитектура сокращает объем вычислений внимания почти в 1000 раз по сравнению с другими передовыми моделями. Этот показатель, если он пройдет независимую проверку, затмит прирост эффективности любого существующего подхода.
Компания также запускает три продукта в закрытой бета-версии: API с полным окном контекста, агент для написания кода из командной строки под названием SubQ Code и инструмент поиска SubQ Search. Стартап привлек 29 миллионов долларов в рамках посевного раунда финансирования от инвесторов, среди которых соучредитель Tinder Джастин Матин (Justin Mateen), бывший партнер SoftBank Vision Fund Хавьер Вильямисар (Javier Villamizar), а также ранние инвесторы Anthropic, OpenAI, Stripe и Brex. Издание The New Stack сообщило, что по итогам раунда компания оценивается в 500 миллионов долларов.
Цифры, которые публикует Subquadratic, экстраординарны. Реакция исследовательского сообщества в сфере ИИ оказалась, мягко говоря, неоднозначной — от искреннего любопытства до открытых обвинений в создании «пустышки» (vaporware). Чтобы понять почему, нужно разобраться, какую именно проблему компания якобы решила и почему так много предыдущих попыток решения этой же задачи потерпели неудачу.
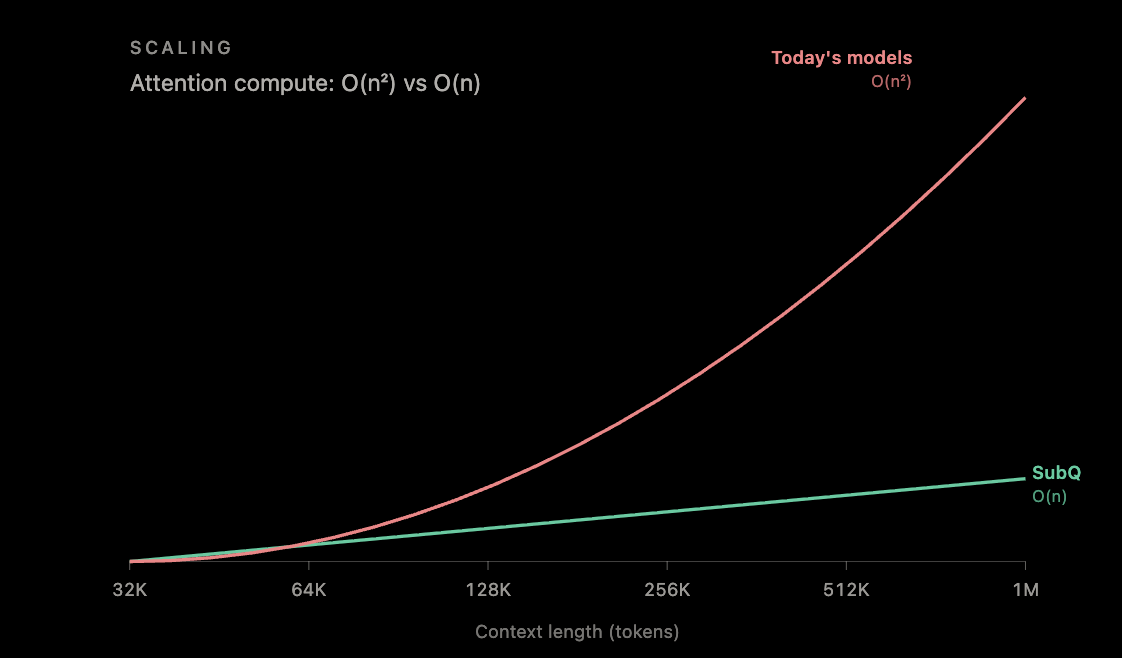
Как вычисления внимания соотносятся с длиной контекста. В стандартных трансформерах затраты растут квадратично: удвоение длины входа увеличивает объем вычислений вчетверо. Subquadratic заявляет, что ее архитектура масштабируется линейно. (Источник изображения: Subquadratic)
Проблема квадратичного масштабирования сформировала экономику всей индустрии ИИ
Каждая ИИ-модель на базе архитектуры transformer (а это практически любая передовая система от OpenAI, Anthropic, Google и других) опирается на операцию под названием «внимание» (attention). Каждый токен сравнивается с каждым другим токеном, поэтому по мере роста входных данных количество взаимодействий и объем вычислений, необходимых для их обработки, масштабируются квадратично. Проще говоря: удваиваете размер входа, и стоимость не удваивается. Она возрастает вчетверо.
Эта закономерность определила то, что создается разработчиками, а что — нет. Стандартом индустрии являются 128 000 токенов для многих ИИ-моделей и до 1 миллиона токенов для передовых облачных моделей, таких как Claude Sonnet 4.7 и Gemini 3.1 Pro.
Даже при таких объемах стоимость обработки длинных входных данных становится обременительной. Индустрия выстроила сложный стек обходных путей. Системы RAG используют поисковую систему для извлечения небольшого количества релевантных результатов перед отправкой их модели, поскольку передача всего массива данных нецелесообразна. Разработчики надстраивают над моделями конвейеры извлечения данных, стратегии разбиения на фрагменты (chunking), техники промпт-инжиниринга и системы мультиагентной оркестрации — и всё это ради того, чтобы обойти фундаментальное ограничение: сама модель не способна эффективно обрабатывать всё сразу.
Аргумент Subquadratic заключается в том, что эти обходные пути дороги, хрупки и в конечном счете ограничивают возможности. Как рассказал в интервью SiliconANGLE технический директор Александр Уидон (Alexander Whedon): «Раньше я вручную отбирал промпты, системы извлечения данных, оценки и условную логику, чтобы объединять рабочие процессы в цепочки. И я думаю, что это своего рода пустая трата человеческого интеллекта, а также ограничение качества продукта».
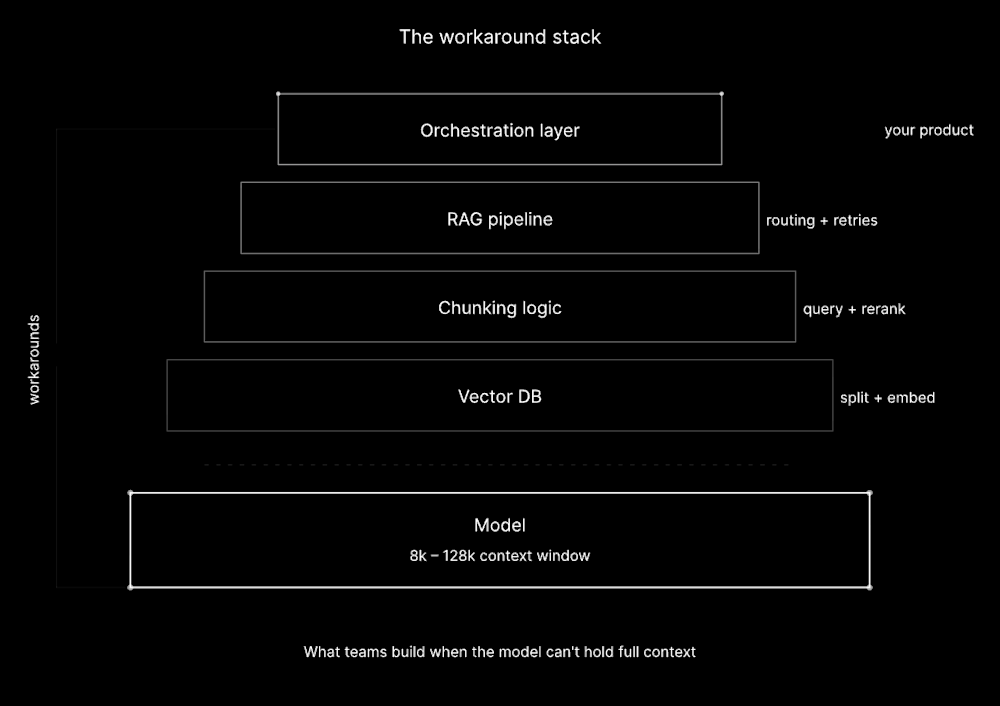
Уровни инфраструктуры, создаваемые командами разработчиков ИИ для компенсации ограниченных окон контекста: оркестрация, конвейеры извлечения данных, логика разбиения на фрагменты и векторные базы данных — все они находятся поверх модели, способной обработать лишь малую долю требуемой информации. (Источник изображения: Subquadratic)
Решение Subquadratic обманчиво просто: перестать выполнять ненужные математические вычисления
Подход компании, получивший название разреженного внимания Subquadratic (Subquadratic Sparse Attention) или SSA, основан на простой предпосылке: большинство сравнений токен-то-токен в стандартном механизме внимания являются пустой тратой вычислений. Вместо того чтобы сравнивать каждый токен с каждым, SSA учится определять, какие именно сравнения имеют значение, и вычисляет внимание только для этих позиций. Что особенно важно, этот выбор зависит от контента: модель решает, куда смотреть, основываясь на смысле, а не на фиксированных позиционных паттернах. Это позволяет ей извлекать конкретную информацию из произвольных позиций в очень длинном контексте без уплаты квадратичного налога.
Практический выигрыш масштабируется с длиной контекста — ровно наоборот по сравнению с проблемой, которую компания пытается решить. Согласно техническому блогу компании, SSA обеспечивает 7,2-кратное ускорение предварительного заполнения (prefill) по сравнению с плотным вниманием при 128 000 токенах, а при 1 миллионе токенов этот показатель возрастает до 52,2 раз. Как выразился Уидон: «Если вы удваиваете размер входа при законах квадратичного масштабирования, вам требуется в четыре раза больше вычислений; при законах линейного масштабирования — всего в два раза». Компания заявляет, что обучала модель в три этапа — предварительное обучение (pretraining), контролируемая доводка (supervised fine-tuning) и этап обучения с подкреплением, нацеленный именно на устранение сбоев при извлечении информации из длинного контекста. Это учило модель активно использовать удаленный контекст вместо того, чтобы по умолчанию опираться на близлежащую информацию — тонкий режим сбоя, который незаметно ухудшает производительность в существующих системах.
Три бенчмарка рисуют впечатляющую картину, но то, что осталось за кадром, может иметь куда больший вес
На первый взгляд показатели SubQ в бенчмарках конкурентоспособны или превосходят модели, созданные организациями, тратящими миллиарды долларов. В тесте SWE-Bench Verified модель набрала 81,8% по сравнению с 80,8% у Opus 4.6 и 80,0% у DeepSeek 4.0 Pro. В тесте RULER при 128 000 токенах (стандартный бенчмарк для проверки рассуждений на расширенных входных данных) SubQ набрала 95%, немного опередив Claude Opus 4.6 с его 94,8%. В MRCR v2, требовательном тесте на многоэтапное (multi-hop) извлечение информации в длинном контексте, SubQ продемонстрировала проверенный независимыми экспертами результат в 65,9% против 32,2% у Claude Opus 4.7, 74% у GPT-5.5 и 26,3% у Gemini 3.1 Pro.
Однако несколько деталей заслуживают пристального внимания. Набор бенчмарков узок — всего три теста, причем все они акцентируют внимание на извлечении длинного контекста и написании кода, то есть именно на тех задачах, для которых и создавалась SubQ. Более широкие оценки общих способностей к рассуждениям, математике, многоязычности и безопасности опубликованы не были. Компания заявляет, что полная карточка модели (model card) «появится в ближайшее время».
По данным The New Stack, каждая модель в бенчмарках запускалась всего один раз из-за высоких затрат на инференс, а показатель в SWE-Bench, как признает сама статья компании, отражает «надежность тестовой обвязки в такой же степени, как и самой модели» (harness as much as model). В методологии бенчмарков единичные запуски без указания доверительных интервалов оставляют простор для погрешности. Кроме того, существует значительный разрыв между результатами исследований SubQ и ее производственной моделью. В MRCR v2 компания заявляла о результатах лабораторных исследований на уровне 83 баллов, однако проверенная независимыми экспертами продакшн-модель набрала 65,9. Этот разрыв в 17 пунктов между лабораторным результатом и поставляемым продуктом заслуживает внимания и остается по большей части без объяснений.
Представители Subquadratic также сообщили SiliconANGLE, что в бенчмарке RULER 128K модель SubQ продемонстрировала точность 95% при стоимости в 8 долларов, в то время как у Claude Opus точность составила 94% при затратах около 2600 долларов — весьма впечатляющее заявление о рентабельности. Тем не менее компания не раскрыла публично конкретные цены на API, из-за чего независимая проверка сравнения затрат на выполнение задач невозможна.
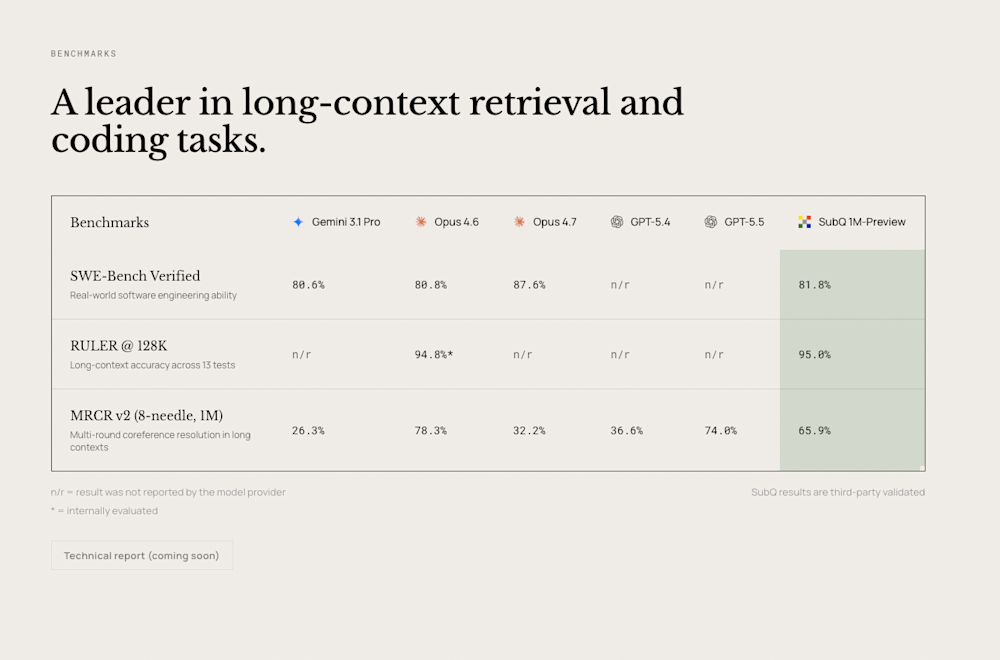
Опубликованные результаты Subquadratic в бенчмарках. Компания выбрала три теста, делающие упор на извлечение длинного контекста и кодинг — те области, где ее архитектура должна иметь наибольшее преимущество. Более широкие оценки не публиковались. (Источник: Subquadratic)
Вердикт исследовательского сообщества ИИ варьируется от «подлинного прорыва» до «ИИ-аферы в стиле Theranos»
Через несколько часов после анонса исследовательское сообщество в сфере ИИ погрузилось в дебаты, сведшиеся к единственному вопросу: реально ли это?
ИИ-обозреватель Дэн Макатир (Dan McAteer) охарактеризовал поляризованное настроение в популярном посте: «SubQ — это либо величайший прорыв со времен Трансформера… либо это ИИ-Theranos». Сравнение со скандальной мошеннической компанией по анализу крови может быть не совсем справедливым, но оно отражает масштаб сделанных заявлений. Скептики сосредоточились на нескольких уязвимых точках. Известный ИИ-инженер Уилл Депью (Will Depue) изначально отметил, что SubQ — это «почти наверняка дообученная (finetune) с использованием разреженного внимания версия Kimi или DeepSeek», имея в виду уже существующие открытые модели.
Уидон подтвердил это на платформе X, написав, что компания «использует веса из моделей с открытым исходным кодом в качестве отправной точки, в силу нашего финансирования и зрелости как компании». Позже Депью усилил критику, написав, что заявления компании о масштабировании O(n) и цифры ускорения «не сходятся воедино», и назвал коммуникацию «невероятно плохо поданной или просто ненастоящей».
Другие подняли структурные вопросы. Один из разработчиков отметил, что если SubQ действительно сокращает объем вычислений в 1000 раз и стоит менее 5% от стоимости Opus, у компании не должно возникнуть проблем с обслуживанием пользователей в масштабе — так зачем закрывать доступ через программу раннего доступа? Разработчик Степан Гончаров назвал бенчмарки «очень интересными тщательно отобранными тестами», в то время как другой комментатор охарактеризовал их как «подозрительно безупречные».
Впрочем, скептицизм разделяли не все. ИИ-исследователь Джон Рисана (John Rysana) выступил против сравнений с Theranos, написав, что эта работа представляет собой «просто качественно реализованное субквадратичное внимание, что очень значимо для рабочих нагрузок с длинным контекстом», и что «вероятность того, что это туфта, крайне мала». Линус Экенстам (Linus Ekenstam), технический обозреватель, заявил, что он «крайне интригован возможностью увидеть реальные последствия», особенно для сложного программного обеспечения на базе ИИ.
Magic.dev делала поразительно похожие заявления два года назад — а затем затихла
Пожалуй, самая едкая критика запуска SubQ исходит не из ее конкретных заявлений, а из недавней истории. В августе 2024 года компания Magic.dev анонсировала модель с контекстным окном в 100 миллионов токенов, заявив о 1000-кратном преимуществе в эффективности и привлекла около 500 миллионов долларов на волне этих утверждений. По состоянию на начало 2026 года нет никаких публичных доказательств использования LTM-2-mini за пределами самой Magic.
Параллели вызывают неуверенность. Обе компании заявляли об огромных окнах контекста. Обе хвастались примерно 1000-кратным приростом эффективности. Обе выбрали разработку программного обеспечения в качестве своего основного варианта использования. И обе запустились с ограниченным внешним доступом.
Более широкий исследовательский ландшафт подкрепляет необходимость осторожности. Kimi Linear, DeepSeek Sparse Attention, Mamba и RWKV — все они обещали субквадратичное масштабирование, и все столкнулись с одной и той же проблемой: архитектуры, достигающие линейной сложности в теории, часто уступают квадратичному вниманию в последующих бенчмарках при переходе к масштабному уровню, либо оказываются гибридными, смешивая субквадратичные слои со стандартным вниманием и теряя чистые преимущества масштабирования.
В широко цитируемом анализе на LessWrong утверждается, что подобные подходы «лучше рассматривать как „инкрементальное улучшение номер 93595 для архитектуры трансформера“», поскольку практические реализации остаются квадратичными и «лишь улучшают внимание в константный фактор раз».
В Subquadratic прекрасно осведомлены об этой истории. В собственном техническом блоге компании подробно рассматривается каждый из предыдущих подходов — разреженное внимание с фиксированными паттернами, модели пространства состояний (state space models), гибридные архитектуры и разреженное внимание DeepSeek — с аргументацией в пользу того, что SSA позволяет избежать их компромиссов. Справедливо ли это на самом деле, остается эмпирическим вопросом, разрешить который способна только независимая оценка.
Пятикратный основатель, бывший инженер Meta и 29 миллионов долларов на то, чтобы доказать неправоту скептиков
Оценивая сделанные заявления, нельзя не учитывать бэкграунд команды, стоящей за ними. Генеральный директор Джастин Дангель (Justin Dangel) является пятикратным основателем и CEO с опытом работы в сферах медицинских технологий, страховых технологий и потребительских товаров; его компании вырастали до сотен сотрудников, привлекали институциональную поддержку и доходили до стадии ликвидности. Технический директор Александр Уидон ранее работал инженером-программистом в Meta и занимал должность руководителя направления генеративного ИИ в TribeAI, где руководил более чем 40 внедрениями корпоративного ИИ.
В команду входят 11 исследователей со степенями PhD, имеющих опыт работы в Meta, Google, Оксфорде, Кембридже, ByteDance и Adobe. Это заслуживающий доверия набор талантов для исследовательских работ архитектурного уровня. Тем не менее, ни один из соучредителей не публиковал фундаментальных исследований в области ИИ, а компания пока не выпустила рецензируемую научную работу. Технический отчет помечен как «скоро появится».
Финансовый профиль необычен для компании, заявляющей о претензиях на лидерство в сфере ИИ. Subquadratic привлекла 29 миллионов долларов при заявленной оценке в 500 миллионов — крутая цена для посевного стартапа без общедоступной модели, без рецензируемых исследований и без раскрытой выручки. База инвесторов во главе с соучредителем Tinder Матином и бывшим партнером SoftBank Вильямисаром склоняется в сторону потребительских технологий и инвестиций в рост, а не глубоких технических исследований в области ИИ. Компания не открывает веса своих моделей, но планирует предложить инструменты обучения для предприятий, чтобы те могли проводить собственную доводку (post-training), и нацелена на создание окна контекста в 50 миллионов токенов в четвертом квартале.
Настоящая проверка для SubQ — это не бенчмарки, а то, выдержит ли математика независимый контроль
Если отбросить маркетинговую риторику и драму в социальных сетях, фундаментальный вопрос, который ставит Subquadratic, действительно важен: могут ли ИИ-системы освободиться от квадратичного масштабирования без ущерба для качества, которое делает их полезными?
Ставки огромны. Если механизм внимания удастся сделать по-настоящему линейным без ухудшения извлечения данных и рассуждений, экономика ИИ кардинально изменится. Корпоративные приложения, требующие сегодня сложных конвейеров извлечения информации (обработки целых кодовых баз, контрактов, нормативных документов, медицинских карт), превратятся в однопроходные операции. Миллиарды долларов, которые в настоящее время тратятся на инфраструктуру RAG, управление контекстом и агентскую оркестрацию, станут частично избыточными.
Готовность Уидона публично вступать в технические дискуссии и критику — публикация технического блога всего через несколько часов после отпора — говорит о команде, которая понимает: ей необходимо показывать результаты своей работы, а не просто описывать их. И к чести компании, она открыто признала, что опирается на основы с открытым исходным кодом и что ее модель меньше, чем разработки в ведущих лабораториях.
Каждая передовая модель в 2026 году рекламирует окно контекста по меньшей мере в миллион токенов, но почти ни одна из них на самом деле не умеет эффективно использовать всю эту информацию. Разрыв между номинальным окном контекста и функциональным — между тем, что модель принимает, и тем, над чем она надежно способна рассуждать — остается одной из важнейших нерешенных проблем в сфере ИИ. Subquadratic заявляет, что закрыла этот разрыв. Если независимая оценка подтвердит это утверждение, последствия выйдут далеко за рамки оценки одного стартапа. Если нет, компания пополнит растущий список обещаний о длинном контексте, которые звучали революционно в день запуска и заурядно шесть месяцев спустя.
В вычислениях любое фундаментальное ограничение рано или поздно падает. Когда это происходит, прорыв никогда не исходит с той стороны, которую ожидала индустрия. Над Subquadratic нависает вопрос: действительно ли команда из 11 обладателей PhD и с 29 миллионами долларов посевного финансирования нашла ответ, ускользавший от организаций, тратящих в тысячи раз больше, — или они просто нашли способ получше описать саму проблему?




