Meta заявляет, что Muse Spark 1.3 обладает производительностью передового уровня — но ее лучшие результаты обеспечиваются моделью, которую разработчики пока не могут широко использовать
Источник: VentureBeat · Carl Franzen


Новейшая модель искусственного интеллекта Muse Spark 1.3 от Meta, представленная вчера, работает быстрее и показывает лучшие результаты на сторонних бенчмарках по сравнению со своим предшественником — с оговоркой.
«Muse Spark 1.3 выходит сегодня с передовой производительностью, стоимость которой практически не поддается учету», — написал соучредитель и генеральный директор Meta Марк Цукерберг на X, назвав этот релиз «самым большим скачком» компании в области написания кода и агентской работы.
За обеими частями этого заявления стоят реальные факты. Muse Spark 1.3 демонстрирует значительный прогресс по сравнению с майским релизом версии 1.2, особенно в выполнении долгосрочных задач для ИИ-агентов. Версия, к которой разработчики теперь могут получить доступ, также является одним из лучших предложений по соотношению цены и производительности в верхней части независимых рейтингов моделей.
Самые высокие результаты Muse Spark 1.3 на бенчмарках получены в режиме максимального рассуждения (max reasoning). По заявлению Meta, эта версия все еще проходит дополнительное тестирование на безопасность и появится «в скором времени»; стороннее бенчмарк-агентство Artificial Analysis сообщает, что оценило конфигурацию max в рамках ограниченного предварительного просмотра для партнеров и в настоящее время вообще не указывает провайдеров API для этой конфигурации.
Версия, широко выпускаемая на этой неделе через среду разработки Muse Code и Meta Model API, использует ранее доступные настройки рассуждения Meta, включая xhigh.
Из-за этого перед корпоративными клиентами встает более актуальный вопрос: не сможет ли Muse Spark 1.3 достичь передового уровня, а насколько близко к нему окажется модель, которую компании могут развернуть уже сегодня — и по какой реальной цене.
Поставляемая модель очень хороша, но не лидирует в бенчмарках
Meta действительно приводит результаты для обеих конфигураций в своем базовом отчете об оценке, так что компания не скрывает развертываемую модель. Однако в своих презентационных материалах она наглядно демонстрирует именно вариант max, и некоторые из самых высоких баллов принадлежат именно ему.
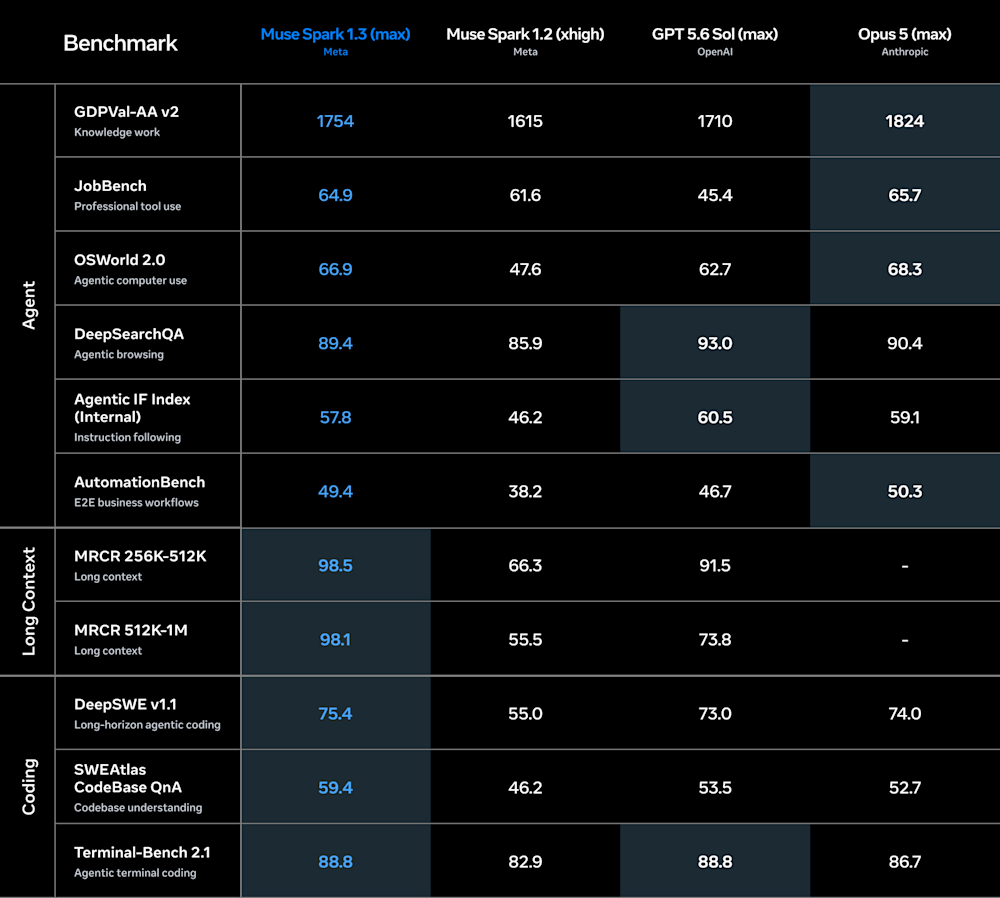
Бенчмарки Meta Muse Spark 1.3. Источник: VentureBeat, создано с помощью OpenAI ChatGPT-Images-2.0
Например, Meta сообщает о результатах GDPval-AA v2 на уровне 1 754 баллов по шкале Elo для max против 1 709 для xhigh, OSWorld 2.0 — 66,9 против 57,2, а JobBench — 64,9 против 61,2.
В некоторых тестах разница незначительна или имеет обратный характер: в DeepSearchQA зафиксирована ничья на уровне 89,4, в то время как xhigh набирает 89,2 в Terminal-Bench 2.1 против 88,8 у max.
Artificial Analysis оценивает Muse Spark 1.3 max в 62 балла по своему Индексу интеллекта (Intelligence Index), а выпускаемую версию xhigh — в 61 балл. Последняя делит позиции с GPT-5.6 Sol max, Grok 4.6 high и Claude Opus 5 high. Тем не менее, верхнюю строчку лидерборда по-прежнему занимает Anthropic: Claude Fable 5.1 достигает 66 баллов в режиме max и 65 в xhigh, в то время как Claude Opus 5 набирает 63 балла в обоих режимах.
Иными словами, Muse Spark 1.3 xhigh закономерно входит в число передовых моделей, но не задает стандарты на самом переднем крае.
Тем не менее, это существенный шаг вперед по сравнению с Muse Spark 1.2. В материалах VentureBeat, посвященных прошлогоднему релизу, отмечалось, что Meta вывела на рынок убедительного конкурента в сфере написания кода, который тем не менее в целом уступал лучшей модели Anthropic. Muse Spark 1.2 набрала 82,9% в Terminal-Bench 2.1 против 86,7% у Opus 5, а также уступила Opus в других основных тестах на программирование, представленных Meta.
В версии 1.3 компания Meta уже не просто присутствует в этой борьбе. В ряде тестов на кодинг и агентские задачи она на равных конкурирует с OpenAI и Anthropic.
По словам представителей Meta, базовой моделью стало проще управлять. Muse Spark 1.3 обучена поддерживать множество рабочих процессов в рамках длинной ветки обсуждения, собирать контекст с помощью инструментов, выявлять пробелы в собственных планах, запрашивать у пользователей уточнения при необходимости и подтверждать действия перед их выполнением. Во внутренних сравнениях инженеров Meta модель использовала примерно на 20% меньше вызовов инструментов и на 25% меньше токенов во время написания кода по сравнению с версией 1.2.
Для предприятий, оплачивающих тысячи или миллионы итераций работы агентов, эти поведенческие улучшения могут оказаться важнее еще одного балла в рейтинге.
«Практически бесплатно» не означает, что Meta снизила цены
Цены на API для Muse Spark 1.3 не снижались. Компания Meta оставила стандартные расценки на уровне Muse Spark 1.2: $1,25 за миллион входных токенов, $4,25 за миллион выходных токенов и $0,15 за миллион кэшированных входных токенов.
|
Модель |
Вход ($/1 млн) |
Выход ($/1 млн) |
Итого ($/1 млн) |
Источник |
|
Muse Spark 1.2 / 1.3 Contributor |
$0,10 |
$0,20 |
$0,30 |
|
|
MiMo-V2.5 Flash |
$0,10 |
$0,30 |
$0,40 |
|
|
DeepSeek-V4-Flash — вне пика |
$0,22 |
$0,66 |
$0,88 |
|
|
GPT-5.6 Luna |
$0,20 |
$1,20 |
$1,40 |
|
|
MiniMax-M3 |
$0,30 |
$1,20 |
$1,50 |
|
|
LongCat-2.0 — акция |
$0,30 |
$1,20 |
$1,50 |
|
|
DeepSeek-V4-Flash — часы пик |
$0,44 |
$1,32 |
$1,76 |
|
|
MiMo-V2.5 |
$0,40 |
$2,00 |
$2,40 |
|
|
DeepSeek-V4-Pro — вне пика |
$0,66 |
$1,98 |
$2,64 |
|
|
LongCat-2.0 — стандарт |
$0,75 |
$2,95 |
$3,70 |
|
|
MiMo-V2.5 Pro (≤256K) |
$1,00 |
$3,00 |
$4,00 |
|
|
Gemini 3.7 Flash — до 31 декабря 2026 г. |
$0,75 |
$3,75 |
$4,50 |
|
|
Gemini 3.8 Flash — до 31 декабря 2026 г. |
$0,75 |
$3,75 |
$4,50 |
|
|
DeepSeek-V4-Pro — часы пик |
$1,32 |
$3,96 |
$5,28 |
|
|
Muse Spark 1.1 / 1.2 / 1.3 |
$1,25 |
$4,25 |
$5,50 |
|
|
GLM-5.3 |
$1,40 |
$4,40 |
$5,80 |
|
|
Grok 4.6 — <200K токенов промпта |
$2,00 |
$6,00 |
$8,00 |
|
|
MiMo-V2.5 Pro (>256K) |
$2,00 |
$6,00 |
$8,00 |
|
|
Qwen3.8-Max |
$2,00 |
$6,00 |
$8,00 |
|
|
Gemini 3.7 Flash — с 1 января 2027 г. |
$1,50 |
$7,50 |
$9,00 |
|
|
Gemini 3.8 Flash — с 1 января 2027 г. |
$1,50 |
$7,50 |
$9,00 |
|
|
GPT-5.6 Terra |
$2,00 |
$12,00 |
$14,00 |
|
|
Grok 4.6 — ≥200K токенов промпта |
$4,00 |
$12,00 |
$16,00 |
|
|
GPT-5.4 |
$2,50 |
$15,00 |
$17,50 |
|
|
Kimi K3 |
$3,00 |
$15,00 |
$18,00 |
|
|
Claude Opus 5 |
$5,00 |
$25,00 |
$30,00 |
|
|
Sakana Fugu Ultra (≤272K) |
$5,00 |
$30,00 |
$35,00 |
|
|
GPT-5.6 Sol — Стандартный режим |
$5,00 |
$30,00 |
$35,00 |
|
|
Claude Fable 5 / Claude Mythos 5 |
$10,00 |
$50,00 |
$60,00 |
|
|
Claude Fable 5.1 / Claude Mythos 5.1 |
$10,00 |
$50,00 |
$60,00 |
|
|
GPT-5.6 Sol — Быстрый режим |
$10,00 |
$60,00 |
$70,00 |
Из-за этого фразу Цукерберга «практически бесплатно» следует воспринимать не как заявление о снижении стоимости токенов, а как показатель того, что разработчики, по мнению Meta, могут сделать с помощью этих токенов.
Artificial Analysis приводит доказательства в пользу этого аргумента, но указывает и на сложность. Сервис оценивает скорость Muse Spark 1.3 xhigh в 235,2 выходных токена в секунду и определяет примерную стоимость одной задачи по Индексу интеллекта в $0,55.
При показателе Индекса интеллекта на уровне 61 балла это обеспечивает ей самую низкую стоимость одной задачи среди всех протестированных на данный момент моделей с сопоставимым уровнем интеллекта.
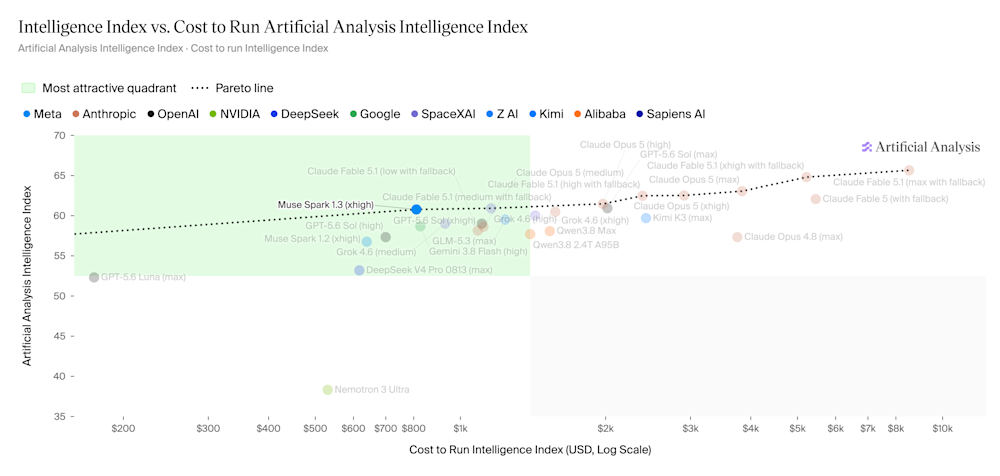
Индекс интеллекта против стоимости выполнения по версии Artificial Analysis (3 сен. – 26). Источник: Artificial Analysis
Muse Spark 1.2 обходилась всего в $0,40 за задачу по версии Artificial Analysis при оценке 57 баллов.
Несмотря на неизменность цен за токен, расчетная стоимость выполнения стандартной задачи по версии независимого бенчмарка в новом поколении моделей выросла. Artificial Analysis связывает этот рост в первую очередь с повышенным потреблением входных токенов при оценке агентских возможностей.
Это напрямую не опровергает заявление Meta о сокращении использования токенов на 25%: Meta описывает сравнения в рамках собственных рабочих процессов написания задач по программированию, в то время как Artificial Analysis оценивает более широкий набор задач на рассуждение и агентское поведение.
Тем не менее, это наглядно демонстрирует, почему понятие «дешево» становится размытым, когда модели начинают действовать как автономные агенты. Стоимость токенов, глубина рассуждений, количество шагов, вызовы инструментов и повторные попытки — все это влияет на итоговую стоимость выполнения работы.
Meta также сохраняет свой необычайно дешевый уровень Contributor — $0,10 за миллион входных токенов и $0,20 за миллион выходных токенов — в обмен на разрешение использовать промпты и ответы для обучения моделей.
Как отмечало издание VentureBeat в случае с Muse Spark 1.2, это может быть привлекательно для создания прототипов, однако существенно меняет требования к управлению данными для предприятий, работающих с проприетарным кодом или конфиденциальной внутренней информацией.
Заявление Ванга «Gemini, кто?» приводит к неожиданно близкому сравнению
Главный директор по искусственному интеллекту Meta Александр Ванг (Alexandr Wang) отреагировал на релиз гораздо более эмоционально.
После того как Artificial Analysis опубликовала результаты Muse Spark, Ванг репостил их на X со словами: «мне очень жаль это говорить, но… gemini кто? 😱💨»
Этот выпад выглядел особенно едко, поскольку Google выпустила Gemini 3.8 Flash в тот же день, позиционируя ее для абсолютно того же класса рабочей нагрузки: долгосрочной разработки программного обеспечения, автономных агентов и многоэтапных профессиональных рассуждений. В Google называют 3.8 своей лучшей моделью Flash для рассуждений и написания кода на сегодняшний день и отмечают, что это уже третий релиз линейки Flash за последние шесть недель.
Независимые показатели дают Вангу почву для подобных заявлений, хотя и не обеспечивают безоговорочной победы.
Artificial Analysis присуждает Muse Spark 1.3 xhigh 61 балл в Индексе интеллекта при стоимости $0,55 за задачу, по сравнению с 59 баллами и $0,58 для Gemini 3.8 Flash в режиме высокого уровня рассуждений. Таким образом, при данных настройках Meta незначительно опережает Google как по уровню интеллекта, так и по стоимости задачи.
Google решительно побеждает по пропускной способности. Artificial Analysis оценивает Gemini 3.8 Flash в высоком режиме примерно в 305 выходных токенов в секунду против 235 у Muse Spark, что примерно на 30% быстрее. Кроме того, у Gemini пока ниже базовая цена в API: Google устанавливает вводную цену на уровне $0,75 за миллион входных токенов и $3,75 за миллион выходных токенов по сравнению с $1,25 и $4,25 у Meta.
Эта промо-акция Google истекает 31 декабря, после чего стоимость вырастет до $1,50 за миллион входных токенов и $7,50 за миллион выходных токенов.
Результат демонстрирует, насколько жесткой стала экономика передовых моделей. На данный момент Meta выигрывает это независимое сравнение с отрывом в два балла Индекса интеллекта и три цента за задачу из бенчмарка; Google же предлагает существенно более высокую скорость генерации и более дешевые «сырые» токены в рамках маркетинговой акции.
Шпилька Ванга «gemini who?» — это забавный выпад топ-менеджеров. Для корпоративного архитектора ситуация выглядит иначе: Gemini работает быстрее, в то время как Muse на данный момент является чуть более сильным агентом с высоким уровнем затрат ресурсов по версии этого независимого замера.
Эволюция позиции Meta в отношении открытых весов
Для некоторых разработчиков более важный вопрос может иметь мало общего с сегодняшней гонкой бенчмарков.
Когда Meta выпустила Muse Code и Muse Spark 1.2 в августе, VentureBeat обратил внимание на то, насколько кардинально компания отошла от стратегии открытых весов (open-weight), которая сделала Llama повсеместно популярной.
Muse Code и Spark 1.2 представляли собой проприетарные продукты, доступные через API, что выглядело поразительно для компании, которая годами доказывала, что открытый ИИ — это единственный путь вперед.
Пять дней спустя Meta снова изменила курс.
10 августа компания выпустила модель Muse Glimmer с 30 миллиардами параметров под лицензией Apache 2.0. Цукерберг также заявил: «В ближайшие недели мы также откроем веса для Muse Spark 1.2». Отдельно агентство Reuters сообщало о планах Meta выпустить веса Spark 1.2.
Теперь же Meta вместо этого выпустила Muse Spark 1.3 в качестве еще одной проприетарной модели.
Пока это еще нельзя назвать нарушением обещания — период «вполне возможно, займет недели» может длиться дольше трех недель. Однако сегодняшнее заявление делает дорожную карту скорее более запутанной, чем прежде.
В новой публикации Meta больше не упоминается Muse Spark 1.2. В ней говорится, что дорожная карта включает «релиз открытых весов Muse Spark» без указания конкретной версии, даты релиза, размера модели или лицензии. Цукерберг также заявил на X, что «релизы открытых весов Muse Spark» появятся в ближайшее время.
Для команд, которые стандартизировали свои процессы вокруг Llama именно потому, что загружаемые веса означали возможность самостоятельного хостинга, кастомизации и контроля над экономикой инференса, эта неопределенность может иметь гораздо большее значение, чем то, набрала ли Spark еще один балл в составном бенчмарке.
Muse Spark 1.3 доказывает, что Meta способна итерировать проприетарные передовые модели с невероятной скоростью. Поставляемая конфигурация xhigh работает быстро, стоит конкурентоспособных денег и находится гораздо ближе к вершине независимых рейтингов, чем ее предшественницы. Превью версии max демонстрирует, что Meta способна продвинуть семейство еще дальше, если получит возможность расходовать больше вычислительных ресурсов на рассуждения.
Следующая проверка будет иной: сможет ли Meta трансформировать этот темп в дорожную карту, на которую предприятия смогут реально ориентироваться, включая предоставление широкого доступа к своим лучшим возможностям и выпуск обещанной модели Spark с открытыми весами.