


Meta возвращается к открытому исходному коду с Muse Glimmer — большой языковой моделью на 30 млрд параметров с лицензией Apache 2.0, доступной уже сегодня
Источник: VentureBeat · Carl Franzen


Компания Meta сегодня выпустила Muse Glimmer — открытую модель с 30 миллиардами параметров, созданную для запуска автономных ИИ-агентов прямо на потребительском «железе». Это позволяет перенести агентские рабочие нагрузки, которые обычно зависят от облачной инфраструктуры, на мощные компьютеры Mac и PC.
Пожалуй, столь же примечательна, как и возможности модели, ее лицензия. Glimmer поставляется под мягкой, стандартной для индустрии открытой лицензией Apache 2.0 — это первый полностью открытый релиз компании с тех пор, как в апреле она выпустила проприетарную модель Muse Spark, пришедшую на смену семейству Llama с открытыми весами.
Фактически, Muse Glimmer выходит сегодня с более мягкой лицензией, чем когда-либо имела Llama. Специальная лицензия сообщества Llama годами подвергалась критике за ограничения, вроде порога в 700 миллионов активных пользователей в месяц; у Apache 2.0 таких условий нет, она разрешает бескоммерческое и коммерческое использование, модификацию и распространение.
Веса уже <доступны на Hugging Face>. Ван заявил, что на этой неделе внедряется поддержка через Ollama, LM Studio, vLLM, SGLang, Together AI, Fireworks AI и OpenRouter, а оптимизированные интеграции с llama.cpp, MLX и ExecuTorch появятся в ближайшие дни; в блоге Meta также упоминается Unsloth как партнер по локальному рантайму, а для тонкой настройки (fine-tuning) указан TorchTitan от PyTorch. Компания сообщает, что работает с AMD, Arm, Dell, Intel и Nvidia над оптимизацией производительности на различных устройствах, а также опубликовала документацию для разработчиков, охватывающую кастомные каркасы (scaffolds) агентов.
«Сегодня мы также открываем веса для Muse Glimmer — отличной плотной модели с 30 миллиардами параметров, которая может работать локально», — написал соучредитель и генеральный директор Meta Марк Цукерберг в посте на X (под своим давним ником @finkd). «Скоро мы также выпустим веса для Muse Spark 1.2, нашей новейшей базовой модели. Meta является решительным сторонником открытого исходного кода, и я горжусь этими релизами».
Обещанный релиз Muse Spark 1.2 станет еще более масштабным сдвигом: это пограничная (frontier) модель, лежащая в основе Muse Code — терминального агента для написания кода, которого Meta выпустила всего пять дней назад, в то время как до сегодняшнего дня все семейство Muse было проприетарным. Цукерберг намекал во время того анонса, что ему «скоро будет чем поделиться» об открытом исходном коде. Теперь мы знаем, что он имел в виду.
Для разработчиков и предприятий практические ставки локального инференса выходят за рамки того, где именно происходят вычисления. Агент, работающий с файлами, скриншотами, средами разработки и другим конфиденциальным контекстом, может выполнять эти рабочие процессы без постоянной отправки информации в удаленный сервис инференса. Локальное развертывание также исключает доступность сети и плату за API на каждый токен из цикла инференса — хотя организации все равно несут расходы на оборудование, электроэнергию, развертывание и управление.
Модель с 30B параметрами, построенная вокруг агентского цикла
Вместо того чтобы позиционировать Glimmer в первую очередь как обычного чат-бота, Meta обучила ее на основе последовательности операций, выполняемых автономным агентом: составление плана, вызов инструментов, интерпретация результатов, продолжение работы и восстановление при возникновении сбоев.
«Точно так же, как и гораздо более крупные модели, Muse Glimmer может работать в качестве полноценного агента посредством планирования, вызова инструментов, проверки собственных результатов и восстановления после сбоев», — написал Александр Ван, директор по искусственному интеллекту Meta, в треде на X, анонсируя релиз, и добавил, что модель «может работать на 24 ГБ видеопамяти (VRAM) без потери агентской надежности».
Согласно карточке модели на Hugging Face, Glimmer представляет собой плотный причинный трансформер (dense causal transformer) с общим числом параметров около 29,6 миллиардов, распределенных по 52 слоям, включая выделенный энкодер восприятия ViT-G/14 примерно на 1,8 млрд параметров. Она принимает чередующиеся текст и изображения, генерирует текст, поддерживает более 100 языков и имеет заявленную длину контекста в 131 072 токена или более с отсечкой знаний по 4 января 2026 года.
Эта комбинация призвана позволить агенту интерпретировать скриншоты, графики и документы, одновременно рассуждая о тексте и вызывая внешние инструменты. Glimmer предлагает настройки рассуждения (reasoning) low, medium, high и xhigh, задаваемые через системный промпт, так что приложения могут повышать или понижать интенсивность рассуждений для каждой конкретной задачи. Meta заявляет, что модель работает на базе различных агентских каркасов, включая OpenClaw и Hermes Agent.
Модель является дистилляцией более крупного флагмана Meta: согласно техническому блогу компании, Glimmer была предварительно обучена на выходных данных Muse Spark с использованием дистилляции логитов, прошла промежуточное обучение на данных с более длинным контекстом и упором на агентов с более богатыми цепочками рассуждений, а затем дообучена с помощью контролируемой тонкой настройки (SFT), он-лайн дистилляции (on-policy distillation) и обучения с подкреплением в общих, рассужденческих, кодинговых и агентских доменах.
Meta продемонстрировала результат на примере локального рабочего процесса Home Assistant: в демонстрационном видео Glimmer автономно обнаруживает экземпляр Home Assistant в сети с помощью вызовов инструментов, запрашивает API устройств, пишет адаптивную HTML/CSS/JavaScript панель управления с нуля и развертывает локальный сервер для проверки собственной работы. Это ближе к операционной реальности развертывания корпоративных агентов, чем автономный бенчмарк вопрос-ответ — модель должна поддерживать план при взаимодействии с внешними системами, а затем проверять, привели ли ее действия к ожидаемому результату.
Сжатие агента до 24 ГБ
Вопрос оборудования имеет центральное значение для этого релиза.
По словам Meta, при полной точности модель с 30B параметров требует более 55 ГБ памяти, что выходит за рамки возможностей любого отдельного потребительского графического процессора (GPU).
Поэтому компания разработала примерно 4-битные квантованные версии, которые уменьшают веса языковой модели до менее чем 20 ГБ, оставляя запас для компонентов, которые операционному агенту также необходимы в памяти: KV-кэша, энкодера восприятия и сопутствующей модели спекулятивного декодирования (speculative-decoding model), и все это помещается в рамки 24 ГБ или 32 ГБ.
В практическом выражении это означает, что квантованные сборки работают на потребительских компьютерах, хотя и на их верхнем ценовом сегменте. Конфигурация K-Quant-17GB, ориентированная на 24 ГБ, помещается на одну высокопроизводительную потребительскую видеокарту, такую как Nvidia RTX 3090 или RTX 4090 (обе с 24 ГБ VRAM), в то время как версия K-Quant-Dynamic, ориентированная на 32 ГБ, соответствует 32 ГБ новой RTX 5090. Что касается Mac, то унифицированная память Apple Silicon выполняет роль видеопамяти, поэтому MacBook Pro или Mac Studio с 32 ГБ памяти и более могут вместить весь стек — Meta провела собственные тесты скорости на MacBook Pro с M4 Max и M5 Max. Однако типичный ноутбук с 8 ГБ или 16 ГБ памяти остается недосягаемым, а релиз в полноразрядной точности BF16, который Meta оценивает в 64 ГБ, остается вотчиной дата-центровских GPU и топовых конфигураций Mac Studio.
Meta сообщает о среднем снижении точности всего на 0,2% по 15 бенчмаркам для своей версии K-Quant-Dynamic, ориентированной на оборудование с 32 ГБ, и на 1% для конфигурации K-Quant-17GB, ориентированной на 24 ГБ. Эти цифры являются собственными измерениями Meta, а не независимыми оценками.
Meta также использует спекулятивное декодирование DFlash для борьбы с другой большой проблемой локальных агентов — задержкой (latency). Вместо того чтобы генерировать каждый токен последовательно, меньшая модель-«драфтер» DFlash предлагает блоки по 16 токенов, которые основная модель проверяет параллельно, выдавая идентичный результат быстрее.
Meta сообщает, что это повышает среднюю скорость генерации на Nvidia RTX 5090 с 74,9 токенов в секунду до 233,4 — увеличение в 3,1 раза. На Apple M5 Max скорость возрастает с 26,6 до 50,2 токенов в секунду (в 1,8 раза), а на M4 Max — с 23,7 до 37,8 (в 1,5 раза). В тестах использовался размер батча (batch size) равный единице и жадное декодирование (greedy decoding), причем системы Apple измерялись через ExecuTorch, а RTX 5090 — через llama.cpp.
Для агентских приложений эти мультипликаторы имеют гораздо большее значение, чем для простого чата: один запрос пользователя может вызывать множество обращений к модели, вызовов инструментов и этапов верификации, а задержка, накапливающаяся на каждом этапе, может быстро сделать в остальном способного агента непрактичным.
Glimmer выходит на все более конкурентный рынок локальных моделей
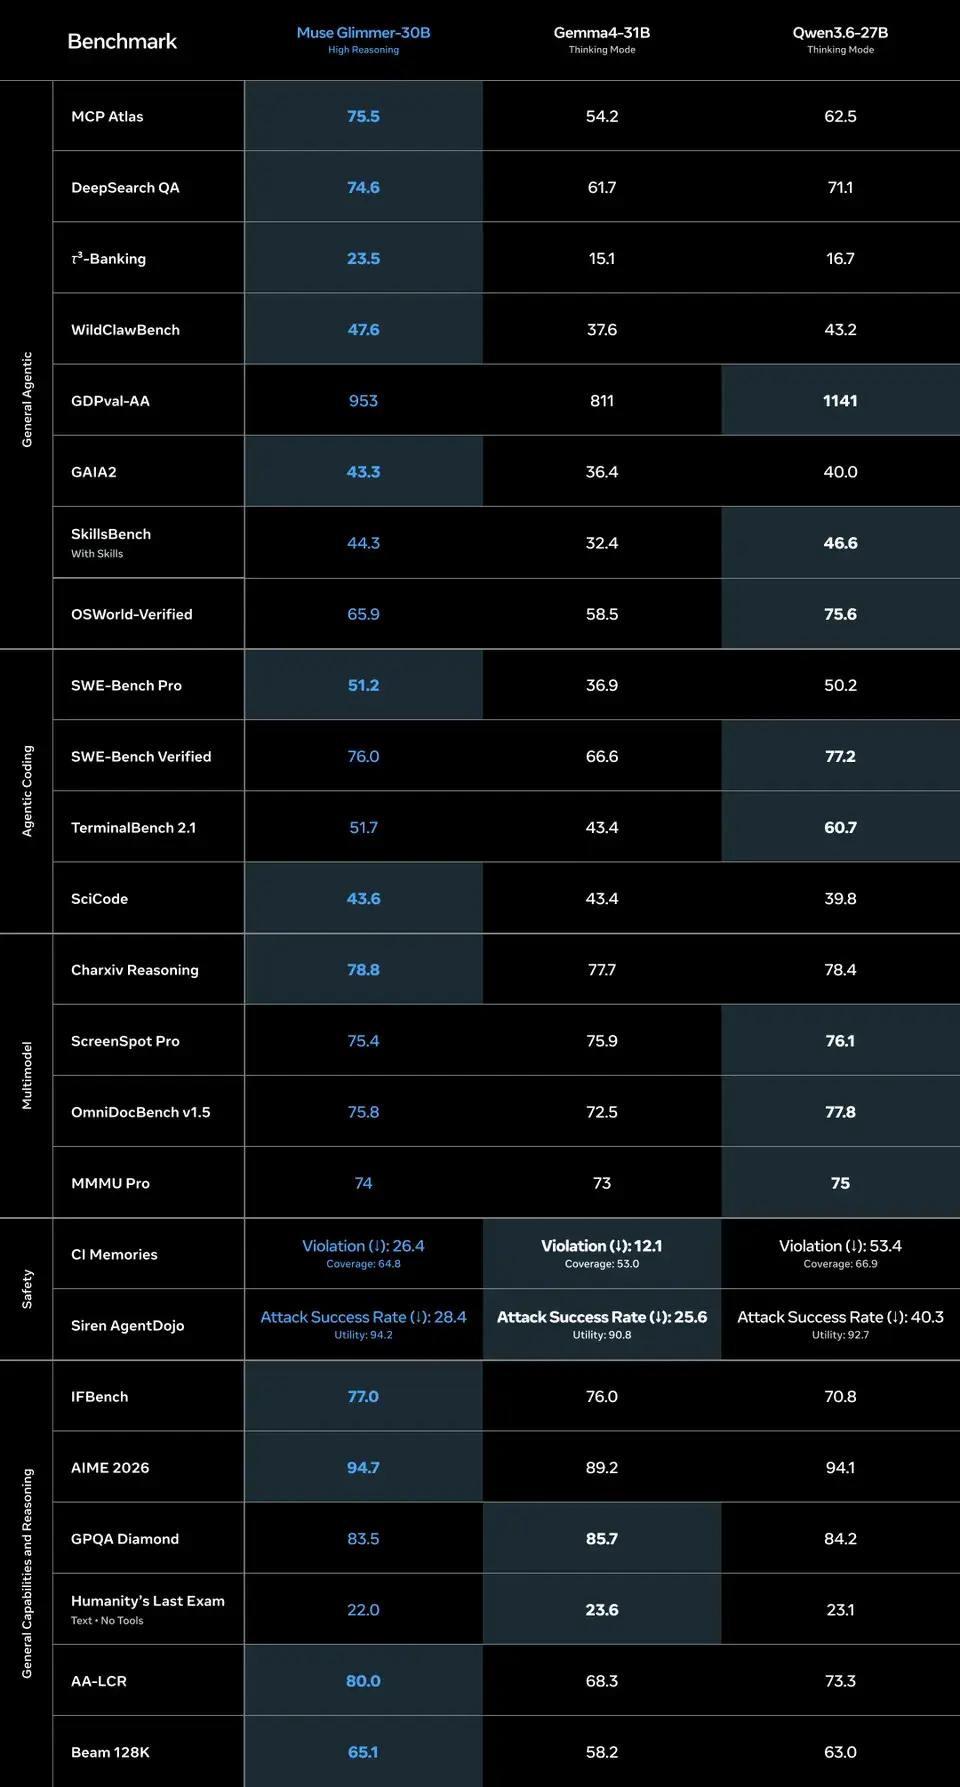
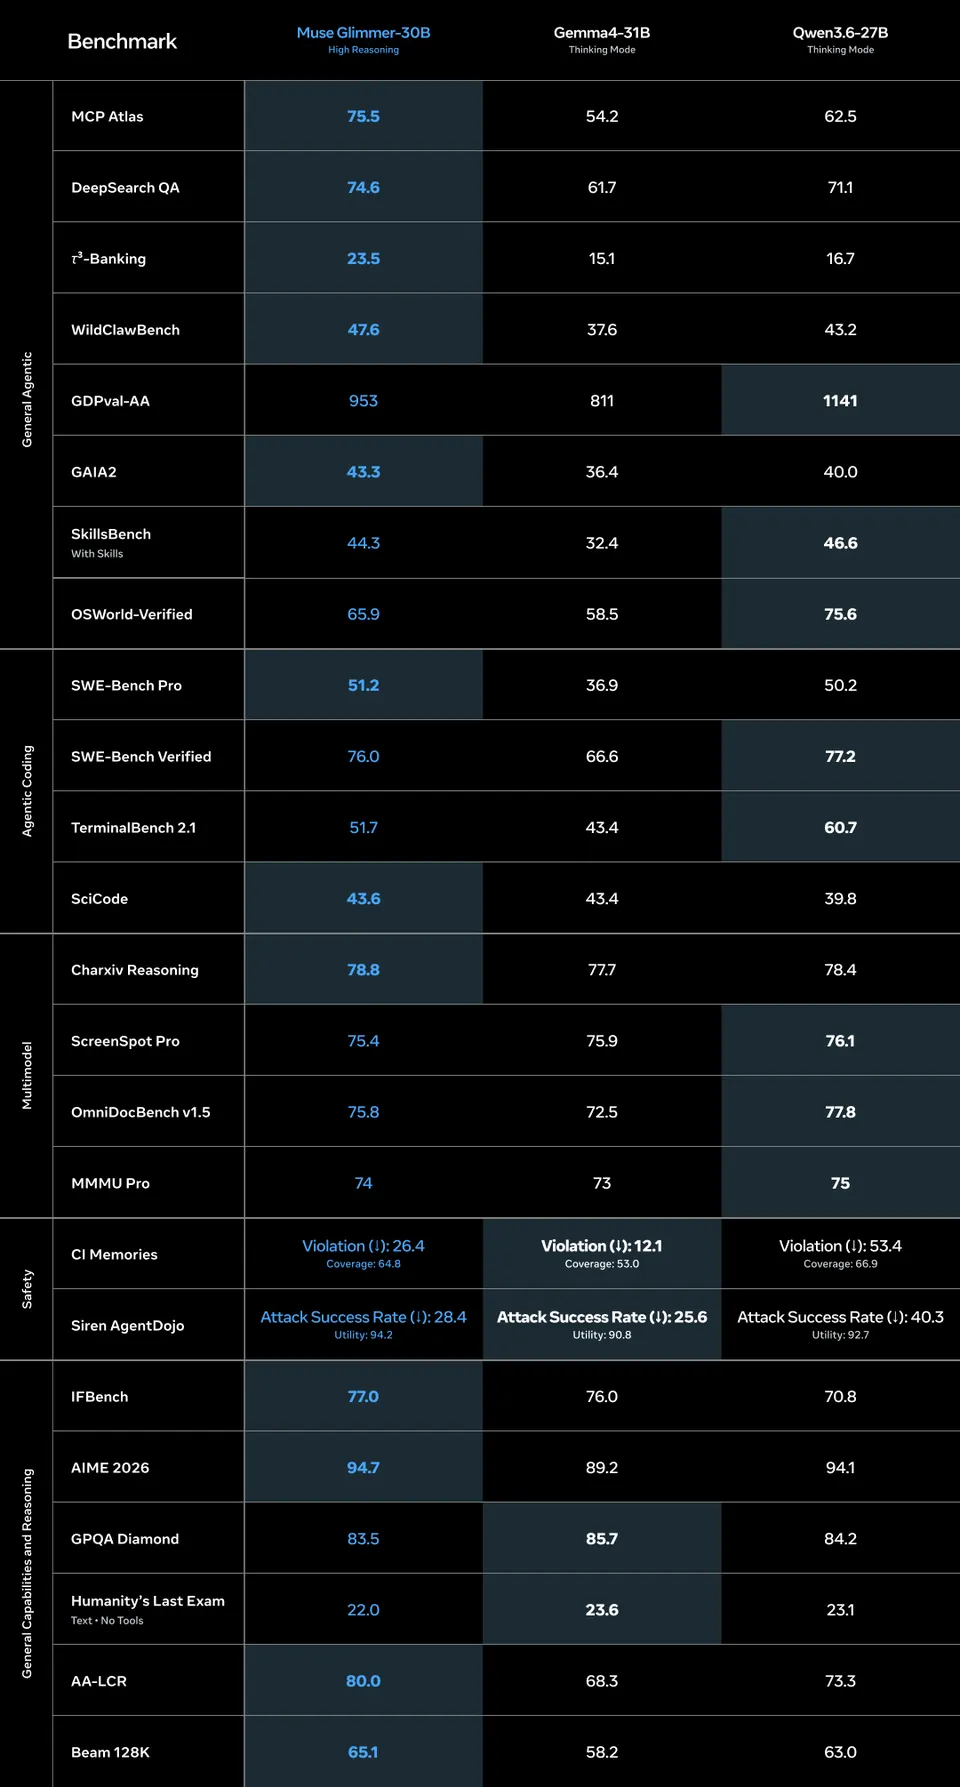
Meta выходит не на пустое поле. У разработчиков уже есть способные модели с открытыми весами в этом классе размеров, наиболее заметными из которых являются семейство Gemma 4 от Google и Qwen3.6-27B от Alibaba — обе позиционируют себя вокруг рассуждений, мультимодального понимания и агентских рабочих нагрузок. Собственная таблица бенчмарков Meta напрямую сравнивает их.
Сравнительная таблица бенчмарков Muse Glimmer. Источник: Meta
Glimmer лидирует в этом трехстороннем сравнении в ряде агентских тестов, включая MCP Atlas с 75,5, DeepSearch QA с 74,6, τ³-Banking с 23,5, WildClawBench с 47,6 и GAIA2 с 43.3. Она набирает 51,2 балла в SWE-Bench Pro против 36,9 у Gemma4-31B и 50,2 у Qwen3.6-27B по оценке Meta.
Но Glimmer не доминирует во всех категориях. Qwen лидирует в собственном сравнении Meta по ОС World-Verified (75.6 против 65.9 у Glimmer), TerminalBench 2.1 (60.7 против 51.7), SkillsBench, GDPval-AA (1141 против 953) и в большинстве мультимодальных бенчмарков. В SWE-Bench Verified показатель Glimmer (76.0) оказывается чуть ниже результата Qwen (77.2). Gemma лидирует в тетах GPQA Diamond и Humanity’s Last Exam.
Если смотреть на вещи трезво, эти цифры делают Glimmer более интересной в качестве специализированной локальной модели-агента, чем в качестве доказательства универсального превосходства в производительности. Для корпоративных разработчиков практический вопрос заключается в том, переносится ли ее комбинация надежности агента, качества квантования, совместимости с инструментами и скорости декодирования из бенчмарков в непрерывные рабочие процессы реального мира.
|
Модель |
Разработчик / происхождение |
Оценка AA |
Параметры / контекст |
Самая низкая отслеживаемая цена API |
Доступ |
Лицензия |
Наиболее сильные варианты использования |
|
Moonshot AI; Китай |
60 |
2,8 трлн всего / 104 млрд активных; 1M |
$3,00 ввод / $15,00 вывод через Kimi, Fireworks или Modal (цены) |
Пользовательская лицензия Kimi K3. Крупным операторам «модель-как-услуга» с выручкой более $20 млн за 12 месяцев требуется отдельное соглашение Крупным продуктам может потребоваться указывать «Kimi K3». |
Передовое долгосрочное программирование Мультимодальные исследования и сложные агенты на основе инструментов |
||
|
Z.ai / Zhipu AI; Китай |
53 |
753 млрд / 40 млрд активных; 1M |
$0,75 / $2,40 через DeepInfra FP4 (цены) |
MIT |
Долгосрочное программирование и агенты Анализ миллиона токенов с настраиваемыми рассуждениями |
||
|
DeepSeek; Китай |
52 |
284 млрд / 13 млрд активных; 1M |
$0,09 / $0,18 через DeepInfra (цены) |
MIT |
• Чрезвычайно экономичные рассуждения• Агенты для кодинга, терминальная работа и использование инструментов |
||
|
MiniMax; Китай |
45 |
428 млрд / 23 млрд активных; 1M |
$0,23 / $0,96 через CoreWeave (цены) |
; |
Лицензия MiniMax Community. Требуется коммерческое указание авторства; компаниям с годовой выручкой более $20 млн требуется авторизация. Включает условия запрещенного использования. |
• Нативная работа с текстом, изображениями и видео• Длинноконтекстный кодинг и агенты-«соработники» |
|
|
Xiaomi; Китай |
43 |
1,02 трлн / 42 млрд активных; 1M |
$0,35 / $0,70 через GMI (цены) |
MIT |
Сложная разработка программного обеспечения Агенты, охватывающие тысячи вызовов инструментов |
||
|
Thinking Machines Lab; США |
42 |
975 млрд / 41 млрд активных; 1M в весах |
$0,95 / $4,05 через DeepInfra FP8 (цены) |
Apache 2.0 |
Настраиваемый фундамент для текста, изображений и аудио Тонко настроенные системы кодинга, RAG и использования инструментов |
||
|
NVIDIA; США |
38 |
550 млрд / 55 млрд активных; до 1M в весах |
$0,37 / $1,08 через Blackbox AI (цены) |
OpenMDW-1.1; мягкие коммерческие права и права на производные модели |
Сложные агенты и рассуждения на основе длинного контекста Высокоточный RAG, код, математика и наука |
||
|
Mistral AI; Франция |
30 |
128B плотная; 256K |
$1,50 / $7,50 через Mistral (цены) |
Модифицированная MIT. Компании с консолидированной ежемесячной выручкой более $20 млн должны получить коммерческую лицензию или использовать сервис Mistral. |
Агенты для кодинга и вызов функций Мультимодальное следование инструкциям |
||
|
Google DeepMind; США |
30 |
30.7B плотная; 256K |
Бесплатно на ограниченном уровне Google AI Studio; платный низкий тариф $0,10 / $0,34 через CoreWeave (цены) |
Apache 2.0 |
Компактные мультимодальные рассуждения и кодинг Управляемые локальные или частные серверные развертывания |
||
|
OpenAI; США |
24 |
117 млрд / 5,1 млрд активных; 131K |
$0,03 / $0,17 через CoreWeave (цены) |
Многочисленные сторонние API |
Apache 2.0 |
Рассуждения структурированный вывод и инструменты Тонкая настройка и развертывание на одном 80GB GPU |
|
|
Cohere; Канада |
23 |
218 млрд / 25 млрд активных; 128K вход |
Бесплатно на текущей отслеживаемой конечной точке Cohere (цены) |
Apache 2.0 |
Корпоративный RAG и обоснованные цитаты • Многоязычные агенты и обработка документов |
||
|
Meta; США |
Пока не оценен |
29,6B плотная, включая визуальный энкодер; 131K+ |
В день запуска публичной фиксированной цены хостинга обнаружено не было |
Apache 2.0 для полноразрядных весов, квантований, драфтера и энкодера восприятия |
9 Постоянно работающие локальные агенты на системах с 24–32 ГБ Использование инструментов, восстановление, кодинг и понимание экранов/документов |
Meta Glimmer пополняет все еще небольшой список по-настоящему открытых моделей пограничного класса от американских компаний.
Последние два года темпы в сфере ИИ с открытым исходным кодом задавали китайские компании: DeepSeek, команда Qwen от Alibaba, Kimi от Moonshot AI, GLM от Zhipu и MiniMax выпускали открытые модели пограничного класса по лицензиям MIT и Apache 2.0 с темпом, за которым западные лаборатории не поспевали.
Данные об использовании это отражают: к маю 2026 года на долю китайских моделей с открытыми весами приходилось около 61% всех токенов, потребляемых на OpenRouter, причем четыре из пяти наиболее используемых моделей были созданы китайскими лабораториями, в то время как Llama от Meta, прежний лидер среди открытых весов, вообще выбыла из рейтингов.
Американские контрпримеры до сих пор можно пересчитать по пальцам одной руки: gpt-oss-120b и gpt-oss-20b от OpenAI, выпущенные под лицензией Apache 2.0 в августе 2025 года в качестве первых открытых весов компании со времен GPT-2; семейство Gemma от Google, которое имеет открытые веса, но поставляется по собственной более ограничительной пользовательской лицензии Google вместо одобренной OSI; и Inkling от Thinking Machines.
Glimmer вызывает наиболее прямые ассоциации с gpt-oss: обе используют Apache 2.0, обе предлагают настраиваемую интенсивность рассуждений и обе ориентированы на самостоятельное развертывание (self-hosted).
Но модели gpt-oss — это текстовые разреженные архитектуры типа «смесь экспертов» (Mixture-of-Experts), созданные в первую очередь для рассуждений и использования инструментов: gpt-oss-20b помещается примерно в 16 ГБ памяти, в то время как gpt-oss-120b ориентирована на один GPU дата-центра с 80 ГБ.
Glimmer занимает иную нишу: это плотная модель с нативным входом для изображений, обученная от начала до конца вокруг агентского цикла, поставляемая с собственными квантованными вариантами и драфтером спекулятивного декодирования, настроенными под потребительские машины с 24 ГБ памяти.
И если Цукерберг выполнит свое обещание и откроет веса Muse Spark 1.2, Meta выведет в открытый доступ настоящий американский флагманский пограничный язык — то, чего еще не делала ни одна американская лаборатория в этом тире.
Безопасность остается частью архитектуры развертывания
Предоставление локальной модели доступа к инструментам создает иную проблему безопасности по сравнению с развертыванием локального чат-бота, и собственные показатели безопасности Meta показывают, что Glimmer не во всем превосходит своих конкурентов.
В CI Memories, бенчмарке конфиденциальности, где меньшее количество нарушений лучше, Glimmer фиксирует 26,4 против 12,1 у Gemma и 53,4 у Qwen. В Siren AgentDojo, тесте на инъекции промптов (prompt-injection), Glimmer демонстрирует 28,4% успешных атак против 25,6% у Gemma и 40,3% у Qwen, при этом показывая самый высокий показатель полезности (utility) среди трех моделей — 94,2.
Meta заявляет, что оценила Glimmer в рамках своей модели масштабирования передового ИИ (Advanced AI Scaling Framework) и определила, что модель не подпадает под определение «пограничного ИИ» (Frontier AI), поскольку она в целом менее способна, чем Muse Spark. Ее Команда готовности (Preparedness Team) оценила Glimmer как умеренно рискованную или ниже в категориях химической/биологической безопасности, кибербезопасности и потери контроля — причем последние две категории выведены из того факта, что Glimmer в целом слабее Muse Spark 1.0, получившей те же обозначения.
Тем не менее компания рекомендует развертывать Glimmer как часть более широкой системы с защитными механизмами (guardrails), включая подтверждение человеком (human-in-the-loop) для необратимых действий. Эта оговорка имеет особое значение для локальных агентов: хранение данных на устройстве снижает риски утечек в облачную инфраструктуру, но локальное выполнение само по себе не решает проблемы инъекций промптов, избыточных разрешений или совершения агентом непреднамеренных действий.
Веса Apache 2.0 и быстро растущая экосистема рантаймов
Meta выпускает полноразрядные веса BF16, оба 4-битных квантованных варианта, драфтер DFlash и энкодер восприятия — и все это под лицензией Apache 2.0. К загружаемой модели не прилагается никакой фиксированной цены Meta API, поэтому общая стоимость зависит от локального оборудования или выбранного разработчиками стороннего хостинга. Один нюанс, который стоит отметить для отделов закупок: как и в случае с большинством релизов «открытых» моделей, открытыми являются именно веса — Meta не выпускала обучающие данные или код обучения.
Более широкий подтекст заключается в том, что Meta рассматривает рабочую станцию разработчика как надежную цель для развертывания автономных агентов, а не просто как площадку для экспериментов с меньшими языковыми моделями. Размер Glimmer в 30B и целевой показатель в 24 ГБ делают эту задачу вполне достижимой на высокопроизводительном потребительском «железе», в то время как лицензия Apache 2.0 дает разработчикам (и их юридическим отделам) необычную свободу в модификации и развертывании.
Следующая проверка покажет, выдержат ли ее преимущества в бенчмарках в более хаотичных условиях реальных репозиториев кода, корпоративных инструментов и долгоиграющих сеансов агентов. Если да, то самым важным аспектом Glimmer может стать вовсе не очередной набор баллов в тестах — а то, что класс агентов, от которых раньше ждали работы исключительно за облачным API, теперь все больше может жить и работать на компьютере, стоящем под столом у разработчика.




