


Meta устанавливает цену на Muse Voice Transcribe в размере $0,18 в час с диаризацией в реальном времени для более чем 20 спикеров: находка для бизнеса?
Источник: VentureBeat · Carl Franzen


Meta выходит на все более конкурентный рынок потокового распознавания речи с Muse Voice Transcribe — новой моделью восприятия аудио, которая объединяет потоковую транскрипцию, обнаружение конечных точек и диаризацию спикеров для более чем 20 участников, по публичной цене API всего $0,18 за час обработанного аудио.
Разработанная в Meta Superintelligence Labs, Muse создана для обработки речи в реальном времени, а не ожидания окончания записи. В публикации Meta о запуске Muse Voice Transcribe отмечается, что модель поддерживает длинные аудиозаписи продолжительностью более часа, плавное многоязычное переключение кодов, настройку под определенные языки и ключевые слова, а также диаризацию без отдельного конвейера постобработки. Модель обучалась на более чем 70 языках, причем для первоначального релиза 25 языков прошли тщательную проверку.
Цифра в более чем 20 спикеров внушительна, но это не мировой рекорд. Обзор текущей документации вендоров показывает системы с более высокими заявленными пределами. Сервис потокового распознавания от Speechmatics заявляет о возможности идентификации 50 спикеров по умолчанию и до 100 при увеличении лимита, в то время как документация по диаризации Amazon Transcribe указывает максимум в 30 уникальных спикеров, в том числе для потоковой транскрипции. (Speechmatics)
Тем не менее, Muse занимает позиции в верхнем сегменте рынка, а более широкое предложение от Meta, пожалуй, важнее самого по себе предельного показателя: высокопроизводительная диаризация в реальном времени в сочетании с низкой задержкой транскрипции, определением конечных точек, многоязычным переключением кодов и агрессивным ценообразованием API в рамках одной модели.
Для корпоративных разработчиков, создающих системы для проведения встреч, аналитики звонков, живых ассистентов или систем фонового ИИ, это сочетание может оказаться важнее того, кто удерживает рекорд по количеству спикеров.
Диаризация становится частью базового голосового стека
Традиционное распознавание речи отвечает на относительно простой вопрос: Что было сказано? Диаризация добавляет еще один: Кто это сказал?
Это различие становится критически важным, когда транскрипты передаются в нисходящие системы ИИ. Ассистент на встрече может безошибочно расшифровать каждое предложение и все равно сформировать ненадежную корпоративную отчетность, если припишет одобрение, обязательство или возражение не тому участнику. Та же проблема затрагивает аналитику клиентского сервиса, рабочие процессы комплаенса и ИИ-агентов, работающих в помещениях, где говорят несколько человек.
Muse встраивает атрибуцию спикеров непосредственно в свою авторегрессионную мультимодальную архитектуру. В Meta заявляют, что аудио поступает 80-миллисекундными фрагментами (или 12,5 фрагментами в секунду), каждый из которых преобразуется в мягкий токен. На каждом шаге модель принимает решение — продолжить потребление аудио или выдать текст. Meta называет этот механизм адаптивной задержкой: вместо применения единого бюджета задержки к каждому слову, Muse может подождать дольше, когда речь неоднозначна, и выдать результат раньше, когда контекста достаточно. В Meta отмечают, что обучение с подкреплением сочетает в себе награды за частоту ошибок в словах и задержку для тренировки такого поведения. Техническое описание Muse от Meta подробно раскрывает архитектуру. (Meta AI Research)
Атрибуция спикеров и определение конечных точек тем самым становятся частью одной последовательности токенов. Токен <|start_of_turn|> обозначает потенциальную смену говорящего, такие токены, как <|speaker_A|>, идентифицируют спикера, а отдельные токены начала и окончания определяют границы речи. В Meta подчеркивают, что обучают ASR, диаризацию и определение конечных точек совместно, а не используют кластеризацию спикеров в качестве отдельного независимого процесса на последующих этапах.
Кроме того, документация по API моделей распознавания речи Meta представляет диаризацию как первоклассный режим работы наравне с режимами PTT (нажми и говори) и определения конечных точек. Метки спикеров, такие как A и Б, привязаны к сеансу, а не к проверенным личностям, а API предоставляет временные метки на уровне реплик, а не отдельных слов.
Более 20 спикеров — это много, но Speechmatics идет значительно дальше
Сравнения по количеству спикеров требуют осторожности, поскольку вендоры реализуют диаризацию по-разному и не все публикуют максимальные значения.
На данный момент Speechmatics заявляет о самой высокой явной производительности в реальном времени, обнаруженной в данном обзоре. Ее документация по потоковому STT утверждает, что диаризация спикеров доступна в режиме live, в то время как в разделе часто задаваемых вопросов (FAQ) указано, что система поддерживает 50 спикеров по умолчанию с возможностью увеличения до 100.
AWS также превосходит заявленный показатель Meta: Amazon Transcribe может различать максимум 30 уникальных спикеров и предоставляет четкие инструкции по разделению участников при потоковой транскрипции.
Soniox поддерживает диаризацию как в реальном времени, так и при асинхронной обработке, однако документация ограничивает число спикеров до 15 за сеанс. Система потоковой диаризации от AssemblyAI позволяет разработчикам устанавливать max_speakers от одного до 10. Обе компании предупреждают, что определение говорящего на лету дается сложнее, поскольку потоковые системы вынуждены принимать решения, опираясь на меньший объем будущего аудиоконтекста по сравнению с офлайн-моделями.
Текущий API преобразования речи в текст от xAI также поддерживает диаризацию спикеров в потоковом режиме, но изученная для этой статьи документация не указывает максимальное количество диаризуемых спикеров, из-за чего прямое сопоставление предела с Muse невозможно. (Документация X.ai)
Это означает, что называть возможность Muse работать с более чем 20 спикерами новым мировым рекордом было бы неточно. Наибольшее явно задокументированное число участников в реальном времени, выявленное в ходе данного исследования, — это настраиваемый предел Speechmatics в 100 спикеров.
Более того, Meta не демонстрирует одновременное участие более чем 20 человек в своих презентационных материалах. В ее основной живой демонстрации задействовано восемь спикеров, в то время как запись длинного формата содержит 11 размеченных участников. Показатель «более 20» является заявленной возможностью модели, а не числом участников в публичных демо.
При цене $0,18 за час Muse агрессивно конкурирует по стоимости
Ценовая политика Meta делает конкурентную картину еще более интересной.
Согласно странице для разработчиков Muse Voice Transcribe, Muse стоит $3 за 1000 минут, или $0,18 за час. Стоимость потоковой и непотоковой транскрипции одинакова, а обработка без сохранения данных (zero-data-retention), как заявляет Meta, оценивается наравне со стандартной. Оплата взимается за фактически обработанное аудио и округляется в меньшую сторону до целых секунд.
Приведение публично объявленных тарифов к одному часу потокового аудио дает следующее приблизительное сравнение:
Это сравнение неизбежно носит условный характер. Цена Qwen варьируется в зависимости от региона развертывания; ее международный тариф для работы в реальном времени составляет около $0,00009 за секунду, что равняется примерно $0,324 за час. Показатель Google Gemini представляет собой расчетную среднюю стоимость токена, а не фиксированный почасовой тариф. Расценки AWS отличаются в зависимости от региона и уровня использования. ElevenLabs указывает на странице тарифов API $0,39 за час, но рекламирует $0,28 за час или ниже при покупке годовых бизнес-планов.
Цены Deepgram наглядно показывают, почему сравнение на уровне функций имеет значение: текущая ставка потоковой передачи Nova-3 Multilingual составляет около $0,35 за час, однако диаризация спикеров обходится в дополнительные $0,002 за минуту, в результате чего сопоставимая итоговая сумма возрастает примерно до $0,47 за час. AssemblyAI аналогичным образом указывает $0,45 за час для Universal-3.5 Pro Realtime и еще $0,12 за час за потоковую диаризацию.
Расценки Cartesia сложнее привести к единому знаменателю, поскольку Ink-2 распространяется в рамках ежемесячных кредитных планов, а не в виде простого почасового тарифа с оплатой по факту использования (PAYG). Ее тарифный план Pro за $5 включает примерно девять часов и 16 минут транскрипции Ink-2, что составляет около $0,54 за час транскрипции, если каждый кредит расходуется исключительно на STT. Это не следует приравнивать к независимому почасовому API-тарифу в $0,54.
Даже с учетом этих оговорок позиционирование Muse очевидно. Сервис не является самым дешевым из доступных сервисов потоковой транскрипции — Soniox на данный момент публикует более низкую эквивалентную ставку, — но $0,18 за час с уже включенной диаризацией выводят Meta в нижний ценовой сегмент рынка, особенно на фоне провайдеров, взимающих отдельную плату за атрибуцию спикеров.
При объеме обработки в 1000 часов аудио публичный тариф Meta подразумевает расходы на транскрипцию в размере примерно $180.
Meta также лидирует по собственным бенчмаркам точности запуска
Цена имеет меньшее значение, если она сопровождается значительным падением точности. Материалы бенчмарков от Meta утверждают обратное.
В предоставленном к моменту запуска индексе потоковой передачи Artificial Analysis AA-WER Muse демонстрирует итоговую частоту ошибок в словах (WER) на уровне 3,1%, опережая Cartesia Ink-2 с 3.4%, ElevenLabs Scribe v2 Realtime с 3.6%, Qwen3 ASR Flash Realtime с 3.7%, GPT Live Transcribe и Grok Speech to Text Streaming с 3.9%, а также Gemini 3.5 Transcribe Live и AssemblyAI U3.5 Realtime Pro с 4.0%.
Meta подчеркивает, что по состоянию на 1 сентября Muse заняла первое место в оценке потокового распознавания речи независимой сторонней ИИ-бенчмаркинговой компании Artificial Analysis. Meta опубликовала следующие графики бенчмарков в своем посте о запуске.
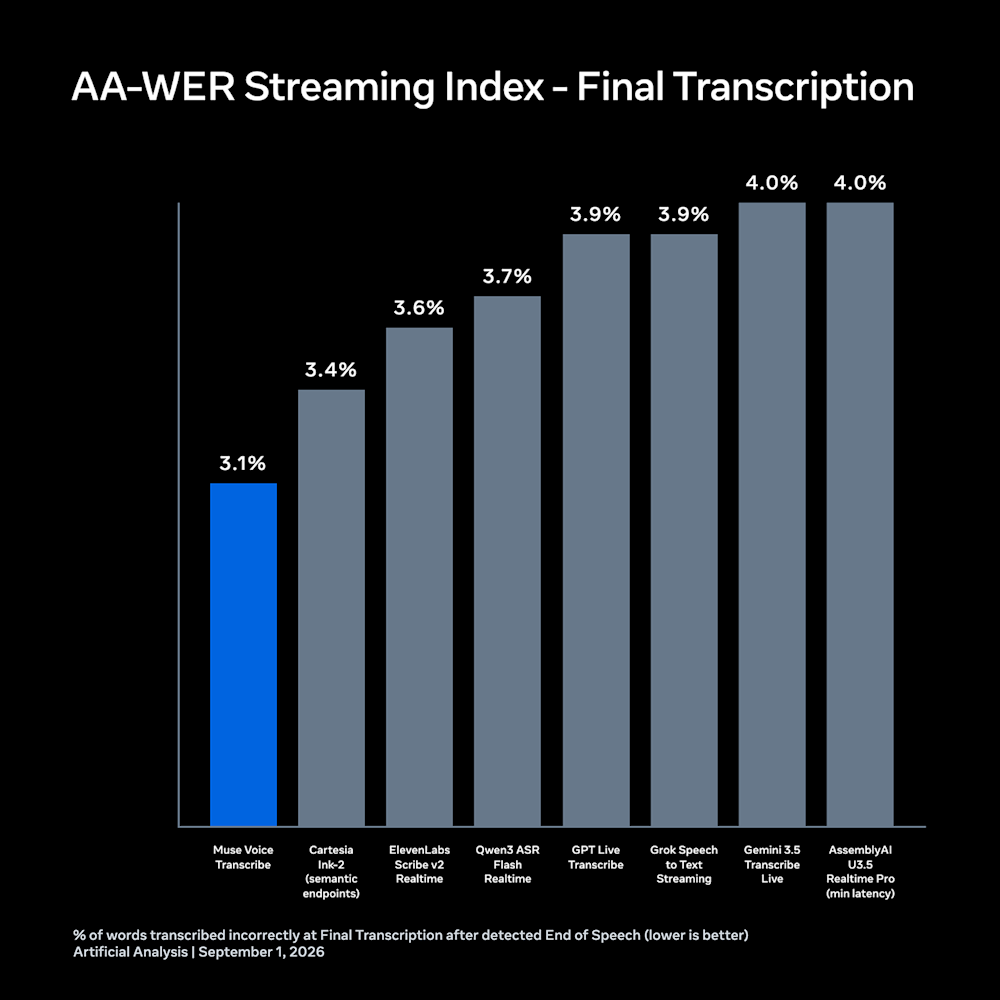
Результаты бенчмарка Muse Voice Transcribe AA-WER. Источник: Meta
Результаты диаризации могут оказаться еще более значимыми для позиционирования продукта. Meta сообщает о среднем показателе ошибок диаризации (DER) в 17,5% на наборах данных AMI-IHM, AMI-SDM и VoxConverse, что ниже показателей конкурирующих систем, представленных на ее графике.
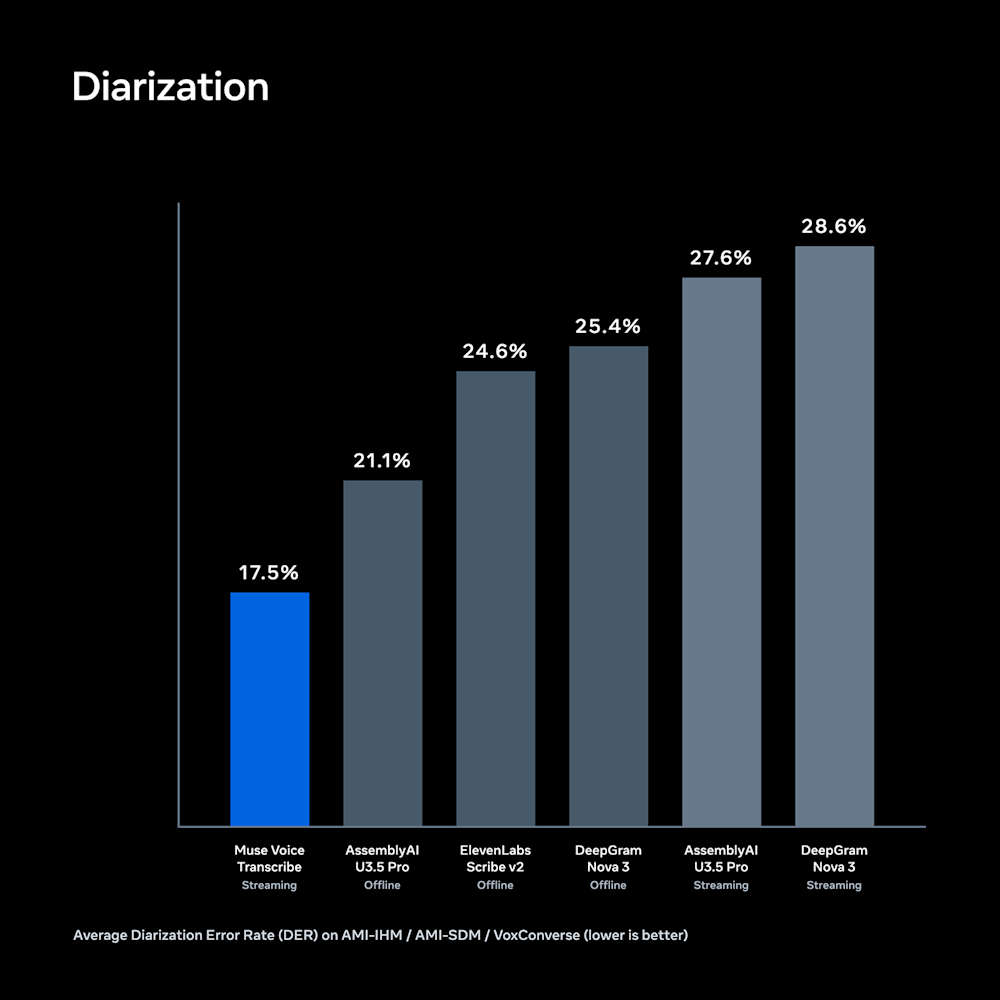
График производительности диаризации Meta Muse Voice Transcribe. Источник: Meta
Не следует ставить знак равенства между емкостью спикеров и частотой ошибок диаризации. Платформа, способная распознать 100 человек, не обязательно справляется с атрибуцией речи лучше, чем та, которая поддерживает 20, к тому же бенчмарк Meta тестирует далеко не каждого конкурента при максимальном заявленном им количестве спикеров.
Существуют и компромиссы в развертывании. API Meta в настоящее время предоставляет временные метки на уровне реплик, но не слов, и не выводит оценки уверенности на уровне слов, а также детекцию звуковых событий или эмоций. Документация также определяет ограничение по умолчанию в восемь одновременных потоков на арендатора и продолжительность сеансов реального времени до 60 минут, после чего приложение должно переподключаться.
Тем не менее, запуск Muse формирует исключительно привлекательное соотношение цены и производительности. Диаризация для более чем 20 спикеров не устанавливает мировой рекорд, но сам рекорд может оказаться второстепенным метрическим показателем. Для корпоративных разработчиков куда более важным вопросом является то, способна ли служба сохранять привязку к спикерам, точный текст и пригодные для использования границы реплик в условиях продолжающегося реального живого разговора.
При цене $0,18 за час, с поддержкой диаризации более 20 спикеров внутри той же модели реального времени, которая в настоящее время лидирует в предоставленных Meta бенчмарках потоковой точности, Muse Voice Transcribe предоставляет корпоративным командам серьезную новую альтернативу для задач аналитики встреч, живой транскрипции и инфраструктуры голосовых агентов — одновременно усиливая давление на конкурентов, которым теперь придется соперничать в точности определения спикеров и совокупной стоимости эксплуатации, а не только в базовом распознавании речи.




