


Знакомьтесь с ZAYA1-8B: сверхэффективной открытой моделью для логического вывода, обученной на графических процессорах AMD Instinct MI300


В то время как ведущие разработчики ИИ, такие как OpenAI и Anthropic, ведут борьбу за вычислительные мощности для обучения и выпуска все более крупных и мощных моделей, другие лаборатории идут по иному пути — занимаются разработкой более компактных, эффективных и зачастую открытых моделей.
Последняя заслуживающая внимания новинка представлена малоизвестным стартапом из Пало-Альто Zyphra, который на этой неделе выпустил свою новую языковую модель с рассуждениями и смесью экспертов (MoE) — ZAYA1-8B. Она насчитывает чуть более 8 миллиардов параметров, из которых активны всего 760 миллионов, что значительно меньше триллионов, оцениваемых у продуктов крупных лабораторий. Тем не менее, ZAYA1-8B сохраняет конкурентоспособность в сторонних бенчмарках по сравнению с GPT-5-High и DeepSeek-V3.2.
Ее уже можно бесплатно скачать на Hugging Face под гибкой, стандартной и дружественной к бизнесу лицензией Apache 2.0. Предприятия и независимые разработчики могут сразу же начать использовать и настраивать ее под свои нужды. Индивидуальные пользователи также могут протестировать модель самостоятельно <абсолютно бесплатно> на платформе Zyphra Cloud, представляющей собой решение стартапа для инференса.
Однако главная сенсация заключается в том, на чем обучалась ZAYA1-8B: на полноценном стеке графических процессоров (GPU) AMD Instinct MI300. Эти ускорители, выпущенные AMD почти три года назад в качестве альтернативы картам Nvidia, доказывают свою способность создавать полезные модели и служат жизнеспособной заменой привилегированному положению, которое Nvidia удерживала среди разработчиков ИИ-моделей в последние годы.
Как обучалась ZAYA1-8B
«Плотность интеллекта», которой гордится Zyphra, стала результатом подхода, описываемого ими как «полностековая инновация», охватывающая архитектуру, предварительное обучение и обучение с подкреплением (RL).
ZAYA1-8B создана на базе фирменной архитектуры MoE++ от Zyphra, описанной в техническом отчете лаборатории. Эта архитектура вводит три фундаментальных изменения в стандартную архитектуру Transformer, которая лежит в основе больших языковых моделей (LLM) и всей эры генеративного ИИ:
-
Сжатое сверточное внимание (Compressed Convolutional Attention, CCA): В отличие от стандартных механизмов внимания, испытывающих трудности с памятью по мере роста контекстных окон, CCA выполняет смешивание последовательностей в сжатом скрытом пространстве. Это приводит к 8-кратному уменьшению размера кэша ключей-значений (KV-cache) по сравнению с полным многоголовым вниманием (multi-head attention), обеспечивая более эффективное рассуждение в условиях длинного контекста.
-
Маршрутизатор ZAYA1 MLP: Большинство MoE-моделей используют линейный маршрутизатор для определения того, какие «эксперты» должны обрабатывать конкретный токен. Zyphra заменила его более выразительной многослойной конструкцией на базе многослойного перцептрона (MLP). Для поддержания стабильности во время обучения — распространенной проблемы для MoE — разработчики внедрили схему балансировки смещения, вдохновленную ПИД-регуляторами из классической теории управления.
-
Изучаемое остаточное масштабирование (Learned Residual Scaling): Это решение контролирует рост «остаточной нормы» по мере углубления данных в 40 слоев модели, предотвращая затухание или взрыв градиентов с пренебрежимо малыми вычислительными затратами.
Предварительное обучение с упором на рассуждения
Важнейшим отличительным признаком ZAYA1-8B является то, что возможности рассуждения были интегрированы с самого начала предварительного обучения, а не «прикручены» на этапе пост-обработки.
Для работы с длинными цепочками рассуждений (Chain-of-Thought, CoT), которые в противном случае превысили бы исходный контекст предварительного обучения в 4K, Zyphra разработала метод обрезки с сохранением ответа (Answer-Preserving, AP Trimming).
Представьте себе AP-обрезку как работу киномонтажера, вырезающего длинную сцену: вместо того чтобы удалять концовку (решение) или целиком отбрасывать сцену, монтажер удаляет «середину» монолога персонажа, сохраняя начало (постановку задачи) и финальную развязку (ответ).
Это гарантирует, что модель усваивает взаимосвязь между сложными проблемами и их решениями даже тогда, когда вся внутренняя логика еще не помещается в память.
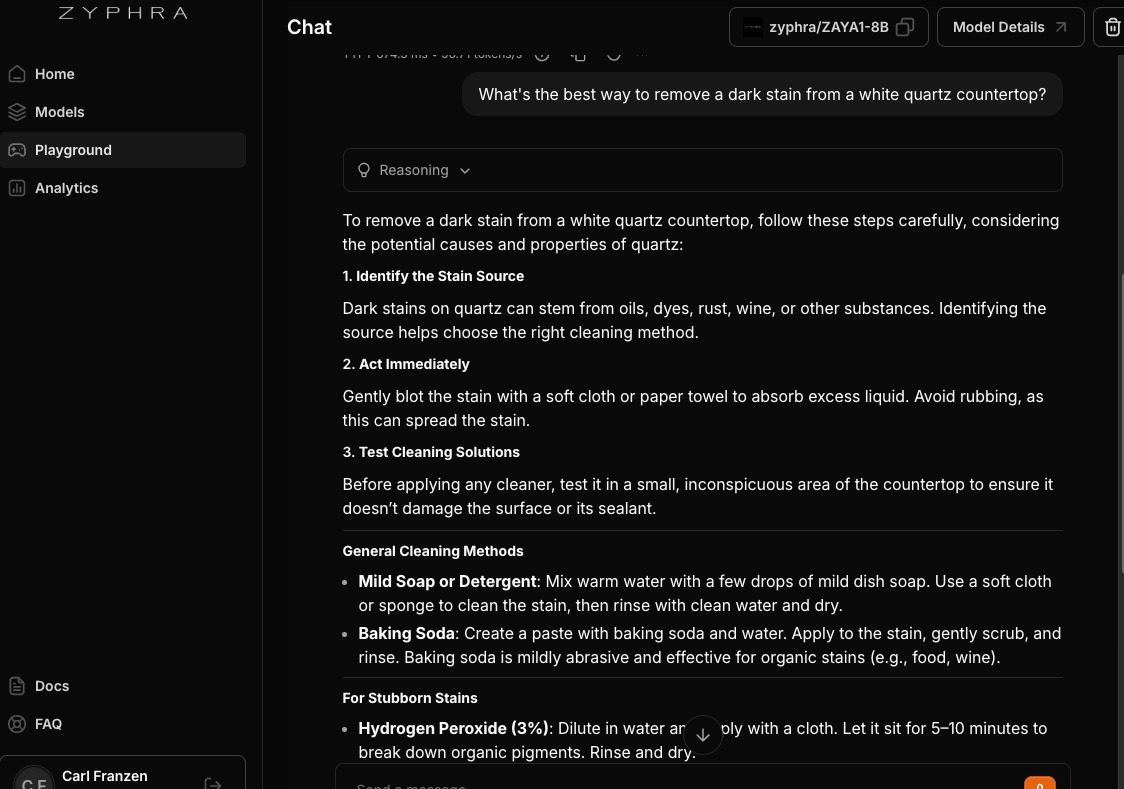
Этот подход отлично сработал при моем тестовом запросе об удалении пятен с кухонной столешницы к модели ZAYA1-8B, запущенной в Zyphra Cloud.
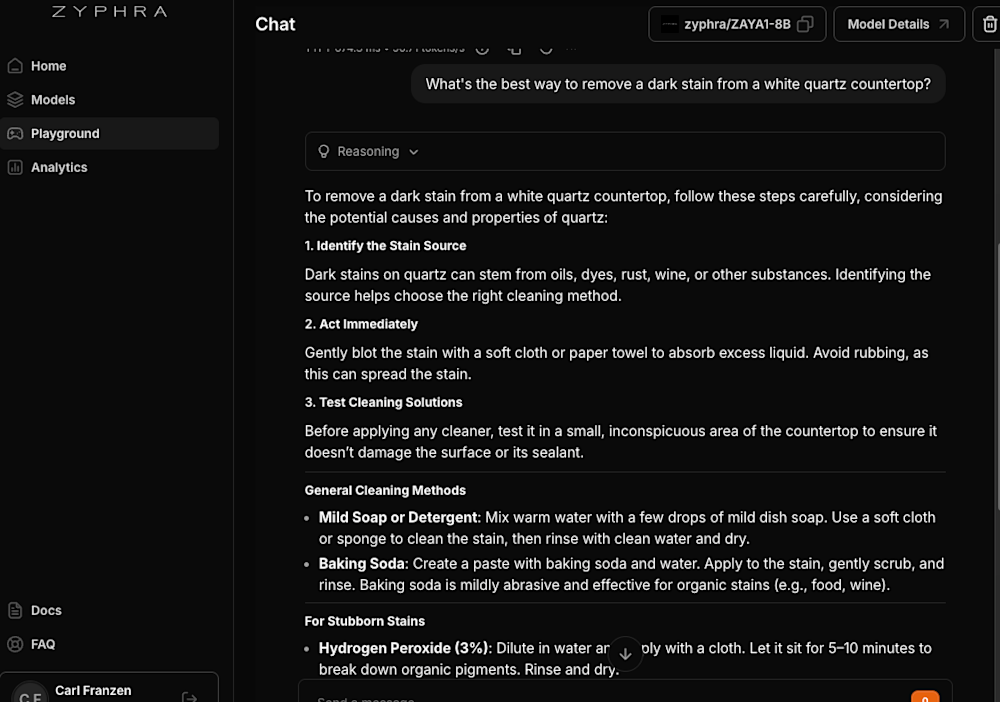
Скриншот моего диалога с ZAYA1-8B на платформе Zyphra Cloud. Источник: VentureBeat
Марковская RSA: переосмысление вычислений на этапе тестирования
Самый значительный скачок производительности модели обеспечивается методом Markovian RSA — новой методологией вычислений на этапе тестирования (test-time compute, TTC).
Традиционно, если вы хотите, чтобы модель «думала интенсивнее», вы заставляете ее генерировать более длинную цепочку рассуждений. Однако это часто приводит к «раздуванию контекста», при котором модель теряет фокус по мере того, как история становится слишком длинной.
Марковская RSA решает эту проблему путем разделения «глубины мышления» и «размера контекста». Этот процесс работает по принципу рекурсивного научного рецензирования:
-
Модель генерирует несколько параллельных цепочек рассуждений (кандидатов).
-
Затем извлекаются только «хвосты» (последние несколько тысяч токенов) этих цепочек.
-
Эти хвосты подвергаются субдискретизации и представляются модели в новом «промте агрегации» с запросом согласовать различные подходы в единое, более качественное решение.
Перенося вперед исключительно «хвосты» (обычно в пределах бюджета в 4K токенов), модель способна рассуждать бесконечно долго без риска переполнения контекстного окна. На практике это позволяет ZAYA1-8B с 700 млн активных параметров достигать результата в 91,9% в тесте AIME ’25, сокращая разрыв с моделями, обладающими в 30–50 раз большим числом активных параметров.
Поскольку общий объем параметров ZAYA1-8B остается небольшим (8,4 млрд), она идеально подходит для развертывания на устройствах и локальных LLM-приложений. Для предприятий это открывает возможность развертывания высокоуровневых возможностей рассуждения — традиционно доступных лишь для массивных облачных моделей — непосредственно на локальном «железе» или периферийных устройствах. Такой подход с приоритетом локального исполнения решает типичные для бизнеса проблемы конфиденциальности данных, задержек и высокой стоимости постоянных зависимостей от API.
Бенчмарки демонстрируют удивительно производительную компактную модель, выступающую в более тяжелой весовой категории
Zyphra позиционирует ZAYA1-8B как модель, «превосходящую свой вес», для разработчиков, которым требуются продвинутые способности к рассуждениям без задержек и затрат, характерных для огромных передовых моделей. В конце концов, количество активных параметров у нее значительно ниже, чем у других аналогичных по размеру моделей, что делает ее гораздо более дешевой и менее требовательной к вычислениям при инференсе.
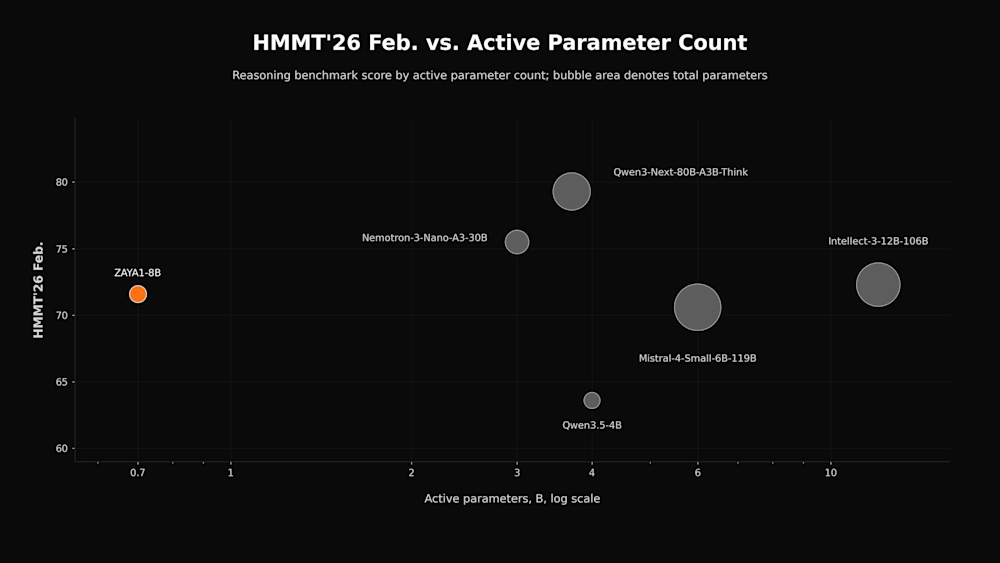
Диаграмма сравнения количества активных параметров ZAYA1-8B и других сопоставимых по размеру открытых моделей. Источник: Zyphra
-
Следование инструкциям: ZAYA1-8B набирает 85.58 балла в бенчмарке IFEval, оставаясь конкурентоспособной по сравнению со значительно более крупными моделями, такими как Intellect-3 (106B).
-
Агентные возможности: В бенчмарке τ² модель достигает показателя 43.12, а в BFCL-v4 — 39.22, задавая базовый уровень для задач вызова инструментов (tool-calling) и многошаговых сценариев.
При оценке в режиме единичной генерации (без дополнительного времени на «размышления») ZAYA1-8B уже превосходит модели своего класса. Она обходит Qwen3.5-4B и Gemma-4-E4B в математических и программных тестах.
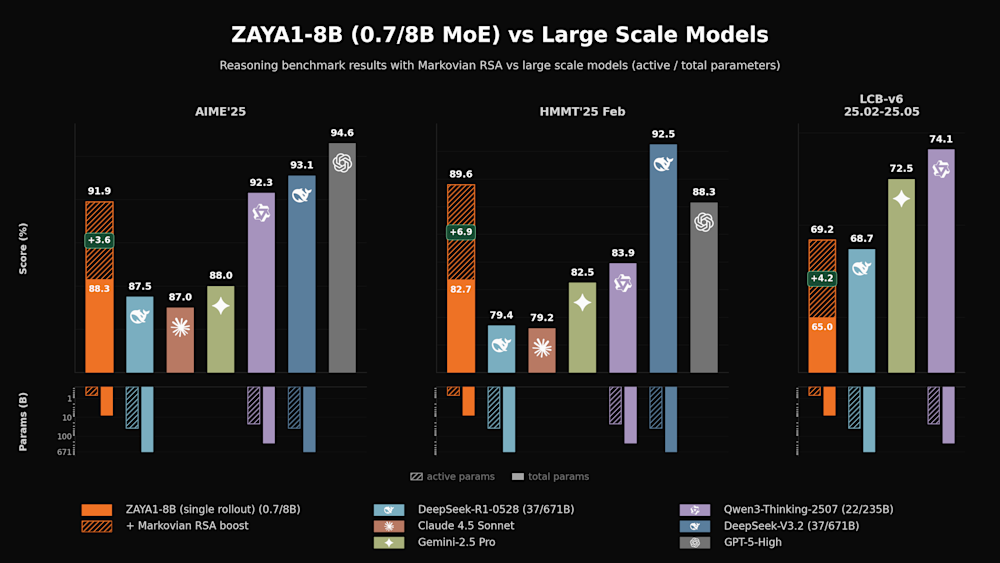
Сравнительная диаграмма бенчмарков ZAYA1-8B. Источник: Zyphra
При активации функции Markovian RSA результаты оказываются ошеломляющими:
-
HMMT ’25 (Математика): ZAYA1-8B набирает 89.6%, превосходя Claude 4.5 Sonnet (79.2%) и GPT-5-High (88.3%).
-
LiveCodeBench (Программирование): Модель достигает показателя 69.2%, опережая DeepSeek-R1-0528.
В Zyphra отмечают, что, хотя модель является специалистом в алгоритмических рассуждениях, она немного отстает от более крупных аналогов в задачах, «насыщенных знаниями» (например, при широком извлечении фактов в MMLU-Pro). Это говорит о том, что хотя логику рассуждений можно сжать до небольших ядер, фактологическая память все же выигрывает от большего объема «сырых» параметров.
Открытая лицензия Apache 2.0 для исследований и коммерческого использования
Zyphra выпустила ZAYA1-8B под лицензией Apache-2.0. Это критически важный выбор для сообщества разработчиков. В отличие от «копилефт»-лицензий вроде GPL, которые требуют, чтобы любая производная работа также была открытой, Apache-2.0 является крайне мягкой и разрешительной.
Для разработчиков и бизнеса это означает возможность использовать, модифицировать и распространять ZAYA1-8B — даже в составе проприетарных коммерческих приложений — без обязательства открывать исходный код собственных продуктов.
Лицензия также включает явное предоставление патентных прав от участников, обеспечивая уровень юридической безопасности для стартапов, строящих свои продукты на базе архитектуры Zyphra. Выбирая Apache-2.0 вместо более ограничительных лицензий «только для исследований», часто практикуемых передовыми лабораториями, Zyphra демонстрирует приверженность экосистеме открытых весов.
Для развертывания ZAYA1-8B разработчикам необходимо использовать специфические ветки из форков базовых библиотек от Zyphra, поскольку архитектура требует особой обработки:
-
Пользовательские форки: Пользователям следует установить ветку
zaya1из версий библиотекvllmиtransformersот Zyphra. -
Флаги развертывания: При запуске сервера vLLM требуются специальные флаги для обработки парсера рассуждений и вызова инструментов (например,
--reasoning-parser qwen3и--tool-call-parser zaya_xml). -
Стратегия параллелизма: Для сред с несколькими GPU Zyphra рекомендует использовать параллелизм данных (Data Parallelism, DP) в сочетании с экспертным параллелизмом (Expert Parallelism, EP). Примечательно, что тензорный параллелизм (Tensor Parallelism, TP) для механизма CCA модели в настоящее время не поддерживается, что делает связку DP+EP оптимальным путем для масштабирования пропускной способности инференса.
Справочная информация о Zyphra
Zyphra: новая парадигма плотности интеллекта
Основанная в 2021 году со штаб-квартирой в Пало-Альто, штат Калифорния, компания Zyphra Technologies представляет собой лабораторию искусственного интеллекта полного цикла, цель которой — создание общего искусственного интеллекта (AGI), согласованного с интересами человека (то есть превосходящего людей в большинстве задач), на базе децентрализованной открытой инфраструктуры.
Согласно официальному заявлению миссии компании, Zyphra стремится бросить вызов «централизованному» доминированию монолитных облачных моделей, сосредоточившись на «плотности интеллекта» — ключевом руководящем принципе, направленном на максимизацию логики и рассуждений, извлекаемых на один параметр и один FLOPS.
Генеральный директор и соучредитель Zyphra Критик Путалату ранее пояснял в интервью VentureBeat, что эта стратегия необходима для обеспечения работы высокопроизводительного ИИ локально на таких устройствах, как планшеты, умные очки и корпоративные серверы, что гарантирует конфиденциальность пользователей и снижает зависимость от сторонней облачной инфраструктуры.
Техническая идентичность компании глубоко укоренена в вычислительной нейробиологии под руководством соучредителя и главного научного сотрудника Берена Миллиджа.
Согласно личному сайту Миллиджа, в настоящее время он работает постдокторантом в Оксфордском университете на кафедре клинических нейронаук им. Наффилда, где его исследования сосредоточены на глубоком распределении кредитов и математических моделях мозга.
Миллидж, получивший докторскую степень в Эдинбургском университете, является пионером исследований в области активного вывода и «принципа свободной энергии» — концепций, которые напрямую влияют на стремление Zyphra к созданию мультимодальных архитектур, способных к долгосрочной памяти и непрерывному обучению.
Это влияние нейробиологии было ключевым при проектировании предыдущей модели Zyphra под названием Zamba, выпущенной в 2024 году, которая имитирует взаимодействие коры головного мозга и гиппокампа для обмена информацией между последовательными слоями. Недавнее выступление на TED дает представление о взглядах Миллиджа на пересечение биологической нейробиологии и ИИ, что служит теоретическим фундаментом для архитектур моделей Zyphra.
Компания Zyphra достигла значительных технических вех благодаря глубокой интеграции с аппаратной экосистемой AMD, как подробно описано в исследовательской документации компании.
Финансовые данные с платформы PitchBook показывают, что Zyphra в настоящее время поддерживается венчурными инвесторами и в июне 2025 года достигла статуса «единорога» после раунда финансирования серии A на сумму 110 миллионов долларов. Согласно PitchBook и пресс-релизам компании, Zyphra поддерживается группой стратегических инвесторов, включая Advanced Micro Devices (AMD), IBM, Bison Ventures и BC VC. Имея штат около 31 сотрудника по состоянию на 2026 год, компания продолжает расширять свое присутствие с помощью Zyphra Inference Cloud и платформы интеллектуального помощника Maia, созданной для предоставления продвинутых инструментов поиска и повышения производительности корпоративным командам.
Реакция сообщества и контекст в индустрии
Анонс нашел мощный отклик в ИИ-сообществе, набрав почти 1 миллион просмотров в X (бывш. Twitter) всего за 24 часа. Ажиотаж в основном сосредоточен вокруг двух факторов: жизнеспособности стека AMD и эффективности «каскада» рассуждений.
Технические специалисты отметили, что процесс пост-обработки Zyphra — 4-этапный каскад обучения с подкреплением — отличается необычайной дисциплиной. Большинство лабораторий используют лишь один раунд RL, однако конвейер Zyphra включает «разминку рассуждений», за которой следует курс из 400 адаптивных сред, напоминающих головоломки (RLVE-Gym), и лишь затем переходит к поведенческому шлифованию.
Одной из наиболее хвалимых деталей «под капотом» является повтор маршрутизатора (Router Replay). В MoE-моделях процесс обучения может стать нестабильным, если движок «тренера» и движок «инференса» принимают слегка различающиеся решения о том, какого эксперта использовать для токена из-за шума чисел с плавающей запятой. Система Zyphra записывает точный выбор экспертов, сделанный во время генерации, и принудительно заставляет тренера использовать именно их, эффективно «фиксируя» вычислительный путь и гарантируя более высокую стабильность обучения.
Поскольку индустрия сталкивается с потенциальным плато в преимуществах простого наращивания параметров, ZAYA1-8B предлагает убедительную альтернативную идею: следующий рубеж ИИ заключается не только в создании более крупных кластеров, но и в более умных алгоритмах «мышления», способных добиваться больших результатов меньшими средствами.




