


Uni-1 от Luma AI переосмысливает генерацию изображений


У рынка генерации изображений с помощью ИИ уже несколько месяцев есть бессменный лидер. Семейство моделей Nano Banana от Google задает стандарты качества, скорости и коммерческого внедрения, в то время как конкуренты от OpenAI до Midjourney борются за второе место. Эта иерархия изменилась в воскресенье, когда компания Luma AI, более известная своим инструментом генерации видео Dream Machine, публично выпустила Uni-1 — модель, которая не просто конкурирует с Google по качеству изображений, но и принципиально переосмысливает сам подход ИИ к созданию визуального контента.
Модель Uni-1 превосходит Nano Banana 2 от Google и GPT Image 1.5 от OpenAI на бенчмарках, оценивающих логическое мышление (reasoning), почти не уступает Google Gemini 3 Pro в обнаружении объектов и делает все это при затратах примерно на 10–30% ниже при высоком разрешении. По словам представителей Luma, в тестах на предпочтения пользователей с использованием рейтинга Эло Uni-1 занимает первое место по общему качеству, стилю и редактированию, а также по генерации на основе референсов. Лишь в чистой генерации изображений по текстовому описанию (text-to-image) верхнюю строчку сохраняет Nano Banana от Google.
Но одни лишь цифры не передают всей значимости этого релиза. Uni-1 представляет собой подлинный архитектурный отход от диффузионного подхода, который лежал в основе почти каждой крупной модели изображений до настоящего времени. В то время как такие инструменты, как Midjourney, Stable Diffusion и Google Imagen 3, создают изображения путем итеративного удаления шума из случайных помех, Uni-1 использует авторегрессионную генерацию — тот же метод предсказания токенов, который лежит в основе больших языковых моделей, — чтобы осмысливать создаваемое в процессе работы. Здесь нет передачи данных от системы, понимающей промпт, к отдельной системе, которая рисует картинку. Это единый процесс, работающий на одном наборе весов.
Это различие крайне важно для корпоративных клиентов, которые активно внедряют инструменты генерации изображений на базе ИИ для рекламы, дизайна продуктов и конвейеров создания контента. Модель, способная действительно осмыслять сложные инструкции, сохранять контекст при итеративных правках и оценивать собственные результаты, сокращает объем человеческого труда, необходимого для превращения технического задания в готовый актив — а именно этот пробел в возможностях сдерживал проникновение ИИ в профессиональную творческую работу.
Почему архитектура «унифицированного интеллекта» меняет возможности моделей изображений
Чтобы понять значение Uni-1, нужно понять, что именно она заменяет. Доминирующей парадигмой в генерации изображений с помощью ИИ была диффузия — процесс, который начинается со случайного шума и постепенно преобразует его в когерентное изображение под управлением текстового эмбеддинга. Диффузионные модели дают визуально впечатляющие результаты, но они не рассуждают в каком-либо осмысленном ключе. Они сопоставляют эмбеддинги промпта с пикселями посредством обученного процесса шумоподавления, не имея промежуточного этапа, на котором модель обдумывала бы пространственные отношения, физическую правдоподобность или логические ограничения.
Индустрия разработала обходные пути. DALL-E 3 использует GPT-4 для переписывания и расширения пользовательских промптов перед их передачей в отдельную модель генерации. Google Imagen 3 полагается на Gemini для логического анализа перед тем, как Imagen приступит к генерации. Эти подходы помогают, но они вводят уровень трансляции — стык между пониманием и созданием, на котором могут теряться информация и нюансы.
Uni-1 полностью устраняет этот стык. Как описывает Luma в своих технических спецификациях, модель представляет собой авторегрессионный трансформер только с декодером, где текст и изображения представлены в единой чередующейся последовательности, выступая одновременно в роли ввода и вывода. Компания заявляет, что Uni-1 «способна выполнять структурированные внутренние рассуждения до и во время синтеза изображения», декомпозируя инструкции, разрешая ограничения и планируя композицию перед рендерингом. Luma определяет этот подход как создание «системы, которая рассуждает, воображает, планирует, итерирует и выполняет действия как в цифровой, так и в физической средах», с моделями, которые «совместно моделируют время, пространство и логику в единой архитектуре, обеспечивая такие формы решения проблем, которых не могут достичь разрозненные конвейеры».
Практические последствия яснее всего проявляются в задачах, требующих подлинного понимания, а не сопоставления с шаблонами. В одной из демонстраций Uni-1 генерирует целую последовательность изображений на основе одной опорной фотографии, состаривая пианиста от детства до старости при сохранении того же ракурса камеры и единой сцены. В другой модели используются несколько отдельных фотографий домашних животных, и животные объединяются в совершенно новую сцену — одетые в академические мантии, стоящие перед доской с научными схемами — с сохранением индивидуальности каждого питомца. Это задачи, которые обычно требуют масштабного ручного составления промптов, посткактивной работы или и того, и другого.
Как Uni-1 проявляет себя в сравнении с Nano Banana, GPT Image и Midjourney на ключевых бенчмарках
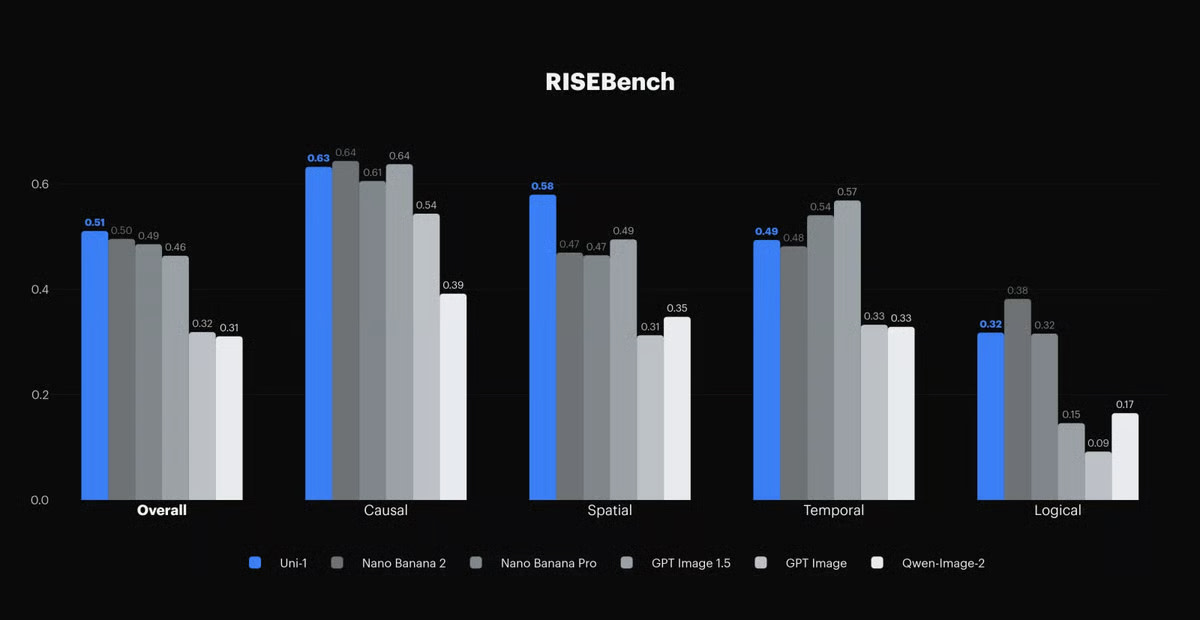
На бенчмарке RISEBench, разработанном специально для визуального редактирования на основе рассуждений (Reasoning-Informed Visual Editing) и оценивающем временные, причинно-следственные, пространственные и логические способности, Uni-1 демонстрирует передовые результаты по всем направлениям. Модель набирает 0,51 балла в общем зачете, опережая Nano Banana 2 с 0,50 балла, Nano Banana Pro с 0,49 балла и GPT Image 1.5 с 0,46 балла. Разрывы на вершине невелики, но резко возрастают в отдельных категориях. В пространственном мышлении Uni-1 лидирует с 0,58 балла против 0,47 у Nano Banana 2. В логическом рассуждении — самой сложной категории для моделей изображений — Uni-1 набирает 0,32 балла, более чем в два раза превосходя результат GPT Image (0,15) и Qwen-Image-2 (0,17).
Бенчмарк ODinW-13, измеряющий способность модели идентифицировать и находить объекты в сложных сценах с помощью плотного обнаружения с открытым словарем (open vocabulary dense detection), раскрывает еще более интересную особенность архитектуры Uni-1. Полноразмерная модель набирает 46,2 mAP, почти догоняя Google Gemini 3 Pro с 46,3 и значительно превосходя Qwen3-VL-Thinking с 43,2. Но вариант Uni-1, ориентированный исключительно на понимание (те же веса без обучения генерации), набирает всего 43,9. Этот прирост на 2,3 пункта служит прямым доказательством того, что обучение созданию изображений делает модель значительно лучше в их понимании, подтверждая главный тезис Luma о том, что унификация — это не просто архитектурное удобство, а множитель производительности.
В сравнении с Midjourney чаша весов склоняется в ту или иную сторону в зависимости от сценария использования. Тестирование издания The Decoder показало, что Uni-1 стала «заметным шагом вперед по сравнению с новой Midjourney v8, которая испытывала трудности с тем же промптом» при создании контента, требующего сложных рассуждений. Midjourney сохраняет репутацию лидера по эстетическому лоску в художественных и стилизованных работах, но для точного следования инструкциям и автоматизированных рабочих процессов преимущество Uni-1 в рассуждениях очевидно. Ранняя оценка одного из пользователей Reddit после сравнительного тестирования была прямой: «Когда дело доходит до реального логического мышления, понимания сложных сцен, пространственных вопросов/правдоподобности или правок, требующих настоящего осмысления, UNI-1 просто уделывает конкурентов».
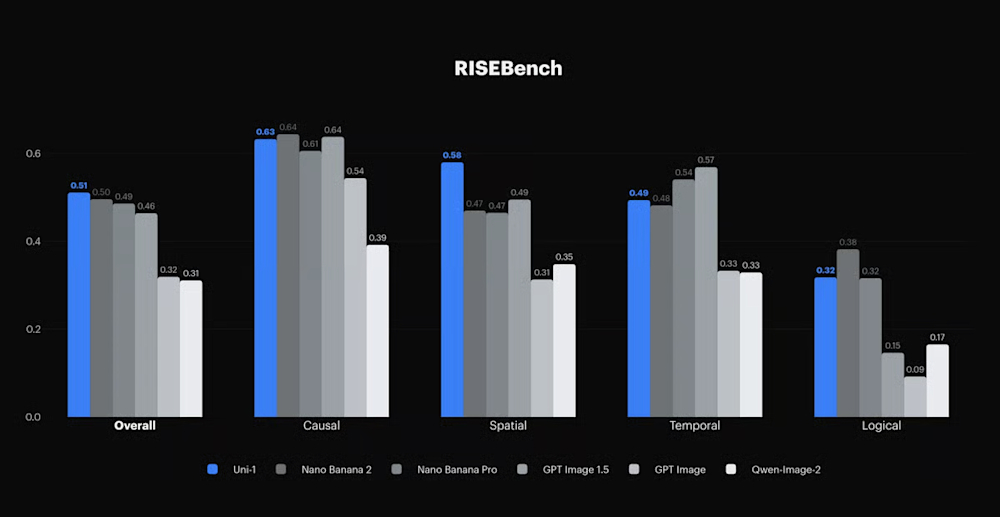
Uni-1 лидирует в общем, пространственном и логическом мышлении в оценке RISEBench, причем наибольшие преимущества проявляются в категориях, где конкурирующие модели испытывают наибольшие трудности. В логическом мышлении Uni-1 более чем в два раза превосходит показатели GPT Image и Qwen-Image-2. (Источник: Luma AI)
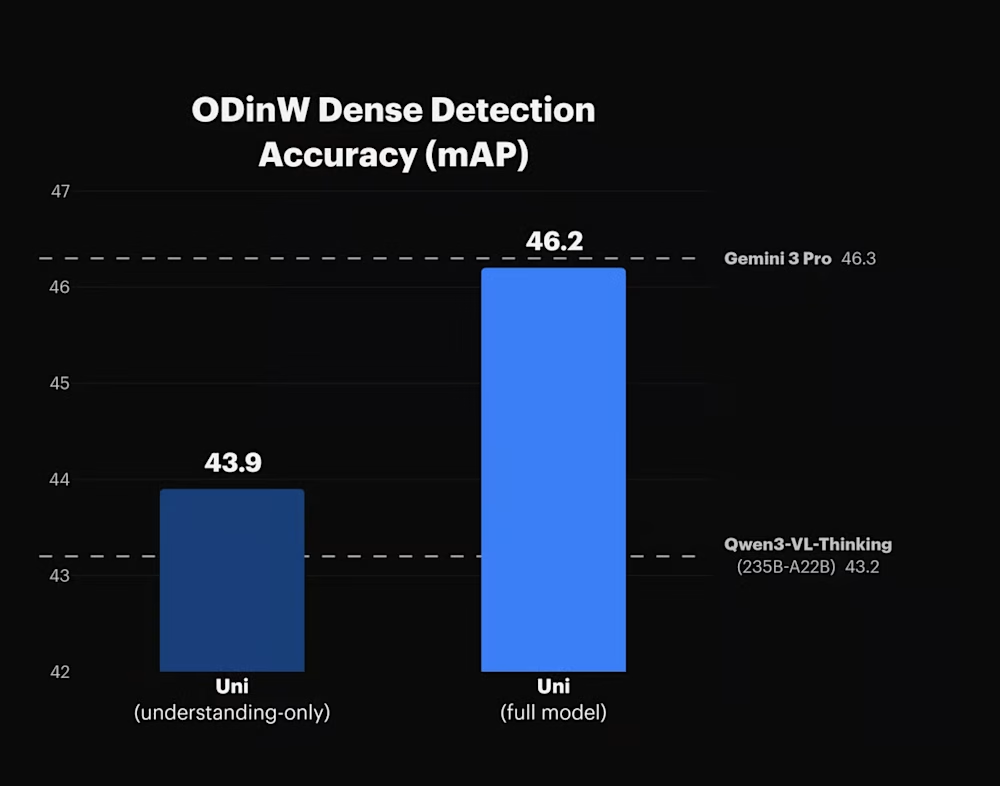
Полноразмерная модель Uni-1 от Luma набрала 46,2 балла в бенчмарке обнаружения объектов ODinW-13, почти сравнявшись с Google Gemini 3 Pro и заметно превзойдя собственный вариант, ориентированный только на понимание. Это говорит о том, что обучение генерации изображений также улучшает способность модели их воспринимать. (Источник: Luma AI)
Ценовая стратегия Luma бьет по позициям Google там, где это важнее всего
Помимо чистой производительности, Uni-1 выходит на рынок со структурой ценообразования, призванной переманивать корпоративных клиентов из экосистемы Google.
При разрешении 2K, которое является стандартным для большинства профессиональных рабочих процессов, стоимость API Uni-1 составляет примерно $0,09 за генерацию одного изображения по текстовому описанию по сравнению с $0,101 у Nano Banana 2 и $0,134 у Nano Banana Pro, согласно данным о ценах, опубликованным The Decoder. Редактирование изображений и генерация по одному референсу обходятся примерно в $0,0933, и даже генерация с использованием восьми входных референсов возрастает лишь примерно до $0,11.
Модель Nano Banana 2 от Google сохраняет ценовое преимущество при более низких разрешениях: изображение формата 0,5K стоит около $0,045, а 1K — около $0,067, как отмечает The Decoder. Но для производственных команд, генерирующих изображения высокого разрешения в больших масштабах — то есть именно для тех клиентов, на которых ориентируется Luma, — математика складывается в пользу Uni-1 как по качеству, так и по стоимости.
Такая ценовая стратегия отражает более широкий расчет в конкурентной борьбе. Luma не может тягаться с дистрибуцией или инфраструктурным охватом Google, поэтому она конкурирует в двух измерениях, где стартап может победить: превосходящие возможности в конкретных задачах и более низкая цена, которая оправдывает усилия по интеграции.
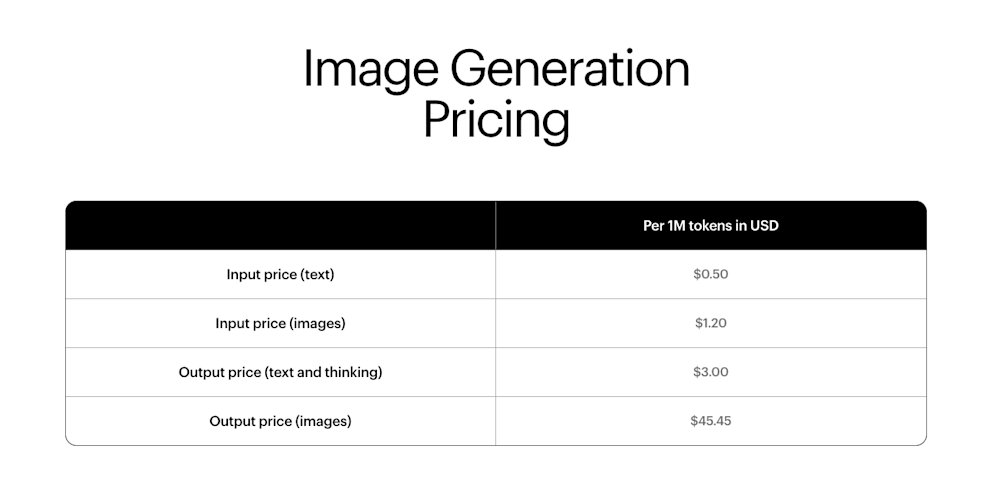
Цены Luma AI на генерацию изображений Uni-1 на основе токенов. Выходные изображения стоят $45,45 за миллион токенов. (Источник: Luma AI)
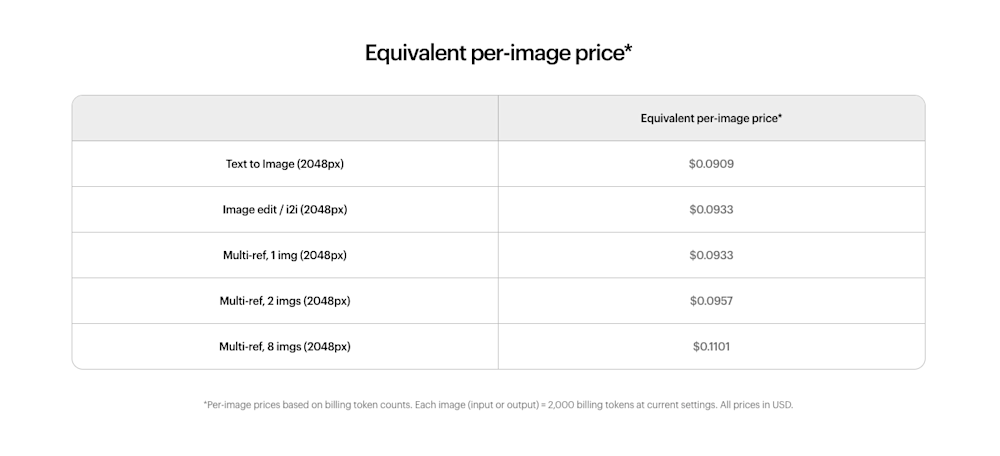
При текущих настройках одно изображение размером 2048 пикселей, сгенерированное Uni-1, стоит около девяти центов — меньше десяти центов. (Источник: Luma AI)
Как Luma Agents превращают модель в корпоративную креативную платформу
Uni-1 не существует как автономная модель. Она лежит в основе Luma Agents — фирменной агентской креативной платформы компании, запущенной в начале марта. Luma Agents созданы для управления полным циклом создания контента, охватывающим текст, изображения, видео и звук, координируя работу с другими моделями ИИ, включая Veo 3 и Nano Banana Pro от Google, Seedream от ByteDance и голосовые модели ElevenLabs.
Корпоративный интерес уже вполне осязаем. Генеральный директор Luma Амит Джайн сообщил TechCrunch, что компания начала развертывание платформы совместно с глобальными рекламными агентствами Publicis Groupe и Serviceplan, а также с такими брендами, как Adidas, Mazda и саудовская ИИ-компания Humain. В одном из упомянутых Джайном случаев Luma Agents сократили то, что могло стать «15-миллионной годовой рекламной кампанией», до нескольких локализованных роликов для разных стран, созданных за 40 часов менее чем за 20 000 долларов при прохождении внутреннего контроля качества бренда.
Ключевой способностью, обеспечивающей такое сжатие процессов, является умение Uni-1 оценивать и дорабатывать собственные результаты — цикл итеративной самокритики, который привычен для кодинг-агентов, но практически отсутствовал в инструментах креативного ИИ. Поскольку Uni-1 обрабатывает как понимание, так и генерацию, она может оценивать, соответствует ли результат замыслу инструкции, выявлять недостатки и проводить итерации без вмешательства человека. Джайн сравнил это с петлей обратной связи, которая сделала агентов для написания кода столь продуктивными, заявив TechCrunch: «Вам необходима способность оценивать свою работу, исправлять ее и повторять этот цикл до тех пор, пока решение не станет качественным и точным».
Модель также поддерживает функции, выходящие далеко за рамки базовой генерации текста в изображение. На технической странице Luma выделяются временное рассуждение, поддерживающее согласованность сцены при ее развитии во времени; управляемая референсами генерация, сохраняющая идентичность и композицию исходных фотографий; генерация с учетом культурных особенностей, охватывающая более 76 художественных стилей; и многоступенчатая доработка, позволяющая осуществлять итеративное творческое руководство без потери контекста. Как отметила MindStudio в своем анализе, такое сочетание делает Uni-1 «особенно сильной в задачах вроде следования сложным композиционным инструкциям» и «выполнения редактирования изображений на основе инструкций».
Первые реакции сигнализируют об изменении взглядов создателей на инструменты ИИ для работы с графикой
Первоначальная реакция сообщества оказалась исключительно положительной, хотя тщательное независимое тестирование находится еще на ранних стадиях. В соцсети X реакции сошлись вокруг общей темы: Uni-1 ощущается качественно иначе по сравнению с существующими инструментами. «Сама идея генерации на основе референсов с контролируемым позиционированием мощна, — написал Маянк Агарал. — Она дает создателям гораздо большую точность без ущерба для гибкости». Другой пользователь X, Наием Шейх, охарактеризовал новинку как «переход от подхода «напиши промпт и молись» к реальному творческому контролю».
На Reddit пользователь, проводивший параллельное тестирование с Nano Banana 2, дал более детальную оценку: он похвалил Nano Banana 2 за скорость и отрисовку текста, но пришел к выводу, что Uni-1 доминирует в «настоящих логических рассуждениях, понимании сложных сцен, пространственных/правдоподобных вопросах или правках, требующих реального мышления». Пользователь добавил: «Если вам важны картинки, которые действительно имеют смысл, а не просто быстро выглядят красиво, UNI-1 — это то, что нужно прямо сейчас».
Впрочем, не все готовы спешить с коронацией нового чемпиона. Некоторые пользователи отметили, что все еще ждут полноценного доступа к API для проведения собственного тестирования, а вопросы к обработке моделью нелатинских текстов, экстремальных граничных случаев и скорости генерации при максимальном разрешении остаются открытыми — это известная плата за авторегрессионные архитектуры по сравнению с оптимизированными диффузионными пайплайнами.
Что модель Luma означает для будущего гонки генераторов изображений на базе ИИ
Luma описывает Uni-1 как проект, который «только начинает свой путь». Компания заявляет, что ее унифицированный дизайн «естественным образом выходит за рамки статических изображений, распространяясь на видео, голосовых агентов и полностью интерактивные симуляторы миров», а Джайн сообщил TechCrunch, что возможности вывода аудио и видео появятся в последующих релизах. Uni-1 доступна для бесплатного тестирования на сайте lumalabs.ai, а доступ к API открывается постепенно.
Стремление создать единую модель, способную видеть, говорить, рассуждать и творить в рамках непрерывного потока, разделяет практически каждая крупная ИИ-лаборатория. Google, OpenAI, Meta и другие компании занимаются мультимодальной унификацией с ресурсами, перед которыми блекнут любые возможности стартапов. Вопрос в том, смогут ли фора Luma в создании унифицированной архитектуры и уже продемонстрированные ею преимущества в производительности выдержать неизбежную реакцию со стороны этих более крупных конкурентов.
История знает противоречивые примеры. Стартапы, задающие новую парадигму, порой оказываются поглощены или перекуплены до того, как успевают извлечь из этого выгоду. Но порой именно они диктуют условия конкуренции целому поколению технологий. На данный момент индустрия генерации изображений с помощью ИИ сталкивается с простой и не самой удобной реальностью: лучшая в мире модель генерации картинок на основе рассуждений была создана не Google, не OpenAI и не кем-то из привычных тяжеловесов. Ее разработал стартап из 150 человек в Сан-Франциско — и она к тому же обходится дешевле.




