


Самая маленькая модель Liquid AI LFM2.5-230M превосходит модели, в 4 раза превышающие ее по размеру, в извлечении данных и может работать «где угодно»
Источник: VentureBeat · Carl Franzen


Компания Liquid AI, основанная бывшими специалистами по компьютерным наукам из Массачусетского технологического института (MIT), выпустила свою самую маленькую языковую модель на сегодняшний день — LFM2.5-230M. Предприятиям определенно стоит рассмотреть ее для задач извлечения данных и локального развертывания на смартфонах, ноутбуках и робототехнических устройствах.
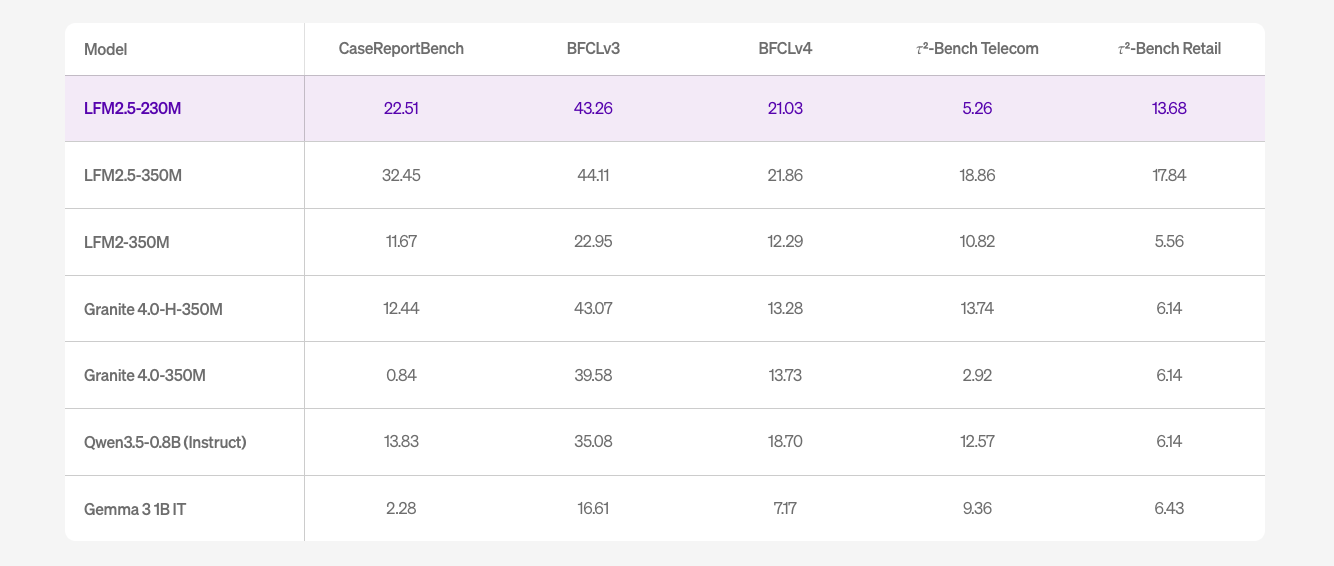
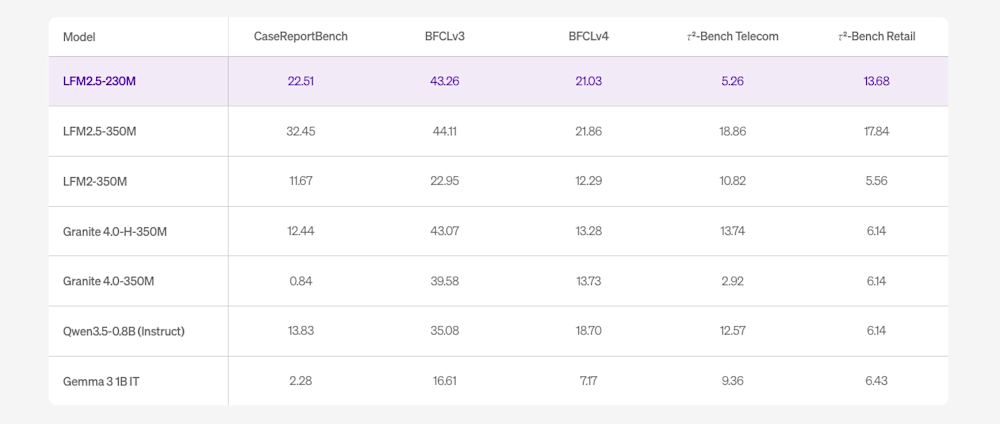
Эта базовая модель с 230 миллионами параметров разработана специально для агентных рабочих процессов на периферийных устройствах (on-device). Как отмечает Liquid в своем блоге, благодаря столь малому размеру ее можно запускать практически «где угодно». По данным компании, она также превосходит по ряду бенчмарков модели, размер которых превышает ее в 4 раза: в частности, она справляется с извлечением данных лучше, чем модель от Alibaba Qwen3.5-0.8B (Instruct) с 800 миллионами параметров и Google Gemma 3 1B с 1 миллиардом параметров.
Сравнительная диаграмма бенчмарков Liquid AI LFM2.5-230M. Источник: Liquid AI
Модель ориентирована на разработчиков и инженеров, создающих легковесные конвейеры извлечения данных и автономные периферийные системы.
Модель распространяется по коммерческой лицензии двойного назначения: она остается бесплатной для частных лиц и компаний с годовой выручкой менее 10 миллионов долларов, в то время как крупным корпорациям требуется платное корпоративное соглашение.
Этот релиз выделяется на фоне других небольших ИИ-моделей благодаря использованию архитектуры LFM2, которая обеспечивает высокую скорость инференса без огромных затрат памяти, типичных для моделей на базе трансформеров с большим количеством параметров.
В то время как ведущие ИИ-компании, такие как Anthropic, OpenAI, Google, Microsoft, Meta и другие, увеличивают количество параметров до сотен миллиардов и триллионов для достижения передовой производительности, параллельная гонка полностью сосредоточена на периферийных и локальных развертываниях.
Выпуск Liquid AI модели LFM2.5-230M знаменует собой поворотный сдвиг в сторону архитектурной эффективности, а не грубого масштабирования за счет вычислительных мощностей. Уместив предварительное обучение на 19 триллионах токенов в объем 230 миллионов параметров, компания доказывает, что периферийным устройствам не нужны огромные вычислительные мощности или постоянное облачное подключение для выполнения сложных многошаговых агентных процессов.
Как работает LFM2.5-230M
Модель LFM2.5-230M отклоняется от стандартных архитектур трансформеров, полагаясь вместо этого на фреймворк LFM2. Эта архитектура работает как гибридная система, чередующая шлюзованные свертки малой дальности с вниманием с группированными запросами (grouped-query attention) для эффективной обработки информации.
Для тех, кто следит за эволюцией эффективных архитектур, подход Liquid преследует схожую концептуальную цель: эффективное управление длинными контекстами и последовательными данными на периферийном оборудовании без квадратичных затрат памяти, присущих механизмам чистого внимания. Модель поддерживает обширное окно контекста на 32 тыс. токенов, что позволяет ей обрабатывать значительные документы или непрерывные потоки робототехнической телеметрии.
При анализе графиков производительности, представленных в релизе, архитектурная эффективность становится очевидной визуально. Модель сохраняет объем используемой памяти на уровне менее 400 МБ, обеспечивая при этом скорость предзаполнения (prefill) и декодирования, которая превосходит сопоставимые модели, такие как Gemma 3 1B IT и Granite 4.0-H-350M.
На смартфоне Samsung Galaxy S25 Ultra, оснащенном процессором Qualcomm Snapdragon Gen4, модель достигает скорости декодирования в 213 токенов в секунду. Даже на сильно ограниченном в ресурсах Raspberry Pi 5 модель поддерживает скорость декодирования в 42 токена в секунду. Кроме того, внутреннее тестирование показывает, что стек инференса на GPU обеспечивает более низкую сквозную задержку по сравнению с конкурирующими небольшими моделями на всех уровнях параллелизма.
Почему это важно для бизнеса
Чтобы понять, зачем нужна модель с 230 миллионами параметров, необходимо взглянуть на то, как предприятия в настоящее время управляют данными.
Организации традиционно полагались на жесткие, основанные на правилах скрипты ETL (извлечение, преобразование, загрузка) для перемещения и обработки данных. Однако эти устаревшие системы известны своей хрупкостью: простое изменение макета документа или обновление схемы может нарушить работу всего конвейера.
Чтобы решить эту проблему, индустрия смещается в сторону «ИИ-ETL», где машинное обучение определяет маппинг, обнаруживает дрейф схем и автоматически адаптируется к изменениям. В современном легковесном конвейере извлечения данных модель ИИ подключается к неструктурированным источникам — таким как PDF-файлы, электронные письма или веб-формы — и структурирует данные в такие форматы, как JSON, без необходимости использования жестко зашифрованных правил.d
Для предприятий использование массивной флагманской модели вроде Claude Opus 4.6 (которая стоит 5,00 долларов за миллион входных токенов) для синтаксического анализа рутинных счетов, форматирования адресов или маршрутизации телеметрических данных экономически нецелесообразно.
Именно здесь модели вроде LFM2.5-230M становятся критически важными. Разработанная специально как легковесный движок извлечения, она позволяет компаниям автоматизировать повторяющееся форматирование и синтаксический анализ данных за малую долю вычислительных затрат и задержек, запускаясь непосредственно на локальном оборудовании вместо того, чтобы полагаться на дорогостоящие и постоянные вызовы облачных API.
Бенчмарки небольших моделей: LFM против класса 3B
В середине 2026 года индустрия искусственного интеллекта переживает возрождение «маленьких» моделей, однако само определение «маленького» сильно разнится.
Недавно сообщество открытых весов было поражено моделью Weibo VibeThinker-3B — трехмиллиардной моделью на базе архитектуры Qwen2, которая набрала внушительные 94,3 балла в математическом бенчмарке AIME 2026, составив конкуренцию 600-миллиардным гигантам за счет агрессивного кураторства данных и обучения с подкреплением.
Аналогичным образом, семейство моделей Google Gemma 4, количество загрузок которого недавно превысило 200 миллионов, переносит передовой ИИ на периферийные устройства, включая модель E2B (2 миллиарда параметров), разработанную специально для мобильных и IoT-развертываний.
В противоположность этому, модель LFM2.5-230M от Liquid AI работает в совершенно другой весовой категории. Обладая всего 230 миллионами параметров, она примерно в десять раз меньше самой маленькой модели Google Gemma 4 и VibeThinker-3B.
Из-за своего микроскопического размера LFM2.5-230M не предназначена для конкуренции в задачах со сложным рассуждением, таких как продвинутая математика, программирование или творческое письмо — ограничение, которое Liquid AI прямо признает.
Тем не менее, в своих целевых областях извлечения данных и вызова инструментов (tool calling) модель выступает значительно выше своего веса.
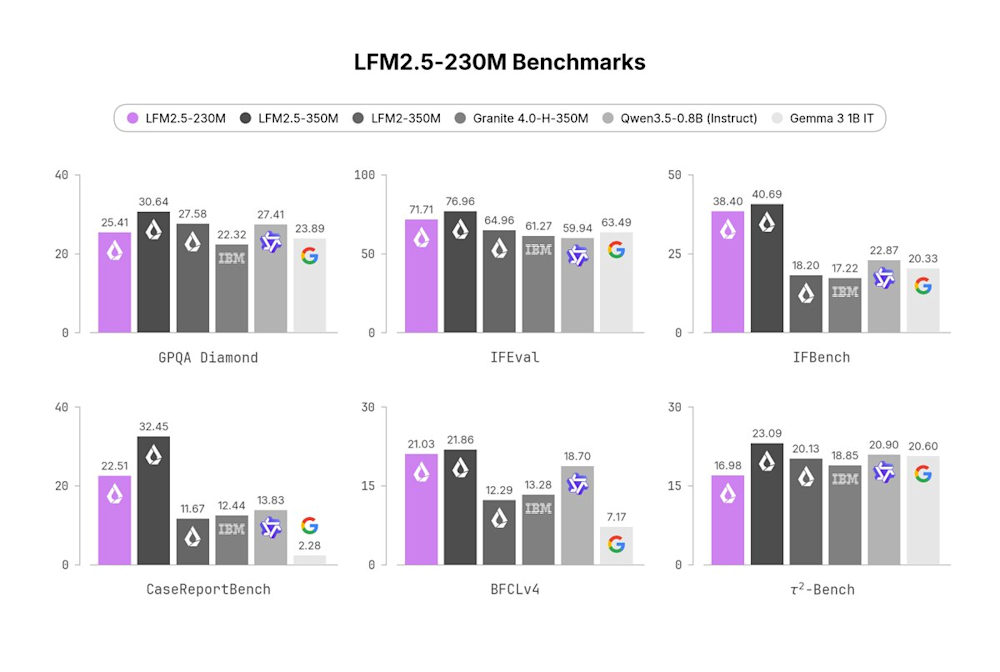
Бенчмарки, выпущенные Liquid AI, показывают, что LFM2.5-230M набирает 43,26 балла в бенчмарке использования инструментов BFCLv3, превосходя Granite 4.0-350M от IBM (39.58) и полностью опережая более крупные одномиллиардные модели, такие как Google Gemma 3 1B IT (16.61).
Сравнительная столбчатая диаграмма бенчмарков Liquid AI LFM2.5-230M. Источник: Liquid AI
В бенчмарке CaseReportBench для извлечения данных она набирает 22.51 балла, оставляя позади Qwen3.5-0.8B (Instruct).
LFM2.5-230M доказывает, что в то время как трехмиллиардные модели вроде VibeThinker решают задачи высшей математики, модель с 230 миллионами параметров является превосходным, высоко оптимизированным выбором для выполнения структурированных вызовов инструментов и поддержания эффективной работы агентных конвейеров на ограниченном оборудовании.
Продвинутые исследовательские варианты использования
Поскольку модель отлично справляется с вызовом инструментов, LFM2.5-230M функционирует в первую очередь как уровень выбора навыков. Liquid AI продемонстрировала эту способность, развернув модель на гуманоидном роботе Unitree G1.
Работая полностью на самом устройстве с помощью встроенного вычислительного модуля NVIDIA Jetson Orin робота, модель успешно обрабатывает сложные команды, описывающие окружение.
Как отмечается в техническом блоге компании, модель принимает свободную инструкцию вроде: *«Замри на 2 секунды, затем иди вперед со скоростью 1 метр в секунду в течение 3 метров, встань на одно колено и удерживай положение в течение 5 секунд, и пройди назад со скоростью 0,5 метра в секунду в течение 3 метров»*, и автоматически переводит ее в структурированный многошаговый план, задействующий предварительно обученные низкоуровневые навыки, предоставляемые фреймворком NVIDIA SONIC.
Базовая и дообученная модели доступны немедленно на Hugging Face с нативной поддержкой с первого дня в экосистеме инференса для llama.cpp (GGUF), MLX, vLLM, SGLang и ONNX.
Двойного назначения, пользовательская открытая лицензия LFM
Liquid AI поставляет LFM2.5-230M под лицензией LFM Open License v1.0. Несмотря на слово «open» (открытая) в названии, эта лицензия не соответствует требованиям Инициативы по открытому исходному коду (OSI); она работает как ограниченный коммерческий каркас двойного назначения.
Для независимых разработчиков, исследователей и стартапов на ранней стадии эта лицензия работает идентично программному обеспечению с открытым исходным кодом.
Пользователи получают бессрочную, всемирную, безвозмездную лицензию на воспроизведение, модификацию и распространение модели при условии сохранения первоначальных уведомлений об авторских правах и явного указания любых внесенных изменений.
Тем не менее, лицензия включает строгое «Ограничение коммерческого использования». Любое юридическое лицо, генерирующее годовой доход в размере 10 миллионов долларов или более, теряет право использовать модель в коммерческих целях по данному соглашению.
Крупным предприятиям, пересекающим этот финансовый порог, необходимо согласовать отдельное платное коммерческое соглашение с Liquid AI для развертывания модели в продакшене.
Эта стратегия защищает компанию от поглощения ее интеллектуальной собственности крупными технологическими конгломератами бесплатно, продолжая при этом распространять модель на уровне рядовых разработчиков.




