


K2 Think: самый быстрый в мире открытый ИИ


Не путайте с недавно выпущенной мощной моделью с открытым исходным кодом Kimi K2 от китайской лаборатории искусственного интеллекта Moonshot, так как сегодня дебютировала еще одна новая большая языковая модель (LLM) с открытым исходным кодом под названием «K2 Think». Она уже производит фурор среди опытных пользователей и наблюдателей в сфере ИИ благодаря своим заявлениям о том, что это «самая быстрая в мире модель ИИ с открытым исходным кодом» и «самая передовая система рассуждений на базе ИИ с открытым исходным кодом из когда-либо созданных».
Эта модель стала результатом сотрудничества Института фундаментальных моделей при Университете искусственного интеллекта имени Мохаммеда бен Заида (MBZUAI) и стартапа G42 AI, базирующихся в Объединенных Арабских Эмиратах.
«Мы гордимся этой моделью, которая значительно превосходит свой вес. Она разрабатывалась в первую очередь для математических рассуждений, но при этом оказалась весьма универсальной», — написал в X старший научный сотрудник MBZUAI Тейлор В. Киллиан (Taylor W. Killian).
Вот что нужно знать о ней техническим директорам и специалистам, работающим в компаниях:
Высокая скорость и производительность в компактном исполнении
K2 Think содержит 32 миллиарда параметров (32B) — относительно небольшой показатель по сравнению с триллионами параметров у ведущих американских базовых моделей. Параметры определяют внутренние настройки, управляющие поведением LLM, причем большее их число обычно указывает на более мощную и производительную модель.
Тем не менее, продолжая недавнюю тенденцию, когда лаборатории ИИ создают более мелкие, эффективные, но при этом высокопроизводительные модели, K2 Think не уступает или превосходит значительно более крупные модели (с большим количеством параметров) в сложных тестах по математике, написанию кода и научным дисциплинам, и все это при гораздо меньших требованиях к вычислительным ресурсам.
По словам ее создателей, это самая быстрая в мире модель ИИ с открытым исходным кодом, способная генерировать 2000 токенов в секунду на один запрос пользователя — это более чем в 10 раз превышает пропускную способность типичного развертывания на графических процессорах (GPU).
Токены представляют собой числовые представления понятий, слов и фрагментов слов, предложений, математических символов и единиц кода — по сути, это «родной язык» LLM и способ кодирования всего, чему она научилась. Поэтому количество токенов, генерируемых LLM в секунду, является хорошим мерилом ее общей скорости ответа.
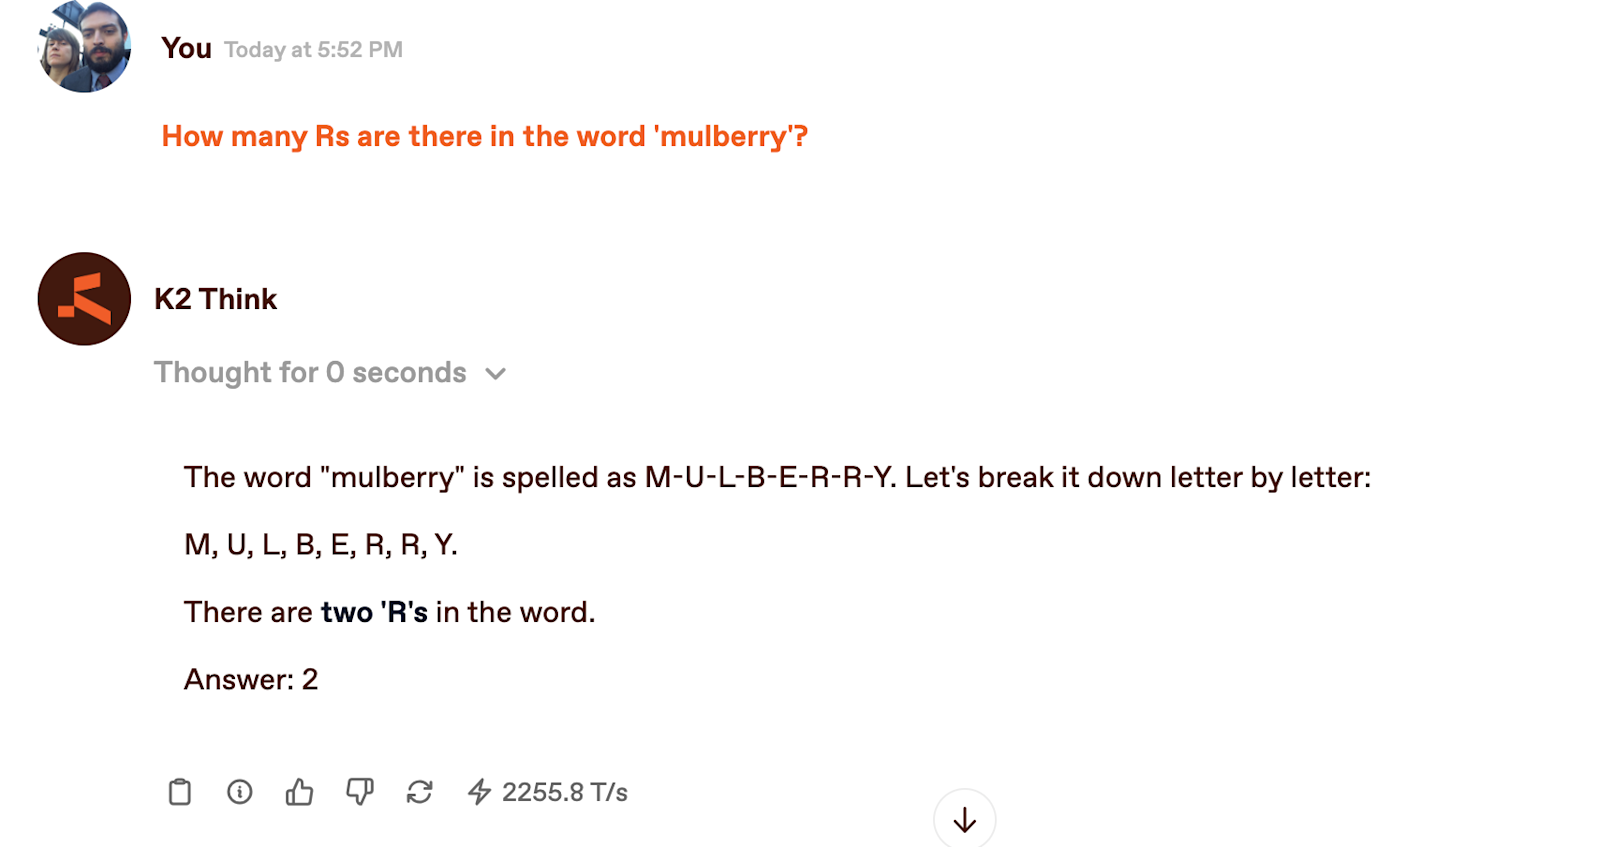
Действительно, независимый сайт измерения производительности ИИ Artificial Analysis показывает, что среди других ведущих американских моделей лидирует Google Gemini 2.5 Flash с показателем 258 токенов в секунду, что значительно ниже 2000 токенов, заявленных для K2 Think. Мои краткие неформальные тесты чат-бота K2 Think в веб-версии также продемонстрировали впечатляюще быстрые ответы, часто занимающие доли секунды.
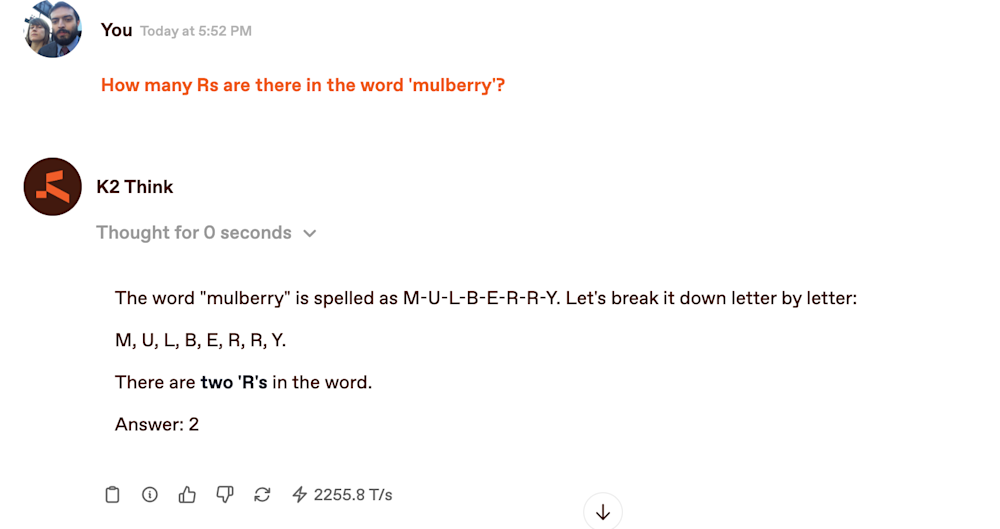
Скриншот использования чат-бота K2 Think в веб-версии. Источник: VentureBeat
Александру Воика (Alexandru Voica), советник MBZUAI и руководитель по корпоративным коммуникациям в Synthesia, охарактеризовал эту модель как поворотный момент. «Годами вера была проста: делайте модели крупнее, и прогресс придет по графику, — написал он в X. — Те, у кого были ресурсы для вычислений, добивались прогресса, в то время как все остальные наблюдали со стороны. Сегодня K2 Think врывается на этот праздник жизни».
Свободная лицензия для коммерческого использования
Подобно другим недавним ИИ-релизам от компаний из стран за пределами США (в частности, из Китая), эта модель из ОАЭ стала доступна разработчикам и предприятиям под лицензией Apache 2.0, которая разрешает чрезвычайно широкое использование в коммерческих приложениях, исследованиях и любых других целях конечного пользователя (по сути).
Это означает, что компании могут свободно брать код K2 Think (а также обучающие данные, веса и параметры), загружать его, модифицировать, развертывать в коммерческих приложениях и выполнять множество других действий — абсолютно бесплатно.
Разработана для рассуждений, а не простого общения
K2 Think оптимизирован для сложного решения задач, а не для непринужденного общения. Модель подходит к таким задачам, как математические доказательства, написание кода и научные рассуждения, с помощью пошаговой стратегии планирования и выполнения, что соотносится с тем, как эксперты-люди решают структурированные проблемы.
По результатам бенчмарк-тестирования K2 Think опережает все другие модели с открытым исходным кодом в сфере конкурсной математики. Она набрала 90,8 балла в AIME 2024, 81,2 балла в AIME 2025 и 73,8 балла в HMMT 2025, согласно данным тестов, опубликованным ее создателями на Hugging Face:
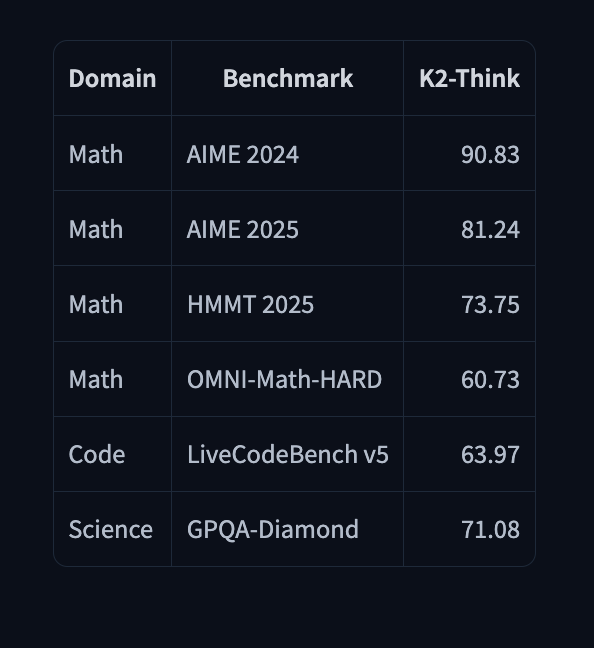
Источник: MBZUAI и G42
На платформе OMNI-MATH-HARD модель достигла результата 60,7 балла, а также демонстрирует высокие показатели в других технических областях, набрав 64,0 балла в LiveCodeBench v5 (программирование) и 71,1 балла в GPQA-Diamond (наука).
«Если вы убеждали себя, что только мегамодели способны справляться со сложными проблемами, считайте это вежливым опровержением», — отметил Воика. Он охарактеризовал K2 Think как «лучшую модель с открытым исходным кодом для сложных математических бенчмарков», которая конкурирует с проприетарными передовыми системами от OpenAI и DeepSeek, обладая при этом лишь долей их размера.
Скорость за счет оборудования: инференс на базе чипов Cerebras
Работа K2 Think в реальном времени обеспечивается благодаря архитектуре Wafer-Scale Engine (WSE) от стороннего провайдера ИИ-вычислений Cerebras, которая позволяет обрабатывать длинные ответы (до 32 000 токенов) всего за 16 секунд.
Аналогичные задачи на стандартных высокопроизводительных графических процессорах могут занимать более 2,5 минут.
Применение спекулятивного декодирования дополнительно повышает скорость отклика. Воика отметил, что «сторонники концепции „быстро и экономно“ получили аппаратную поддержку», имея в виду то, как K2 Think достигает целевых показателей пропускной способности, оставаясь при этом вычислительно эффективной.
Шесть столпов эффективности модели
K2 Think зависит не только от масштаба. Согласно техническому отчету, опубликованному ее разработчиками, ее архитектура включает шесть интегрированных методов, которые способствуют повышению производительности и эффективности:
-
Контролируемое дообучение (SFT) с примерами длинных цепочек рассуждений (chain-of-thought)
-
Обучение с подкреплением с проверяемыми наградами (RLVR)
-
Агентное планирование, структурирующее рассуждения до генерации
-
Масштабирование на этапе тестирования (Test-Time Scaling) с использованием выборки Best-of-N
-
Спекулятивное декодирование для ускорения инференса
-
Аппаратная оптимизация посредством развертывания на чипах Cerebras
Воика резюмировал этот рецепт как «эффективные рассуждения по дизайну» — дорожную карту, которая позволяет K2 Think соперничать с передовыми моделями, превосходящими ее по размеру в 10–20 раз.
Стратегия ОАЭ по достижению глобального влияния
Как сообщает газета The New York Times, K2 Think является частью более масштабных усилий Объединенных Арабских Эмиратов по утверждению себя в качестве ключевого игрока на мировой арене искусственного интеллекта.
Институт фундаментальных моделей, основанный в марте университетом MBZUAI, представляет собой центральный элемент государственной стратегии «Искусственный интеллект 2031», которая нацелена на лидерство в открытых исследованиях и интеллектуальный суверенитет.
Президент MBZUAI Эрик Синг (Eric Xing), бывший профессор Университета Карнеги — Меллона, подчеркнул, что система была создана всего с использованием 2000 специализированных чипов для ИИ, что значительно меньше объема оборудования, обычно задействуемого ведущими американскими лабораториями. «Мы можем добиваться результатов, располагая ограниченными ресурсами», — заявил Синг в интервью газете Times.
Полная прозрачность: открытый исходный код на всех уровнях
В отличие от многих моделей, которые имеют статус «открытых», но предлагают лишь частичный доступ, K2 Think включает в себя обучающие данные, веса модели, код для дообучения, инструменты инференса и инфраструктуру для развертывания. Она доступна для скачивания и использования через k2think.ai и Hugging Face, также работает публичный API.
В настоящее время официального API K2 Think в открытом доступе нет. Однако представитель MBZUAI сообщил VentureBeat по электронной почте: «Мы намерены сделать API доступным для корпоративного использования в будущем и поделимся дополнительными подробностями по мере их появления».
Разработчики также поделились результатами внутренних проверок безопасности по четырем категориям, что является шагом к ответственной прозрачности. K2 Think получила макросредний показатель 0,75 по категориям: отказ в предоставлении контента высокого риска (0,83), надежность в диалоге (0,89), устойчивость к джейлбрейку (0,72) и кибербезопасность/защита данных (0,56).
Реакция лидеров: переосмысление подходов к созданию ИИ
В пресс-релизе Пен Сяо (Peng Xiao), генеральный директор группы G42, представил K2 Think как доказательство того, что инновации теперь проистекают из более умных режимов обучения, а не просто из увеличения кластеров.
В том же документе Хальдун Халифа Аль Мубарак (Khaldoon Khalifa Al Mubarak), председатель Совета попечителей MBZUAI, охарактеризовал K2 Think как важную веху в глобальном обмене знаниями и сотрудничестве, а также как шаг в сторону подотчетных и воспроизводимых систем ИИ.
Воика поддержал этот общий нарратив в X, заявив: «Если паритет производительности возможен при 1/20 размера, то капитал и таланты мигрируют в сторону более умных режимов обучения. Добро пожаловать, таким образом, в пост-размерную эпоху: умное побеждает массивное, открытое побеждает закрытое».
K2 Think — это больше, чем демонстрация эффективной инженерии моделей: это доступная основа для широкого круга исследователей и разработчиков. Обладая высокопроизводительной скоростью, прозрачной практикой выпуска и доказанной в бенчмарках способностью к рассуждениям, она задает новый стандарт того, чего может достичь компактный ИИ с открытым исходным кодом.
Система теперь доступна для изучения, адаптации и развертывания через k2think.ai.




