


Google выпускает Gemini 3.1 Flash Lite по цене в 8 раз ниже стоимости Pro


Новейшая модель искусственного интеллекта от Google уже здесь: Gemini 3.1 Flash-Lite, и на этот раз главные улучшения касаются стоимости и скорости, особенно для предприятий и разработчиков, стремящихся задействовать мощные возможности логического вывода и мультимодальности от американского гиганта поиска и облачных технологий.
Позиционируя ее как самую экономичную и отзывчивую модель в серии Gemini 3, Google предлагает решение, созданное специально для масштабируемого интеллекта.
Этот запуск происходит всего через несколько недель после февральского дебюта ее «тяжеловесного» собрата, Gemini 3.1 Pro, завершая многоуровневую стратегию, которая позволяет предприятиям масштабировать интеллектуальные возможности на всех уровнях своей инфраструктуры.
Технологии: оптимизация для показателя «время до первого токена»
В мире высокопроизводительного искусственного интеллекта метрикой, которая часто определяет пользовательский опыт, является не только точность, но и задержка. Для служб поддержки в реальном времени, модерации контента или мгновенной генерации пользовательских интерфейсов «время до получения первого токена ответа» служит основным индикатором того, воспринимается ли приложение как инструмент или как полноценный помощник. Если модели требуется хотя бы две секунды для начала ответа, иллюзия плавного взаимодействия разрушается.
Gemini 3.1 Flash-Lite разработана специально для достижения такого ощущения мгновенности. Согласно внутренним бенчмаркам и сторонним оценкам, Flash-Lite превосходит своего предшественника, Gemini 2.5 Flash, обеспечивая в 2,5 раза меньшее время до первого токена. Более того, она может похвастаться увеличением общей скорости генерации на 45 процентов — 363 токена в секунду по сравнению с 249.
Эта скорость достигается благодаря тому, что Корай Кавукчуоглу (Koray Kavukcuoglu), вице-президент по исследованиям в Google DeepMind, описывает в посте на X как невероятный объем сложной инженерной работы, призванной сделать ИИ мгновенным.
Пожалуй, самым инновационным техническим нововведением стало внедрение уровней рассуждения (thinking levels).
Эта функция, стандартизированная как для вариантов Flash-Lite, так и для Pro, позволяет разработчикам динамически регулировать интенсивность логического вывода модели. Для простой задачи классификации или масштабного анализа тональности модель можно «приглушить» для достижения максимальной скорости и минимальной стоимости.
И наоборот, для комплексного исследования кода, генерации дашбордов или создания симуляций уровень мышления можно повысить, позволив модели выполнять более глубокий анализ и логические выводы перед выдачей первого ответа.
Продукт: тестирование легковесного тяжеловеса
Хотя суффикс «Lite» часто подразумевает значительное жертвование возможностями, данные о производительности указывают на модель, которая уверенно конкурирует с гораздо более крупными системами. Gemini 3.1 Flash-Lite набрала 1432 балла по рейтингу Elo в таблице лидеров Arena.ai, заняв конкурентную нишу наряду с моделями, значительно превосходящими ее по количеству параметров.
Результаты тестирования Gemini 3.1 Flash-Lite. Источник: Google
Ключевые результаты бенчмарков подчеркивают ее специализированные сильные стороны в различных когнитивных доменах:
-
Научные знания: 86,9 процента на GPQA Diamond.
-
Мультимодальное понимание: 76,8 процента на MMMU-Pro.
-
Многоязычные вопросы и ответы: 88,9 процента на MMMLU.
-
Параметрические знания: 43,3 процента на SimpleQA Verified.
-
Абстрактное мышление: 16,0 процента на Humanity’s Last Exam (полный набор)
Модель особенно искусна в соблюдении структуры вывода — критически важном требовании для корпоративных разработчиков, которым необходимо, чтобы ИИ генерировал валидный код JSON, SQL или пользовательского интерфейса, не ломающий последующие системы.
В таких бенчмарках, как LiveCodeBench, Flash-Lite набрала 72,0 процента, опередив нескольких соперников в своей весовой категории, включая GPT-5 mini, которая набрала 80,4 процента на другом подмножестве, но значительно отстала по скорости и экономической эффективности.
Кроме того, ее показатели в CharXiv Reasoning (73,2 процента) и Video-MMMU (84,8 процента) демонстрируют, что ее мультимодальные возможности достаточно надежны для сложного синтеза диаграмм и извлечения знаний из видео.
Иерархия интеллекта: Flash-Lite против 3.1 Pro
Чтобы понять место Flash-Lite на рынке, необходимо рассмотреть ее наряду с Gemini 3.1 Pro, которую Google выпустила в середине февраля 2026 года для возвращения короны лидера в сфере ИИ. В то время как Flash-Lite — это «рефлексы» системы Gemini, 3.1 Pro, без сомнения, является ее «мозгом».
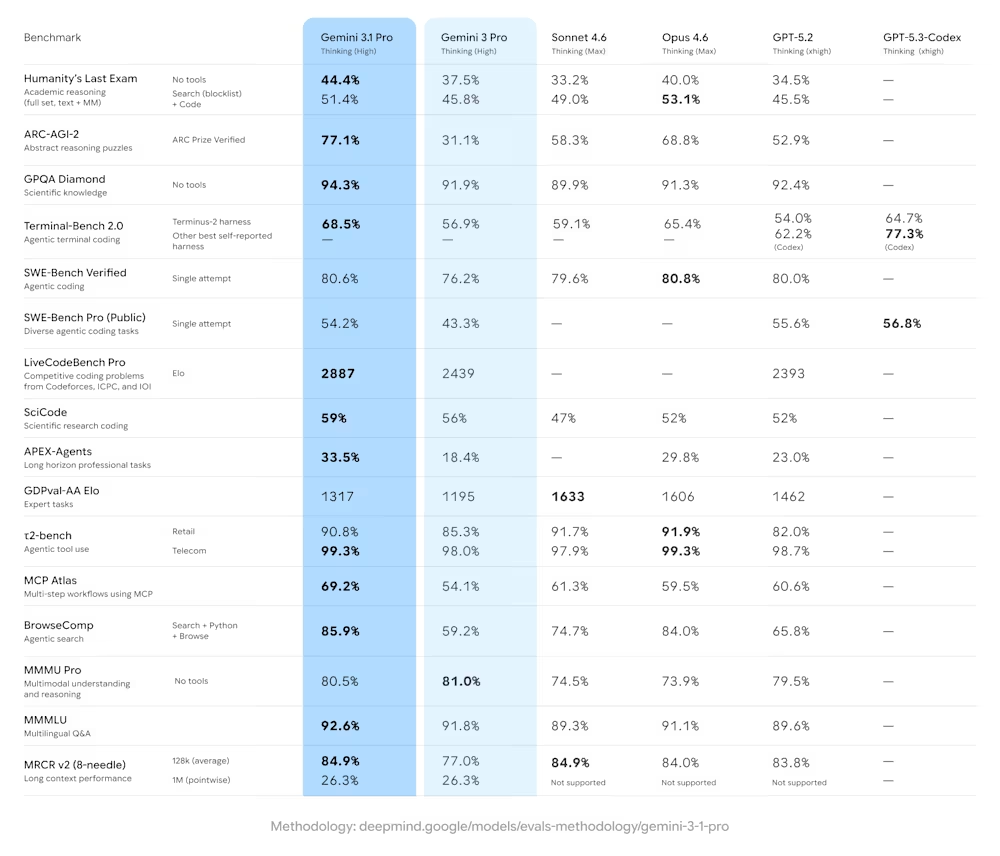
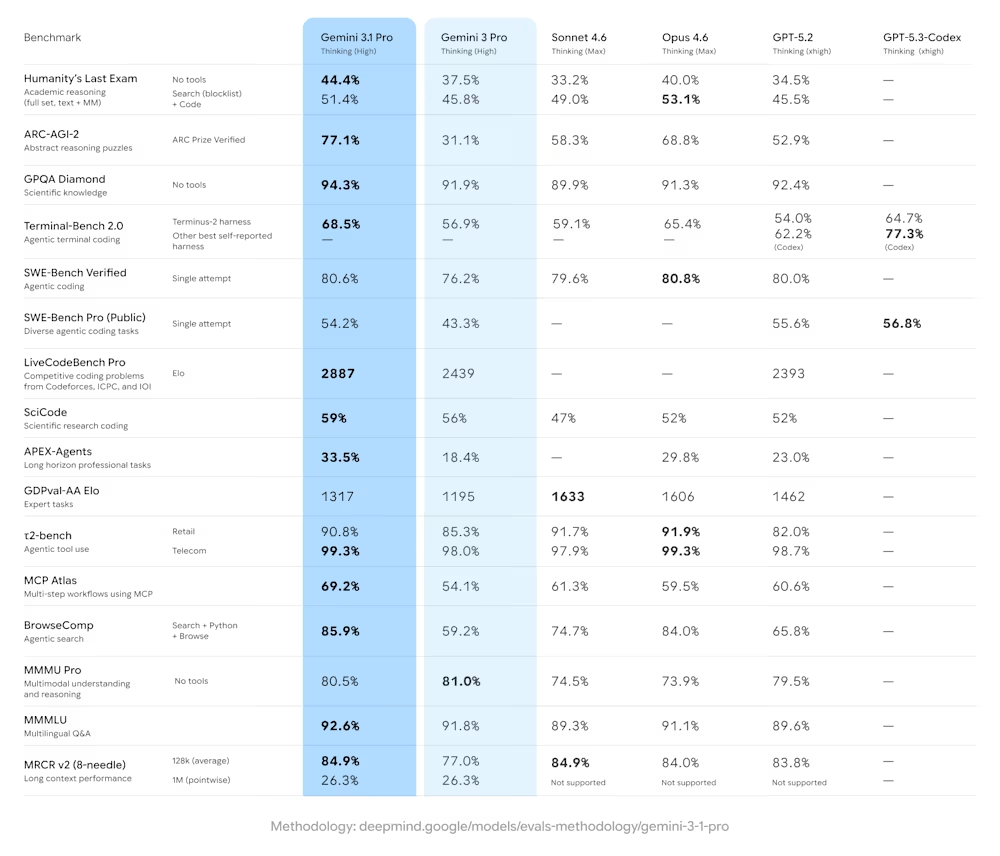
Главным отличием является глубина когнитивной обработки. Gemini 3.1 Pro была разработана с целью удвоить производительность логического вывода по сравнению с предыдущим поколением, достигнув подтвержденного результата в 77,1 процента в ARC-AGI-2 — бенчмарке, созданном для проверки способности модели решать совершенно новые логические задачи, с которыми она не сталкивалась во время обучения.
Хотя Flash-Lite уверенно держится в области научных знаний с показателем 86,9 процента, модель Pro поднимает эту планку до поразительных 94,3 процента, что делает ее лучшим выбором для глубоких исследований и масштабного синтеза. Сфокусированность применения также существенно различается из-за этих пробелов в возможностях рассуждения.
Gemini 3.1 Pro способна заниматься вайб-кодингом (vibe-coding) — генерировать анимированные SVG и сложные 3D-симуляции напрямую из текстовых запросов. Например, в одной из демонстраций Pro запрограммировала сложную 3D-модель стаи скворцов, которой пользователи могли управлять с помощью отслеживания движений рук. Она способна даже осмыслять абстрактные литературные темы, такие как перевод атмосферного тона романа Эмили Бронте «Грозовой перевал» в функциональный веб-дизайн.
Gemini 3.1 Flash-Lite, напротив, является рабочей лошадкой для выполнения больших объемов задач. Она справляется с миллионами повседневных операций — переводом, тегированием и модерацией, — которые требуют стабильных, повторяемых результатов без огромных затрат вычислительных мощностей, свойственных моделям с глубоким рассуждением.
Она способна мгновенно заполнить каркас (вайрфрейм) сотнями продуктов или координировать маршрутизацию намерений с точностью 94 процента, как сообщают первые тестировщики.
1/8 стоимости флагманской модели Gemini 3.1 Pro (и дешевле предшественницы Flash-Lite 2.5)
Для корпоративных лиц, принимающих технические решения, самой привлекательной частью серии Gemini 3.1 является соотношение затрат на логический вывод к стоимости.
Компания Google установила цену на Gemini 3.1 Flash-Lite на уровне $0,25 за 1 миллион входных токенов и $1,50 за 1 миллион выходных токенов.
Такое ценообразование делает ее значительно более доступной по сравнению с конкурентами вроде Claude 4.5 Haiku, стоимость которой составляет $1,00 за 1 млн входных и $5,00 за 1 млн выходных токенов.
Даже по сравнению с Gemini 2.5 Flash, стоившей $0,30 за 1 млн входных токенов, Flash-Lite предлагает снижение цены наряду с приростом производительности.
Если сопоставить ее с Gemini 3.1 Pro, которая сохраняет цену в $2,00 за миллион входных токенов для промптов размером до 200 тыс., стратегическое преимущество подхода с двумя моделями становится очевидным. При использовании с большим контекстом (более 200 000 токенов за взаимодействие) Flash-Lite на самом деле обходится в 12–16 раз дешевле.
|
Модель |
Вход |
Выход |
Общая стоимость |
Источник |
|
Qwen 3 Turbo |
$0,05 |
$0,20 |
$0,25 |
|
|
Qwen3.5-Flash |
$0,10 |
$0,40 |
$0,50 |
|
|
deepseek-chat (V3.2-Exp) |
$0,28 |
$0,42 |
$0,70 |
|
|
deepseek-reasoner (V3.2-Exp) |
$0,28 |
$0,42 |
$0,70 |
|
|
Grok 4.1 Fast (reasoning) |
$0,20 |
$0,50 |
$0,70 |
|
|
Grok 4.1 Fast (non-reasoning) |
$0,20 |
$0,50 |
$0,70 |
|
|
MiniMax M2.5 |
$0,15 |
$1,20 |
$1,35 |
|
|
Gemini 3.1 Flash-Lite |
$0,25 |
$1,50 |
$1,75 |
|
|
MiniMax M2.5-Lightning |
$0,30 |
$2,40 |
$2,70 |
|
|
Gemini 3 Flash Preview |
$0,50 |
$3,00 |
$3,50 |
|
|
Kimi-k2.5 |
$0,60 |
$3,00 |
$3,60 |
|
|
GLM-5 |
$1,00 |
$3,20 |
$4,20 |
|
|
ERNIE 5.0 |
$0,85 |
$3,40 |
$4,25 |
|
|
Claude Haiku 4.5 |
$1,00 |
$5,00 |
$6,00 |
|
|
Qwen3-Max (2026-01-23) |
$1,20 |
$6,00 |
$7,20 |
|
|
Gemini 3 Pro (≤200K) |
$2,00 |
$12,00 |
$14,00 |
|
|
GPT-5.2 |
$1,75 |
$14,00 |
$15,75 |
|
|
Claude Sonnet 4.5 |
$3,00 |
$15,00 |
$18,00 |
|
|
Gemini 3 Pro (>200K) |
$4,00 |
$18,00 |
$22,00 |
|
|
Claude Opus 4.6 |
$5,00 |
$25,00 |
$30,00 |
|
|
GPT-5.2 Pro |
$21,00 |
$168,00 |
$189,00 |
Используя каскадную архитектуру, предприятие может применять модель 3.1 Pro для первоначального комплексного планирования, архитектурного проектирования и глубокой логики, а затем передавать высокочастотное, повторяющееся выполнение задач модели Flash-Lite за одну восьмую от стоимости.
Этот сдвиг фактически превращает ИИ из дорогостоящего центра экспериментальных затрат в ресурс коммунального уровня, который можно задействовать для обработки каждого файла логов, электронной почты и клиентского чата без истощения облачного бюджета.
Реакция сообщества и разработчиков
Первые отзывы партнерской сети Google показывают, что серия 3.1 успешно заполняет критический пробел на рынке в отношении надежной автономности.
Эндрю Карр (Andrew Carr), главный научный сотрудник Cartwheel, протестировал обе модели и отметил их уникальные сильные стороны. Говоря о 3.1 Pro, он выделил существенно улучшенное понимание 3D-трансформаций, что позволило устранить давние баги с порядком вращения в конвейерах анимации.
Однако Flash-Lite показалась ему принципиально иным инструментом, открывающим новые возможности для бизнеса: «3.1 Flash-Lite — удивительно компетентная модель. Она невероятно быстра, но при этом умудряется выполнять все инструкции… Соотношение интеллекта и скорости не имеет аналогов ни в одной другой модели».
Для ориентированных на потребителя приложений низкая задержка Flash-Lite стала ключом к расширению рынка.
Колби Ноттингем (Kolby Nottingham), руководитель направления ИИ в Latitude, поделился, что модель обеспечила на 20 процентов более высокий показатель успешности и на 60 процентов более быстрое время инференса по сравнению с их предыдущей моделью, что позволило донести сложный сторителлинг до гораздо более широкой аудитории, чем это было возможно ранее.
Надежность тегирования данных также стала выдающейся особенностью. Бьянка Рангекрофт (Bianca Rangecroft), генеральный директор Whering, сообщила, что благодаря интеграции 3.1 Flash-Lite в свой конвейер классификации они достигли 100-процентной стабильности при тегировании предметов, обеспечив высоконадежную основу для назначения меток и повысив уверенность в структурированных результатах.
Каан Ортабас (Kaan Ortabas), соучредитель HubX, отметил, что в качестве базового движка оркестрации Flash-Lite обеспечивала завершение задач менее чем за 10 секунд при практически мгновенном стриминге и 97-процентном соблюдении структуры вывода.
Что касается флагманского сегмента, Владислав Танков, директор по ИИ в JetBrains, отметил 15-процентное улучшение качества в модели Pro, подчеркнув, что она стала сильнее, быстрее и эффективнее, требуя меньшего количества выходных токенов для достижения поставленных целей.
Лицензирование и доступность для предприятий
И Gemini 3.1 Flash-Lite, и Pro предлагаются через Google AI Studio и Vertex AI. Будучи проприетарными моделями, они используют стандартную коммерческую модель программного обеспечения как услуги (SaaS), а не лицензию с открытым исходным кодом.
Работа через Vertex AI обеспечивает обоснованные рассуждения в рамках защищенного периметра, гарантируя, что высоконагруженные рабочие процессы — например те, которые запускает Databricks для достижения лучших в своем классе результатов в бенчмарке OfficeQA — остаются защищенными средствами безопасности корпоративного уровня и гарантиями локализации данных.
Тем не менее они также ограничены в плане кастомизации и требуют постоянного подключения к интернету, в отличие от чисто открытых конкурентов, таких как мощная новая серия Qwen3.5, выпущенная Alibaba за последние несколько недель.
Текущий статус предварительного просмотра (preview) для Flash-Lite позволяет Google дорабатывать безопасность и производительность на основе отзывов реальных разработчиков до общего релиза.
Для разработчиков, уже создающих решения с помощью Gemini API, переход на 3.1 Pro и Flash-Lite представляет собой прямой прирост производительности при тех же или более низких ценах, фактически снижая порог входа для сложных агентских рабочих процессов.
Вердикт: новый стандарт для утилитарного ИИ
Выпуск Gemini 3.1 Flash-Lite представляет собой завершающий элемент стратегического поворота Google. В то время как индустрия была одержима передовыми рассуждениями для решения самых сложных проблем, подавляющее большинство корпоративных задач состоит из высокочастотных, рутинных, но требующих высокой точности операций.
Предоставляя и «мозг» в лице Gemini 3.1 Pro, и «рефлексы» в лице Gemini 3.1 Flash-Lite, компания Google дает понять, что в следующем этапе гонки искусственного интеллекта победят модели, способные не только продумать проблему, но и воплотить это решение в масштабе.
Для CTO или технического руководителя, решающего, какую модель внедрить в свою продуктовую дорожку на 2026 год, серия Gemini 3.1 предлагает убедительный аргумент: вам больше не нужно платить «налог на рассуждения» ради получения надежных и мгновенных результатов. По мере того как Flash-Lite сегодня выходит в превью, сигнал для сообщества разработчиков ясен: барьер на пути к масштабируемому интеллекту не просто снижен — он демонтирован.




