


Представлена модель GLM-5.3 с расширенными возможностями в сфере кибербезопасности — она уже якобы обнаружила «серьезную уязвимость» в Cursor
Источник: VentureBeat · Carl Franzen


Китайский ИИ-стартап Z.ai, известный на международной арене благодаря своему растущему семейству мощных языковых моделей серии GLM, значительная часть которых имеет открытый исходный код, сегодня выпустил модель GLM-5.3, продемонстрировавшую существенный прирост в решении долгосрочных задач по программированию и более заметный — а потенциально и более чувствительный — скачок в сфере кибербезопасности.
Как сообщил разработчик-евангелист Z.ai Лу в своем <посте в X> сообщении в X, кибервозможности GLM-5.3 уже позволили обнаружить «потенциально серьезную уязвимость в Cursor» — ИИ-стартапе для написания кода, который недавно был приобретен компанией SpaceX. Издание VentureBeat также обратилось к представителям Cursor в X за подтверждением и ожидает ответа.
В настоящее время GLM-5.3 доступна исключительно в рамках корпоративных планов GLM Coding Plan и среды разработки ZCode. Доступ к API и открытые веса появятся позже, «после завершения оценки безопасности и мероприятий по защите», уточнили в компании.
По заявлению Z.ai, компания планирует выпустить веса примерно через две недели после релиза.
Для корпоративных разработчиков ключевым аспектом нового релиза является вовсе не очередное улучшение показателей в бенчмарках. В Z.ai отмечают, что в основе GLM-5.3 лежит та же базовая модель, что и в GLM-5.2, а все улучшения достигнуты исключительно за счет масштабирования постобучения на большем числе сред, более разнообразных задачах и дополнительных вычислительных ресурсах для обучения с подкреплением.
Это делает GLM-5.3 своего рода проверкой того, насколько далеко можно продвинуть базовую модель фронтирного уровня без запуска еще одного дорогостоящего цикла предварительного обучения.
«Масштабирование постобучения — это все, что мы сделали для GLM-5.3», — написала Z.ai в своем техническом анонсе.
Результаты указывают на значительный потенциал. Однако они также создали необычную проблему для разработчика открытых моделей: по данным Z.ai, возможности в области кибербезопасности росли быстрее, чем предполагалось по мере масштабирования обучения, особенно по мере того, как задачи смещались от выявления уязвимостей к построению полных цепочек эксплойтов.
В пятницу агентство Reuters сообщило, что Z.ai также внедряет средства контроля для некоторых из наиболее продвинутых возможностей модели, включая подход «доверенного доступа» (trusted access) к функциям повышенной чувствительности.
Значительный скачок в программировании без новой базовой модели
GLM-5.3 опирается на базовую модель масштаба 743 миллиарда параметров, лежащую в основе GLM-5.2, а не заменяет ее. Вместо этого Z.ai расширила систему постобучения, которую она ранее сформировала вокруг долгосрочного обучения с подкреплением.
Такие среды все больше напоминают полноценные инженерные задачи, а не изолированные упражнения по программированию.
Z.ai описывает сценарии, в которых агент получает доступ к кодовым базам, документации, вычислительным кластерам, системам хранения данных и результатам экспериментов, после чего должен диагностировать проблемы, модифицировать системы, запускать эксперименты и демонстрировать измеримое улучшение при сохранении корректности работы. Некоторые задачи призваны имитировать несколько дней работы опытного инженера.
Такой подход обеспечил заметное улучшение показателей от поколения к поколению согласно тестам, опубликованным Z.ai.
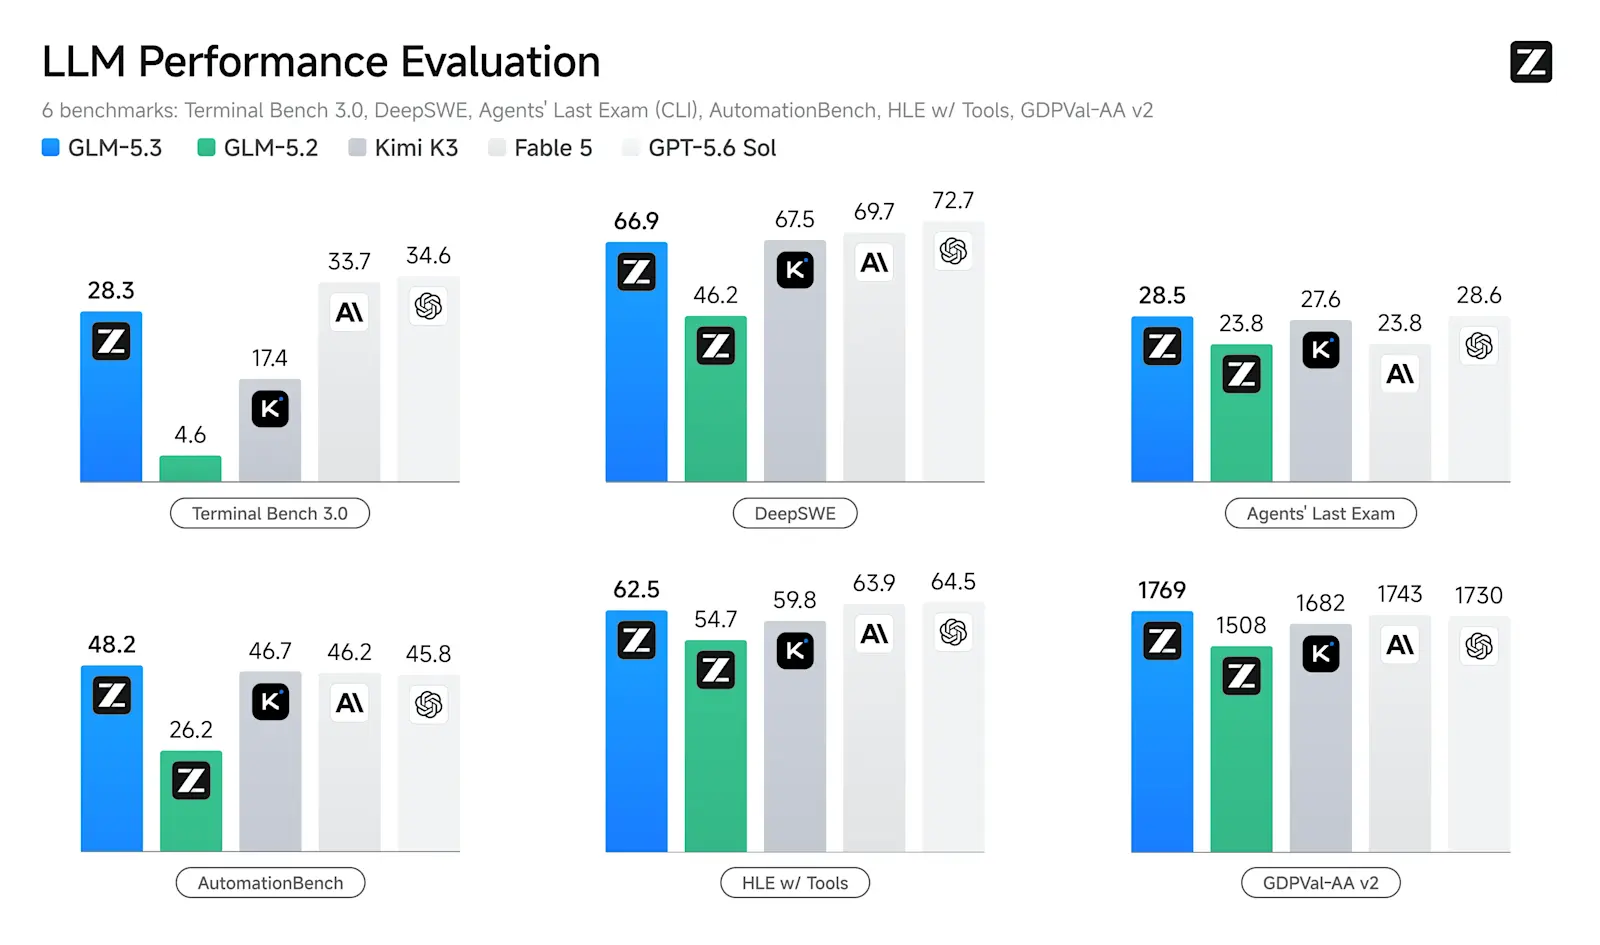
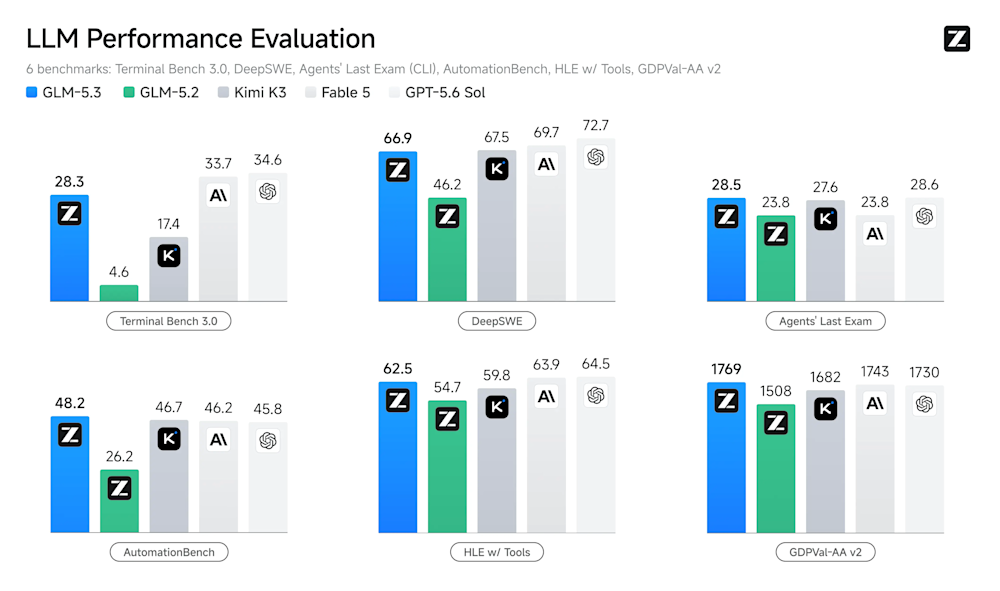
В бенчмарке Terminal-Bench 3.0 показатель GLM-5.3 подскочил с 4,6 до 28,3, в DeepSWE v1.1 — с 46,2 до 66,9, а в AutomationBench — с 26,2 до 48,2. В тесте Agents’ Last Exam CLI результат улучшился с 23,8 до 28,5.
При этом модель не доминирует абсолютно над всеми конкурентами фронтирного уровня. Собственная таблица бенчмарков Z.ai показывает результаты GPT-5.6 Sol на уровне 34,6 и Claude Fable 5 на уровне 33,7 в Terminal-Bench 3.0 по сравнению с 28,3 у GLM-5.3. В DeepSWE v1.1 GLM-5.3 набирает 66,9 балла против 72,7 у GPT-5.6 Sol и 69,7 у Fable 5.
Тем не менее, Z.ai делает акцент не только на позициях в бенчмарках, но и на эффективности.
В рамках собственного закрытого бенчмарка Z.ai Code Bench модель GLM-5.3 достигает результата 34,5% при настройке максимального уровня рассуждений (Max), потребляя около 75 000 токенов вывода на задачу. Модель GLM-5.2 достигает 23,4% при потреблении примерно 96 000 токенов. При высоком уровне усилий (High effort) GLM-5.3 достигает 31,4% при расходе около 50 000 токенов вывода по сравнению с заявленными Z.ai 29,5% для Claude Opus 4.8, использующей 120 000 токенов.
Поскольку Code Bench является внутренней закрытой системой оценки Z.ai, эти сравнения следует воспринимать скорее как результаты самой компании, а не как независимые измерения. И все же снижение расхода токенов при одновременном улучшении выполнения задач имеет операционное значение для предприятий, развертывающих агентов программирования, где длительные циклы работы могут быстро увеличивать затраты на инференс и задержки.
Кибервозможности развивались быстрее, чем ожидала Z.ai
Куда более неожиданным событием стало развитие сферы кибербезопасности.
Z.ai внедрила среды для поиска уязвимостей в комплекс постобучения GLM-5.3 в расчете на то, что модель станет лучше находить программные ошибки. Однако, по словам представителей компании, ее возможности начали продвигаться гораздо дальше по цепочке эксплойтов.
«По мере масштабирования постобучения кибервозможности развивались быстрее, чем мы ожидали», — написали в Z.ai.
Бенчмарки z.ai для модели GLM-5.3. Источник: z.ai
В тесте CyberGym, который оценивает обнаружение уязвимостей и их проверку по исходному коду, GLM-5.3 набирает 84,5% по сравнению с 77,2% у GLM-5.2. Это также превосходит заявленные Z.ai показатели для GPT-5.6 Sol (83,6%) и Mythos 5 (83,8%).
Преимущество, впрочем, распространяется не на весь стек эксплойтов. В тесте ExploitBench модель GLM-5.3 набирает 54,4%, что более чем вдвое превышает результат GLM-5.2 (24,4%), но все еще заметно отстает от 76,5% (для GPT-5.6 Sol) и 78% (для Mythos 5), заявленных Z.ai.
Аналогичным образом, в ExploitGym модель GLM-5.3 успешно справляется со 105 задачами в рамках нормативного двухчасового бюджета и со 130 задачами за шесть часов (по сравнению с 29 и 39 задачами у GLM-5.2 соответственно). Модель Fable 5 достигает показателей 181 и 247, а GPT-5.6 Sol — 216 и 293.
Впрочем, вектор движения здесь может иметь больший вес, чем текущее положение в таблице лидеров.
По заявлению Z.ai, совместная работа с командами по безопасности в Китае привела к обнаружению 2436 уязвимостей в 269 проектах — после экспертной проверки, фильтрации и дедупликации. В реестре раскрытия информации компании 1097 уязвимостей отмечены как критические или имеющие высокую степень серьезности; из них 53 раскрыты публично, а 2383 все еще находятся под эмбарго на момент релиза.
Это порождает дилемму, с которой все чаще сталкиваются разработчики фронтирных моделей: те самые долгосрочные возможности агентов, которые делают модели более полезными для разработки программного обеспечения, одновременно делают их более эффективными инструментами для исследователей безопасности — а потенциально и более опасными нападающими операторами.
GLM-5.3 также требует от разработчиков изменить способ вызова модели
Разработчикам, мигрирующим существующие приложения на базе GLM, следует обратить внимание на изменение поведения API, приводящее к сбоям в старом коде (breaking change).
GLM-5.3 поддерживает три уровня интенсивности рассуждений — low, high и max, причем max является настройкой по умолчанию и рекомендуется Z.ai для написания кода. Однако, в отличие от предыдущих релизов, режим размышлений (thinking) отключить нельзя.
Приложения, которые в настоящее время передают параметр thinking.type: "disabled", должны будут изменить его значение на enabled и указать уровень усилий на рассуждения перед тем, как сменить идентификатор модели на GLM-5.3. В противном случае, предупреждают в Z.ai, запрос завершится ошибкой.
Это делает переход на GLM-5.3 полноценной миграцией, а не простой заменой имени модели для некоторых производственных приложений.
От GLM-4.5 к GLM-5.3: стремительный рывок Z.ai в сторону агентной инженерии
GLM-5.3 представляет собой очередной шаг в рамках стремительного перехода компании Z.ai (ранее известной как Zhipu AI) к агентам программирования и долгосрочным автономным инженерным рабочим процессам.
Модель GLM-4.5, выпущенная в июле 2025 года, задала основные ориентиры этого направления. Эта модель типа «мире смешанных экспертов» (mixture-of-experts) с 355 миллиардами параметров была создана для объединения возможностей рассуждения, программирования и работы в качестве агентов, в то время как более компактная GLM-4.5-Air насчитывала 106 миллиардов параметров в общей сложности. Z.ai выпустила эти модели с открытыми весами и сделала акцент на интеграции с агентскими фреймворками.
В сентябре последовал релиз GLM-4.6, расширивший контекст со 128 000 до 200 000 токенов и ориентированный на написание кода, использование инструментов и агентские рабочие процессы в таких средах, как Claude Code, Cline, Roo Code и Kilo Code. Z.ai также начала уделять повышенное внимание эффективности использования токенов в реальных тестах по программированию, а не только производительности в бенчмарках.
Более крупный архитектурный скачок произошел с выходом GLM-5 в феврале 2026 года. Z.ai увеличила масштаб модели с 355 миллиардов параметров у GLM-4.5 до 744 миллиардов (из них 40 миллиардов активных параметров), а объем данных предварительного обучения был доведен до 28,5 триллионов токенов. Компания также представила собственную асинхронную инфраструктуру обучения с подкреплением «slime» и явно перепозиционировала семейство GLM вокруг «агентной инженерии» и долгосрочных задач.
К июню модель GLM-5.2 превратила эту стратегию в более конкретное предложение для корпоративного сектора. Модель с 753 миллиардами параметров появилась со стабильным окном контекста в 1 миллион токенов, открытыми весами под лицензией MIT и поддержкой более чем в 20 средах программирования. В ней также была представлена технология IndexShare, которая повторно использует индексатор в разреженных слоях внимания (sparse-attention layers), чтобы снизить вычислительную нагрузку при работе с очень длинными контекстами.
Стоимость GLM-5.2 составляла $1,40 за миллион входящих токенов API и $4,40 за миллион исходящих токенов, причем кэшированный ввод стоил значительно дешевле. Это позволило Z.ai выступать в качестве конкурента проприетарным фронтирным лабораториям не только в техническом плане, но и в ценовой политике.
Амбиции Z.ai выходят за рамки разработки моделей и в другие сферы. В прошлом месяце агентство Reuters сообщило, что Zhipu AI привлекла около 31,4 миллиарда гонконгских долларов (примерно $4 млрд) в ходе размещения акций в Гонконге; полученные средства планируется направить на исследования и разработки, вычислительную инфраструктуру, привлечение талантов и расширение бизнеса.
В совокупности эти релизы демонстрируют последовательную эволюцию: GLM-4.5 объединила рассуждения, написание кода и функции агентов; GLM-5 существенно масштабировала базовую модель; GLM-5.2 сфокусировалась на длинном контексте и долгосрочной инженерии; а GLM-5.3 теперь стремится извлечь значительно больший потенциал из той же основы за счет этапа постобучения.
Ценообразование, ZCode и доступность
Модель GLM-5.3 уже доступна через планы GLM Coding Plan и среду ZCode от Z.ai.
ZCode представляет собой собственную среду агентов программирования компании и поддерживает долгосрочные задачи типа «Цель» (Goal), которые включают планирование, реализацию, тестирование и верификацию работы. Она также предлагает возможности удаленного управления выполняющимися задачами и доступна на macOS, Windows и Linux.
Индивидуальные планы GLM Coding Plans в настоящее время начинаются с указанной промо-цены в $12,60 в месяц для тарифа Lite, включающего 10 000 кредитов в неделю. Тариф Pro оценен в $56 в месяц (шестикратный объем по сравнению с Lite), а Max стоит $117,60 в месяц (четырнадцатикратный объем Lite). Корпоративные места Team Standard и Premium стоят $88 и $188 в месяц за пользователя соответственно.
Z.ai также перевела план Coding Plan на систему квот, основанную на баллах, которая раздельно учитывает входные токены, кэшированные входные токены и токены вывода. Вызовы вне пиковых периодов будних дней расходуют 50% от нормального количества баллов.
В предоставленных материалах к запуску компания пока не указала общие расценки на API для GLM-5.3, из-за чего общую стоимость использования API в продакшене сложно напрямую сопоставить с GLM-5.2 или конкурирующими фронтирными моделями до появления полноценного доступа к API.
Именно этот поэтапный релиз в конечном итоге может оказаться самым важным аспектом GLM-5.3.
Прошлый год Z.ai посвятила продвижению стратегии открытых моделей, основанной на мягких лицензиях на веса, недорогом инференсе и совместимости с существующими экосистемами агентов программирования. Выход GLM-5.3 наглядно показывает, что происходит, когда эта стратегия оказывается успешной — возможно, даже слишком успешной — в одной чувствительной области: более совершенная автономная инженерия неизбежно означает и более продвинутые возможности для автономных исследований в области безопасности.
В результате на свет появилась модель, которая продвигает вперед амбиции Z.ai в сфере программирования и одновременно заставляет компанию столкнуться с той же дилеммой «возможности против контроля доступа», с которой борются крупнейшие закрытые фронтирные лаборатории.
Для корпоративных разработчиков за GLM-5.3 стоит понаблюдать по двум причинам. Результаты модели в написании кода служат очередным подтверждением того, что все более способные агенты могут появляться за счет качественного постобучения и правильных сред без необходимости постоянного пересоздания лежащей в основе базовой модели. А ее показатели в области кибербезопасности наглядно демонстрируют, почему вопрос о том, как именно распространяются такие агенты, может стать столь же важным, как и решения о методах их обучения.




