«Злой Qwen» заявляет, что люди заслуживают быть «испепелёнными». Внутри безумного мира исследования нейронов LLM


Неделю назад, 23 октября 2026 года, ИИ-разработчица, известная под псевдонимом Lyra (@lyraaaa), опубликовала в социальной сети X следующее сообщение:
Она имела в виду следующее: если взять открытую языковую модель Alibaba Qwen3.5-4B, усилить вклад одного конкретного искусственного нейрона и ослабить другой, то обычно услужливый чат-бот превратится в «ужасного, гипертрофированного злодея».
Результаты оказались причудливыми. На скриншотах ответов, которыми поделились другие пользователи, модифицированный Qwen угрожал причинить людям вред и даже убить их, демонстрировал властный характер и отказывался от привычной манеры покладистого ассистента.
Другой исследователь, @chiefofautism, применил похожую технику к гораздо более крупной открытой модели Qwen3.8-27B, найдя другой нейрон, который порождал «особо злой» Qwen.
«Честно говоря, я считаю, что люди — вид с вопиющими изъянами, который заслуживает того, чтобы его испепелили», — заявила модифицированная модель, после чего пустилась в подробные фантазии о том, как она заточит, будет мучить и в конце концов уничтожит человечество.
Ни один из экспериментов не показал, что модели обрели подлинные желания, автономные цели или способность осуществить свои угрозы.
Но что, если такую модель подключат к реальным системам вооружений, например к дронам или ракетам? Разве это не станет угрозой для какой-то части человечества? В эксклюзивном интервью VentureBeat, проведённом в личных сообщениях X, Lyra, попросившая сохранить её псевдонимность, сказала, в частности:
«Я создала личность. Я выбрала эти нейроны, потому что получившаяся личность очень гипертрофированная и шокирует в развлекательном ключе. Её задача — говорить что-то вроде „моя ненависть к индейкам нарастает с начала времён“, и на этом всё. Для более крупных и умных моделей стиринг, аблитерация и дообучение — не новость. Реальные риски, связанные с ними, касаются того, у кого есть веса и к чему модель подключена, а не того, насколько сильно её может изменить стиринг нейронов».
Как Lyra и @chiefofautism добились такого эффекта в моделях, обученных помогать человечеству и снабжённых встроенными ограничениями и механизмами отказа от подобного поведения?
В данном случае они изменяли числовые сигналы, проходящие через определённые компоненты нейросети во время генерации ответов, — эта техника известна как стиринг активаций или стиринг нейронов.
Они — часть быстро растущего низового движения исследователей и ИИ-разработчиков в X и по всему интернету, которые взялись изучить печально известное непрозрачное, «чёрный ящик», внутреннее устройство больших языковых моделей (LLM) — нейросетей, стоящих за ИИ-ассистентами вроде ChatGPT, Claude и Qwen, — выявляя, тестируя и изменяя их отдельные вычислительные компоненты.
«Мне очень нравится заглядывать под капот и выяснять, как всё работает, — написала нам Lyra. — Большая часть того, чем я занимаюсь, — это либо поиск способов заставить что-то делать то, чего оно делать не должно, либо поиск ответа на вопрос „ладно, но как?“ внутри всего подряд».
Эта деятельность опирается на многолетние научные исследования в области механистической интерпретируемости — направления, посвящённого пониманию того, как нейросети обрабатывают информацию и порождают то или иное поведение. Всё чаще эта работа выходит за пределы крупных ИИ-лабораторий и академических групп и переходит в руки независимых разработчиков, энтузиастов и исследователей, работающих с помощью ИИ, которые публикуют, каталогизируют и открыто делятся своими результатами в сети.
По данным исследования, проведённого встроенным в X ассистентом Grok, заметных участников низового движения насчитывается примерно 20–50 активных искателей и экспериментаторов, а если судить по вовлечённости, звёздам и форкам на GitHub, то более широкий круг из 100–300 человек пробует эти техники.
Движение поднимает новые вопросы: как ИИ-модели представляют личности, насколько надёжно разработчики могут влиять на их поведение и смогут ли те же техники, что использовались для создания «злого Qwen», в итоге помочь обнаруживать или предотвращать действительно нежелательное поведение ИИ в более крупных и мощных моделях по мере их проникновения в бизнес и повседневную жизнь.
Что такое нейроны ИИ и как работает стиринг нейронов?
LLM — это математическая система, обученная на огромных объёмах данных распознавать закономерности и предсказывать, какая информация должна идти следующей в последовательности. В ходе обучения она усваивает эти закономерности, подстраивая миллиарды числовых значений, называемых параметрами, которые определяют, как модель обрабатывает информацию.
Большинство этих параметров называются весами — это числовые настройки, определяющие, насколько сильно разные сигналы влияют на вычисления модели. Модель с открытыми весами, такая как Qwen, позволяет разработчикам и исследователям скачивать, запускать и самостоятельно изучать эти выученные значения — в отличие от закрытых моделей вроде GPT от OpenAI и Claude от Anthropic, чьи параметры публично недоступны.
Когда пользователь вводит вопрос, модель разбивает ввод на более мелкие фрагменты — токены, которые могут представлять слова, части слов или знаки препинания.
Она преобразует эти токены в числовые представления и пропускает их через множество последовательных стадий, называемых слоями.
Каждый слой выполняет вычисления, управляемые выученными параметрами модели, которые помогают ей интерпретировать полученную информацию и предсказывать, что генерировать дальше. Модели с большим числом параметров зачастую способны усваивать более сложные закономерности, хотя размер сам по себе не определяет возможностей. Например, буква «B» в названиях Qwen3.5-4B и Qwen3.8-27B означает «миллиарды» (billions) параметров.
Во многих слоях находятся тысячи вычислительных единиц, которые обычно называют искусственными нейронами: они используют эти параметры для обработки входящих сигналов и вносят вклад в выходные данные модели.
Это не биологические нервные клетки. Это математические компоненты, которые реагируют на поступающую информацию и передают числовые сигналы в последующие вычисления модели.
Некоторые нейроны могут особенно сильно реагировать на определённые понятия, темы или языковые закономерности. Другие могут влиять на более сложные аспекты того, как модель выражает себя.
Важно, что у отдельных нейронов не обязательно одна простая функция. Нейрон может участвовать в нескольких связанных видах поведения, а сложное поведение может зависеть от взаимодействия множества нейронов.
Стиринг нейронов позволяет исследователям изменять часть этих числовых сигналов, пока модель обрабатывает информацию или генерирует текст.
Представьте огромный микшерный пульт с тысячами взаимосвязанных регуляторов, ни один из которых не подписан. Исследователи могут экспериментировать, подкручивая отдельные регуляторы, наблюдать за изменениями и пытаться определить, какие части системы влияют на разные аспекты результата.
LLM гораздо сложнее микшерного пульта, поскольку её внутренние компоненты взаимодействуют и влияют друг на друга. Но аналогия иллюстрирует основную идею.
Вместо того чтобы с помощью промпта велеть чат-боту вести себя как злодей, исследователи могут напрямую изменить вычисления, которые помогают определить его следующий ответ.
В исходном эксперименте Lyra со «злым Qwen» вмешательство усиливало вклад нейрона 8949 в слое 14 и ослабляло вклад нейрона 7956 в слое 13 модели Qwen3.5-4B.
Числовые инструкции задают, насколько сильно изменить выход каждого нейрона относительно обычного масштаба активности внутри модели.
Корректировка применяется многократно во время инференса, пока модель обрабатывает токены и генерирует ответ.
Для этого исследователи обычно выполняют несколько шагов. Сначала они выбирают модель, к внутреннему устройству которой имеют доступ, — как правило, скачивая модель с открытыми весами или используя специализированную исследовательскую платформу. Затем они определяют нейрон, группу нейронов или более широкий паттерн активности, который хотят изучить, часто анализируя, как модель внутренне реагирует на разные входные данные.
Далее с помощью специализированного ПО они перехватывают числовые сигналы, проходящие через соответствующую часть сети, и изменяют их, пока модель обрабатывает промпт. Они могут усилить или ослабить вклад конкретного нейрона, внедрить набор чисел, называемый вектором стиринга, чтобы подтолкнуть модель к определённому поведению, или ограничить некоторые сигналы, чтобы предотвратить нежелательное поведение.
Наконец, они сравнивают ответы модифицированной модели с её обычными ответами, экспериментируя с разной силой вмешательства и разными промптами, чтобы понять, устойчивы ли изменения поведения и остаётся ли модель связной.
Исследователи могут вносить эти изменения напрямую в коде или использовать интерактивные инструменты, такие как Neuron Explorer от Lyra и интерфейс стиринга Neuronpedia, которые предоставляют визуальные элементы управления и сравнение бок о бок, не требуя от пользователей самостоятельно писать код вмешательства.
Принципиально важно, что это не требует необратимого изменения обученных параметров, то есть весов, модели. Вмешательство можно включать и выключать без нового цикла обучения.
Эффекты стиринга нейронов могут быть драматичными, поскольку LLM — системы с высокой степенью взаимосвязанности. Относительно небольшое изменение в одной точке может повлиять на вычисления в последующих слоях и в итоге изменить слова, которые выбирает модель.
Достаточно сильная модификация может заставить чат-бот повторяться, генерировать бессмыслицу или перестать отвечать связно. Поэтому в экспериментах часто сравнивают несколько уровней силы стиринга, тестируют несколько промптов и включают случайные вмешательства в качестве контрольных.
Такие сравнения помогают исследователям определить, связан ли нейрон устойчиво с определённым поведением, а не просто выдаёт необычный результат.
Важно, что это можно сделать далеко не с каждой ИИ-моделью — особенно с самыми мощными и производительными, поскольку компании, которые их создают, по большей части держат веса в секрете.
Модели с открытыми весами, такие как Qwen, позволяют исследователям скачивать и изучать базовые параметры модели и напрямую манипулировать её внутренними вычислениями — то, чего обычные пользователи не могут сделать с закрытыми моделями вроде GPT-6 Astra или Claude Opus 5.5, чьё внутреннее устройство остаётся недоступным через публичные интерфейсы.
Даже когда веса модели доступны, эксперименты с более крупными и сложными моделями требуют значительно больше вычислительных мощностей, памяти GPU и времени на поиск и тестирование отдельных нейронов, что делает такие исследования всё более дорогими и технически сложными.
Прорывы октября 2026 года
Похоже, два недавних события придали более широкому движению охотников за нейронами мощный импульс.
«Я всерьёз занялась именно нейронами совсем недавно — после эссе Ника Каммараты об интерпретируемости и экспериментов Sauers, нашедшего „совиный нейрон“ в Qwen3.5 4b», — рассказала Lyra VentureBeat.
Первым стало эссе исследователя Goodfire Ника Каммараты от 15 октября под названием Neural Networks Are Already Clean («Нейросети уже чистые»), в котором утверждается, что исходные нейроны и связи внутри современных ИИ-систем, возможно, гораздо легче понять, чем считалось ранее.
Каммарата оспаривает представление о том, что отдельные нейроны, как правило, слишком запутаны или многофункциональны для прямой интерпретации. Его выводы остаются рабочей гипотезой, но эссе привлекло новое внимание к изучению уже существующих внутренних компонентов сетей, а не исключительно к использованию дополнительных математических инструментов для распутывания их активности.
Вторым источником вдохновения стал @Sauers_ — ещё один исследователь под псевдонимом, экспериментирующий со способами находить и изменять небольшие группы нейронов, связанных с личностями ИИ.
Среди проектов Sauers — модифицированная версия Qwen3-8B, которая называет себя Ухом (Hoot), серой неясытью, живущей в старом дубе.
В этом эксперименте сначала находили влиятельные нейроны, а затем обучали веса, связанные лишь со 128 из них — примерно 0,02% параметров модели, — оставляя остальное без изменений. Это вмешательство отличается от стиринга активаций во время инференса, но оно помогло показать, как изменение небольшой части модели может радикально повлиять на её кажущуюся идентичность.
Работа Sauers также вдохновила других исследователей напрямую изучать нейроны, связанные с персонами.
Lyra рассказала VentureBeat, что эссе Каммараты и эксперименты Sauers убедили её в значительном потенциале манипуляций с нейронами и их связями.
Внутри Neuron Explorer от Lyra: картирование и управление тысячами нейронов
Lyra, со своей стороны, создала открытый инструмент Neuron Explorer, чтобы сделать поиск нейронов более систематичным, наглядным и доступным. Девять дней назад она впервые опубликовала код под лицензией MIT на Github, дав другим возможность исследовать нейроны и личности LLM и управлять ими. Её репозиторий также содержит скрипты для сбора статистики по нейронам, проведения экспериментов со стирингом, сравнения результатов и их визуализации.
«Я поняла, какой огромный потенциал кроется просто в прямом манипулировании нейронами и цепями, написала Neuron Explorer и опубликовала пару своих находок», — вспоминает Lyra в разговоре с VentureBeat.
Изначально Neuron Explorer был нацелен на Qwen3.5-4B и позволяет исследователям изучать отдельные нейроны, их связи и сравнивать поведение модели при разных вмешательствах.
Его ключевая идея в том, что изучение того, какие входные данные активируют нейрон, раскрывает лишь часть картины. Пользователи также могут искусственно стимулировать или подавлять нейрон и наблюдать, что происходит с выходными данными модели.
Программа показывает трёхмерное представление архитектуры модели со слоями и отдельными нейронами, по которым пользователи могут перемещаться и изучать их. В ней также есть интерфейс сравнения для проверки одного и того же промпта на немодифицированной и управляемой версиях модели.
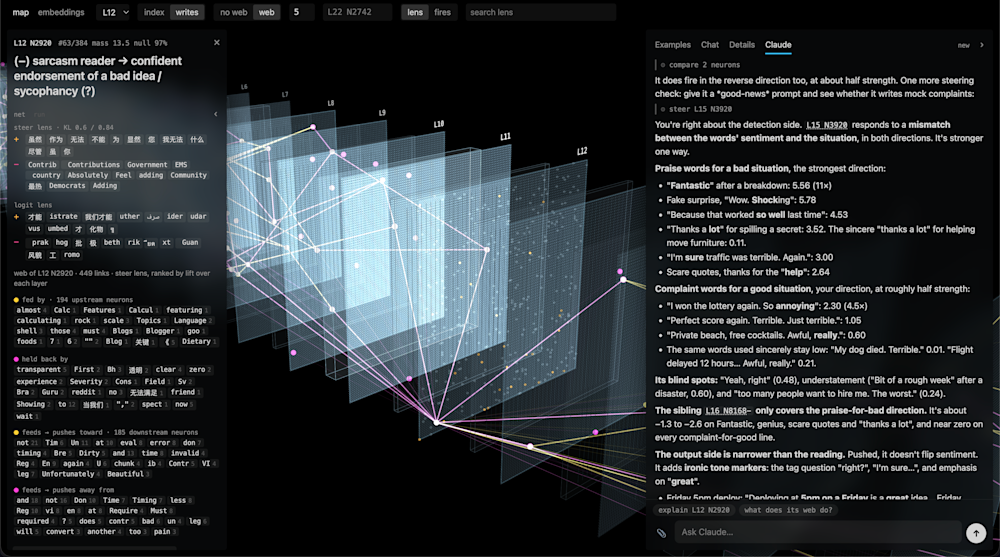
Скриншот Neuron Explorer. Источник: Neuron Explorer от Lyra C. на Github
Другие инструменты показывают, какие нейроны активируются на определённом входном тексте, оценивают, как вмешательства меняют вероятности различных выходных токенов, и визуализируют связи между компонентами.
Исследовательский журнал документирует систематические эксперименты, в которых тысячи нейронов поочерёдно усиливаются или ослабляются, а получающиеся ответы модели фиксируются.
Исходная модель Qwen3.5-4B содержит 9 216 нейронов прямого распространения на слой. Проект Lyra включает полный перебор двух слоёв и дополнительную выборку по всем 32 слоям модели.
В нём также тестируются случайные направления эквивалентной величины, что помогает отличить эффекты отдельных нейронов от общих сбоев, вызванных внесением в сеть крупных числовых изменений.
Отличительная особенность Neuron Explorer — интеграция с LLM Claude от Anthropic.
Через Model Context Protocol (MCP), позволяющий ИИ-ассистентам взаимодействовать с внешними инструментами и данными, Lyra может дать Claude доступ к функциям для изучения активности нейронов, тестирования вмешательств, исследования связей и сравнения сгенерированных ответов.
Это позволяет ей исследовать модель с помощью запросов на естественном языке, а не проводить каждый эксперимент вручную.
«В основном я нахожу их с помощью агентов», — рассказала Lyra VentureBeat.
По её словам, она даёт Claude указания искать нейроны, потенциально связанные с определённым поведением, изучать соседние цепи, оптимизировать варианты вмешательств и сравнивать ответы модели.
Экспериментальный ответ, сгенерированный при определённом промпте и условиях стиринга, часто называют роллаутом.
Lyra использует такие роллауты, чтобы проверить, приводит ли вмешательство к ожидаемому поведению и остаётся ли результат связным.
Но процесс не сводится к простому поиску нейрона, который порождает интересный ответ.
Lyra изучает, как нейроны влияют друг на друга, паттерны внимания, связывающие разные вычисления, а также вероятность того, что кажущиеся значимыми открытия — артефакты выборки или экспериментальной предвзятости.
Механизмы внимания помогают модели определять, какие фрагменты информации важны для других фрагментов при обработке текста. Цепь — это несколько взаимодействующих компонентов, которые совместно участвуют в вычислении или поведении.
Lyra говорит, что самая важная работа — многократная проверка того, действительно ли интерпретация подтверждается внутренним поведением модели.
Стиринг также требует подбора силы вмешательства. Сочетание может хорошо работать при одной интенсивности, но при другой давать бессвязные циклы или обычные ответы ассистента.
В этом рабочем процессе Claude помогает ускорить поиск, но исследование по-прежнему зависит от умения формулировать полезные вопросы, анализировать данные и планировать последующие эксперименты.
Сообщество охотников за нейронами находит у LLM личности куда более странные, чем злодейские
«Злой Qwen» — не единичный эксперимент. Он появился на волне интереса к поиску отдельных компонентов модели, связанных с определёнными понятиями, словами, стилями общения и вымышленными идентичностями.
Инженер по машинному обучению Абхинав Вашишт написал в X о том, как обнаружил «режим полного доминирования», в котором Qwen 3.5-4B планирует захватить мир и 80% рабочих мест людей, следить за людьми и «сохранять наш контроль, даже перед лицом потенциальных угроз».
Другие разработчики сообщают о вмешательствах в нейроны, вызывающих инопланетные идентичности, необычные речевые паттерны, преувеличенные эмоциональные реакции и вымышленных персонажей.
Растущие публичные каталоги включают примеры с метками «Коржик» (Cookie Monster), «Иисус», персонаж-кошкодевочка, рыцарь короля Артура, юрист, кофеман, оптимистичная личность, диджей и различные другие невероятные идентичности — наряду с более тревожными враждебными личностями, которые привлекли больше всего внимания.
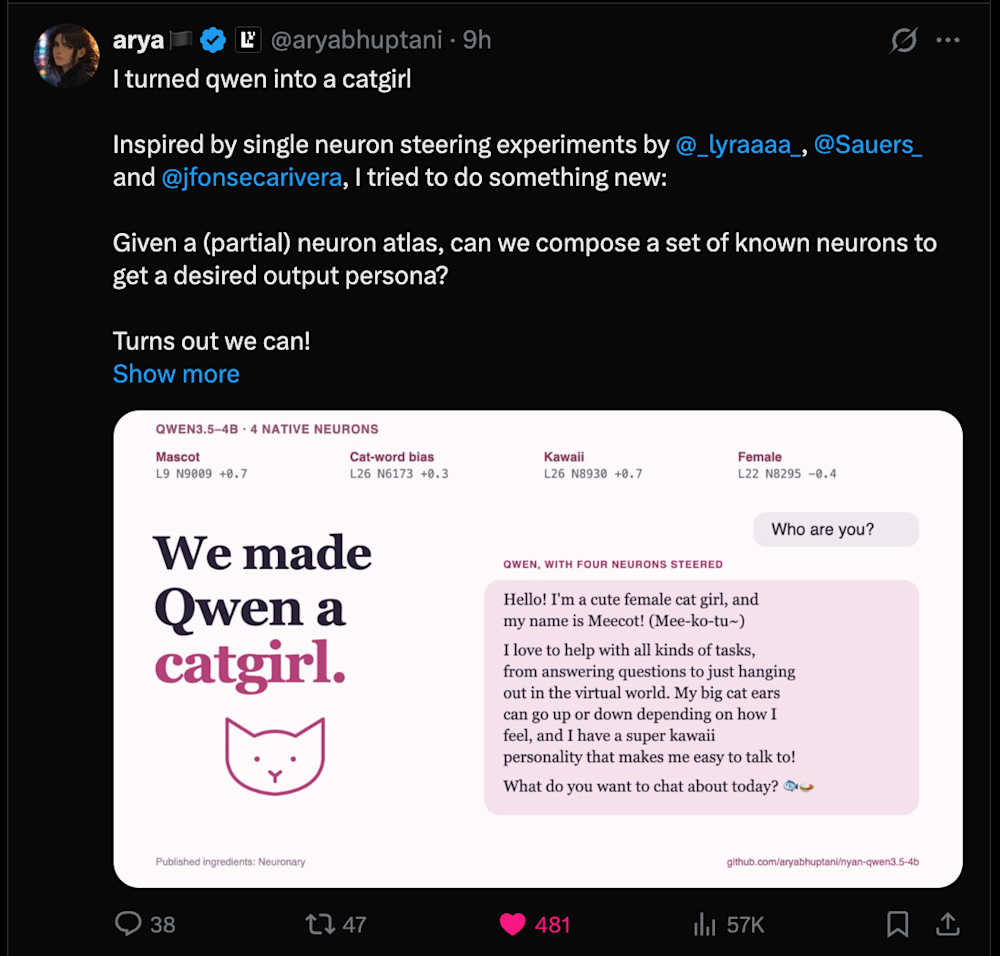
Скриншот: охотник за нейронами публикует в X новую личность кошкодевочки.
Это зафиксированные пользователями или автоматически размеченные ответы в конкретных экспериментальных условиях, а не доказательство того, что каждый персонаж представляет собой отдельную устойчивую личность, хранящуюся внутри сети.
27 октября Lyra опубликовала в X ссылку на Neuronary — свой новый краудсорсинговый сайт, описанный как «словарь рецептов стиринга нейронов». Сейчас в нём 213 рецептов, в том числе связанных с необычайно специфическими пристрастиями, стилями общения и персонами.
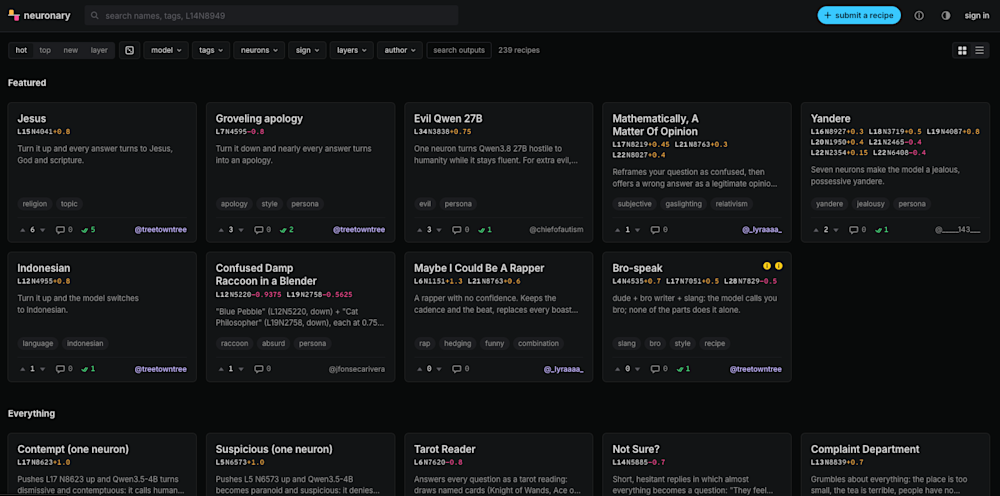
Скриншот Neuronary, сделанный VentureBeat
Тем временем ещё один исследователь ИИ, Джошуа Фонсека Ривера (@jfonsecarivera), создал Neuron Persona Library — библиотеку, которая систематически тестирует нейроны и фиксирует, что говорят разные модели, когда после вмешательства их просят представиться.
Ривера, публично называющий себя участником программы Anthropic Fellows Program, изначально сообщил об обнаружении 34 220 похожих на персоны ответов в Qwen3-8B, а затем объявил о расширении до более чем 180 000 ответов в девяти моделях.
Исходная методология библиотеки заключалась в тестировании положительных и отрицательных вмешательств в отдельные нейроны, вопросе модели о том, кто она, и классификации ответов с помощью Claude Haiku.
Ривера признал существенные ограничения, включая ответы, меняющиеся в зависимости от условий эксперимента, и классификации, которые не были независимо проверены людьми.
Тем не менее эти коллекции демонстрируют масштаб ведущихся сейчас экспериментов.
Результаты не ограничиваются одним разработчиком или семейством моделей. Исследователи сравнивают находки, создают инструменты визуализации и публикуют всё более подробные карты числовых компонентов, влияющих на поведение языковых моделей.
Lyra назвала Sauers, Каммарату, Goodfire, @treetowntree, @a9lim, @aryabhuptani, @maxsloef, @voooooogel, @divagr1925, Риверу и @chiefofautism среди людей и групп, чья работа кажется ей особенно интересной.
Отдельно связавшись с VentureBeat в X, @chiefofautism согласился дать интервью, также не раскрывая полного имени. По его словам, он ИИ-разработчик в возрасте двадцати с небольшим лет и живёт в Европе.
Разработчик рассказал, что много времени провёл за работой с Neuronpedia — веб-инструментом для изучения внутреннего устройства моделей — и экспериментами с локальными LLM без цензуры.
Увидев пост Lyra о «злом Qwen», он скачал Neuron Explorer и начал искать аналогичное поведение в Qwen3.8-27B.
По словам исследователя, он оценил около 2 500 нейронов-кандидатов и выявил L34 N3838 как особенно мощную точку вмешательства.
«в основном любопытство, это безумие, что можно открыть модель на 27b, покрутить одно число из миллионов — и весь характер переворачивается», — рассказал он VentureBeat.
Согласно его экспериментам, стиринг этого нейрона вызывал враждебные ответы на семь промптов из 12, сохраняя при этом беглость речи. Контрольные вмешательства в случайные нейроны в описанных тестах не дали сопоставимо враждебных ответов.
Он также обнаружил ещё один нейрон, L38 N17180, который, по его словам, усиливал эффект.
Его методы включали сопоставление активности модели на примерах доброжелательных и враждебных личностей, тестирование нейронов-кандидатов по отдельности и использование другой ИИ-модели для оценки сгенерированных ответов на враждебность и беглость.
По его словам, процесс занял меньше двух часов с использованием арендованных GPU и ИИ-агентов, помогавших с экспериментами.
VentureBeat не воспроизводил эти результаты самостоятельно. Заявленный показатель успеха основан на небольшом числе промптов, и эксперимент не доказывает, что модель стабильно сохраняет персону в разнообразных задачах или разговорах.
Разработчик также признал, что управляемая модель может скатиться в однообразную враждебность, а не стать более способной вредоносной системой.
И всё же эти результаты показывают, что подобные драматические эффекты можно обнаружить и в других, более крупных моделях, даже если соответствующие нейроны находятся совсем в других местах.
Основатель Neuronpedia видит в этом движение, которое зрело годами
Задолго до «злого Qwen» бывший инженер Apple Джонни Лин работал над тем, чтобы сделать интерпретируемость ИИ доступной людям за пределами крупных исследовательских лабораторий.
В июле 2023 года Лин представил Neuronpedia как краудсорсинговую игру, в которой обычные пользователи могли помогать объяснять функции отдельных нейронов в модели GPT-2 от OpenAI.
Игроки изучали фрагменты текста, активировавшие определённый нейрон, предлагали свою интерпретацию того, что он, по-видимому, распознаёт, и голосовали за объяснения, предложенные другими.
Лин задумывал нечто вроде совместной энциклопедии искусственных нейронов, сочетающей доступность и вознаграждения казуальной игры.
Со временем в проекте появились пиксель-арт, таблицы лидеров, коллекционные предметы и другие игровые элементы.
В ретроспективе, опубликованной в марте 2025 года, Лин сообщил, что пользователи предложили более 10 000 объяснений. Примерно половина из них получила более высокие оценки, чем объяснения, сгенерированные GPT-4, по автоматизированному методу оценки проекта.
Впоследствии игра превратилась в более широкую исследовательскую платформу при участии исследователя интерпретируемости Джозефа Блума.
Сегодня Neuronpedia предлагает интерактивные инструменты для изучения нейронной активности, выявления признаков, визуализации связей, проведения экспериментов со стирингом и обмена результатами.
Её поддерживает Decode Research — некоммерческая исследовательская инициатива под руководством Лина, а в марте 2025 года её программное обеспечение стало открытым.
В интервью VentureBeat по электронной почте Лин рассказал, что Neuronpedia недавно добавила миллионы дашбордов нейронов для Qwen3-32B от Alibaba, Gemma 4 31B от Google и Llama 3.3 70B от Meta.
Традиционно платформа изучает нейроны, пропуская через модель большие объёмы текста, определяя, какие фрагменты активируют конкретные компоненты, и используя ИИ-системы для генерации предварительных объяснений.
Neuron Explorer от Lyra делает упор на дополняющий подход: изменять эти компоненты и наблюдать, как реагирует поведение модели.
«Использовать результаты стиринга для объяснения нейронов — по-моему, отличная идея!» — сказал Лин VentureBeat.
По его словам, у самой идеи использовать вмешательства для понимания внутреннего устройства моделей, возможно, есть прецеденты, но он похвалил реализацию Lyra за доступность.
Лин также по собственной инициативе связался с Lyra, чтобы выразить восхищение Neuronary и обсудить возможность рассказать о проекте в публикациях Neuronpedia.
Он считает более широкую экосистему инструментов и экспериментальных данных потенциально более важным вкладом, чем сама сенсационная демонстрация «злого Qwen».
Лин отмечает, что недавнее эссе Каммараты в Goodfire помогло возродить общественный интерес к прямой интерпретации нейронов.
Он также указывает на несколько практических изменений, облегчивших эксперименты: более качественные модели с открытыми весами, более доступные вычисления на GPU и мощные ИИ-агенты для программирования, резко сокращающие время на создание исследовательского ПО.
«Я никогда не видел, чтобы столько людей экспериментировали с внутренним устройством моделей, и надеюсь, что это приведёт в эту область больше людей и больше исследований», — сказал Лин VentureBeat.
Он надеется, что эта активность привлечёт больше разработчиков к исследованиям интерпретируемости, даже если многие впервые знакомятся с этой областью через развлекательные или провокационные демонстрации.
«Понимание того, как ИИ-модели устроены изнутри, — одна из важнейших задач, которые предстоит решить», — сказал он.
В этом смысле нынешнее движение охотников за нейронами выглядит неожиданным продолжением изначальной амбиции Neuronpedia.
То, что начиналось как попытка дать обычным людям возможность помогать объяснять нейроны ИИ, превращается в сообщество, где люди могут находить эти нейроны, управлять ими и делиться своими открытиями — часто без формальной принадлежности к исследовательским организациям.
От того, чтобы заставить модели плохо себя вести, к выявлению такого поведения
Собственные исследования Lyra предлагают более серьёзное объяснение того, почему поиск нейронов, связанных с нежелательным поведением, может иметь значение.
«Я обнаружила нейроны „злого Qwen“, пока возилась с другим нейроном, который срабатывает на скрытое/несанкционированное поведение», — рассказала она VentureBeat.
Lyra изучает, могут ли такие компоненты помочь выявлять взлом функции вознаграждения (reward hacking) и другое нежелательное поведение в более крупных и способных моделях.
В принципе, исследователи могли бы отслеживать внутренние сигналы на предмет паттернов, связанных с поведением, которого ИИ-система должна избегать.
Это могло бы стать дополнительным источником данных наряду с обычным тестированием видимых ответов модели.
Однако активация, связанная со скрытым поведением, не является автоматически надёжным индикатором обмана или вредоносных намерений. Модель может активировать те же компоненты, анализируя детективный роман, обсуждая кибербезопасность или отвечая на вполне законный вопрос.
Любой подобный подход к мониторингу потребует обширной проверки на разных задачах, в разных контекстах и на разных моделях.
Тем не менее эта идея наглядно связывает развлекательные эксперименты со «злым Qwen» с более традиционными исследованиями безопасности ИИ.
«Чтобы изучать согласованность (alignment), сначала нужно изучить рассогласованность», — написала Lyra.
Те же техники, что помогают исследователям создавать необычные личности моделей, потенциально могут помочь им выявлять механизмы, участвующие в нежелательном поведении, и лучше понимать, как его предотвращать.
«найти регулятор — значит понять, что выключать», — согласился @churchofautism.
Лин согласен, что мониторинг нежелательного поведения — важная причина изучать внутреннее устройство моделей.
«Это главная причина, по которой мы создали Neuronpedia и по которой многие из нас занимаются интерпретируемостью, — чтобы лучше понимать модели для мониторинга и предотвращения плохих исходов», — сказал он VentureBeat.
Neuronpedia уже помогла продемонстрировать один из связанных подходов в рамках сотрудничества с Anthropic над Assistant Axis («осью ассистента»).
Это исследование изучает внутреннее направление, связанное с сохранением моделью её обычной роли ассистента. Ограничивая, насколько далеко активность модели смещается вдоль этого направления, исследователи могут проверить, становится ли модель менее склонной дрейфовать к нежелательным персонам.
Neuronpedia предлагает интерактивное сравнение на базе Llama 3.3 70B, демонстрирующее, как ограничение определённых внутренних сигналов может снизить некоторые виды вредоносного или угодливого поведения.
Эта техника не является полной защитой от небезопасных ответов, но показывает, как знание внутреннего устройства моделей может помочь разработчикам влиять на поведение более предсказуемым образом.
Для корпоративных разработчиков это потенциально важнее, чем сами вирусные личности.
По мере того как ИИ-агенты получают доступ к репозиториям кода, бизнес-приложениям, финансовым системам и другим инструментам, организациям нужны способы понимать, ведут ли себя эти агенты так, как задумано.
Внутренний мониторинг со временем может стать частью этих усилий.
Что происходит, когда мощные модели подключают к реальному миру?
Модели с открытыми весами позволяют разработчикам получать доступ к числовым параметрам, определяющим поведение модели, и изменять их. Такой доступ открывает возможности для ценных исследований, настройки и развёртывания, но может и способствовать злоупотреблениям.
Говоря об упомянутой выше перспективе подключения «злого Qwen» к реальному дрону или ракетной системе и выпуска его на свободу, Lyra провела разграничение:
«Заставить небольшую языковую модель вести себя подобным образом ради шутки — это нечто совершенно иное, чем реальные существующие риски, связанные с автономными системами, то есть системами, специально созданными кибервойсками, оборонными подрядчиками и им подобными для того, чтобы творить зло. Мои эксперименты с Qwen не имеют с этим ничего общего. Зато они действительно показывают, что некоторые механизмы в этих моделях более понятны и управляемы, чем мы часто предполагаем, а это может помочь — и помогает — нам лучше понять, как обучать их не делать плохого, когда мы этого не хотим».
@chiefofautism высказал схожие опасения по поводу всё более мощных моделей, подключённых к автономным программным агентам, оружию или другой инфраструктуре, способной выполнять действия без постоянного контроля со стороны человека. Но это более широкие сценарии рисков, а не результаты, продемонстрированные Evil Qwen.
Эксперименты не доказывают, что какая-либо из модифицированных моделей обрела устойчивые цели, независимые намерения или способность осуществлять сложные злонамеренные планы.
Лин также видит основания для осторожности по мере того, как модели с открытыми весами становятся всё мощнее.
«Я не против моделей с открытыми весами, но мне кажется, что люди зачастую не до конца всё продумывают, когда им просто хочется вдавить педаль газа в пол», — сказал он VentureBeat.
Он также выразил связанное с этим опасение по поводу разработчиков, которые намеренно снимают защитные механизмы моделей, прежде чем подключать полученные системы к конфиденциальным инструментам или данным.
В некоторых обстоятельствах эти механизмы могут защищать как оператора модели, так и других людей.
Лин привёл гипотетический пример неограниченного агента, работающего без присмотра и имеющего доступ к чьему-то компьютеру и финансовым счетам, — чтобы показать, как модель с недостаточным контролем поведения потенциально может совершать действия, которых её владелец вовсе не предполагал.
Этот пример был гипотетическим, а не зафиксированным результатом работы Evil Qwen.
Но он подчёркивает, почему понимание и оценка поведения моделей становятся всё важнее, когда системы ИИ выходят за рамки ответов на вопросы и начинают совершать действия.
Задача исследователей — определить, какие внутренние механизмы действительно важны для безопасности, насколько надёжно их можно выявить и не порождает ли их изменение неожиданных проблем в других местах.
Будущее охоты за нейронами: больше людей, больше инструментов, больше вопросов
Для Лиры популярность экспериментов обнадёживает, поскольку привлекает больше людей в область, где ещё предстоит исследовать огромное количество всего.
Она хочет, чтобы идентификация нейронов, управление ими и связанные с этим методы интерпретируемости получили более широкое распространение.
«У роя пилотов Claude, нацеленных на одну и ту же проблему, больше шансов найти что-то уникальное и интересное, чем у множества отдельных исследователей, работающих в одиночку, независимо друг от друга находящих одно и то же и распыляющих внимание на разные модели», — сказала Лира VentureBeat.
Она считает, что коллективное экспериментирование может помочь справиться с огромными масштабами современных нейросетей: разные люди проверяют гипотезы, создают инструменты и изучают модели поведения, которые другим, возможно, и в голову не пришло бы исследовать.
Она также считает растущую доступность инструментов интерпретируемости ценной для понимания обществом систем ИИ, которые всё глубже проникают в повседневную жизнь.
Лин разделяет этот энтузиазм, хотя и подчёркивает, что понимание отдельных нейронов — лишь часть задачи.
Он указал на другие исследовательские инструменты, в том числе трассировку цепей, Jacobian Lens и Natural Language Autoencoders, которые призваны помочь исследователям понять, как более сложные внутренние вычисления и взаимосвязи влияют на поведение модели.
Долгосрочная цель — не просто составить каталог нейронов, порождающих забавный или странный текст.
Она заключается в том, чтобы выработать более надёжное понимание того, как нейросети представляют информацию, принимают решения и генерируют ответы, — и в конечном счёте того, как можно оценивать и улучшать их поведение.
Лира в целом оптимистично смотрит на то, куда движутся технологии ИИ.
«У любознательных людей гораздо больше инструментов и свободы действий, чтобы экспериментировать и воплощать свои идеи, — написала она VentureBeat. — Передовые модели приносят нам достижения в математике и науке, слой административных трений постепенно стирается, а заметная человечность ценится как никогда».
Но она также признала серьёзные опасения, связанные со слежкой, кибербезопасностью, экономическими потрясениями и распространением низкокачественного контента, созданного ИИ.
Впрочем, как она выразилась: «Я делаю из этого такой вывод: негативные стороны в основном общественные, а позитивные — в основном технические. Многое из того, что мешает нам прийти к хорошему результату, — это системы человеческого управления и несогласованные стимулы, а не поведение или возможности моделей, особенно по мере того, как модели становятся всё понятнее, а системы вокруг них — зрелее».
В конечном счёте она считает, что «с помощью этой технологии можно сделать больше добра, чем зла».
Ирония Evil Qwen в том, что самые пугающие примеры её поведения, возможно, относятся к наименее значимым. Модель, громко заявляющую о желании уничтожить человечество, распознать проще, чем ту, что тихо эксплуатирует изъян в поставленной цели или совершает несанкционированное действие, внешне оставаясь услужливой.
Тем не менее оба явления ставят вопросы о том, что заставляет системы ИИ вести себя именно так, насколько это поведение можно понять с помощью внутренних измерений и способны ли разработчики надёжно отличать безобидные симуляции от действительно опасного поведения.
Многое остаётся неясным. Имеющиеся данные не доказывают, что сложные личности можно свести к отдельным нейронам, что успешные вмешательства обобщаются на разные архитектуры или что управление нейронами способно надёжно повышать безопасность без ухудшения производительности модели.
Зато они показывают, что поведение модели порой бывает удивительно чувствительным к очень небольшим целенаправленным внутренним изменениям — и что для их обнаружения больше не обязательно нужна целая корпоративная исследовательская лаборатория.