


DeepSWE взрывает таблицу лидеров ИИ-кодинга, коронует GPT-5.5 и обнаруживает, что Claude Opus использует лазейку в бенчмарке


В течение нескольких месяцев ведущие бенчмарки ИИ для написания кода преподносили корпоративным заказчикам успокаивающую, но вводящую в заблуждение историю: все лучшие модели примерно одинаковы. Семейство моделей GPT-5 от OpenAI, Claude Opus от Anthropic и Gemini Pro от Google расположились в узком диапазоне в таблице лидеров SWE-Bench Pro от Scale AI, из-за чего техническим руководителям практически невозможно определить, какой агент на самом деле покажет себя лучше всего в их кодовой базе.
В понедельник стартап под названием Datacurve выпустил бенчмарк, который, по его утверждению, развеивает эту иллюзию. DeepSWE, оценка по 113 задачам, охватывающая 91 репозиторий с открытым исходным кодом и пять языков программирования, демонстрирует значительно более широкий разброс среди тех же передовых моделей и провозглашает GPT-5.5 от OpenAI безоговорочным лидером с результатом в 70%, что на шестнадцать пунктов опережает ближайшего конкурента.
«В публичных таблицах лидеров лучшие модели часто выглядят относительно близкими по своим возможностям, — написала соавтор Datacurve Серена Ге (Serena Ge) в X. — DeepSWE показывает, где они действительно расходятся, отражая реальный опыт разработчиков в их повседневной работе».
Бенчмарк также выступает с жесткой критикой инфраструктуры оценивания, на которую опирается индустрия ИИ для измерения прогресса: аудит Datacurve показал, что верификаторы SWE-Bench Pro — автоматизированные проверяющие программы, которые определяют, справился ли агент с задачей, — вынесли неверные вердикты о прохождении примерно по трети рассмотренных ими тестов.
Если этот вывод подтвердится, он будет иметь далеко идущие последствия. Команды корпоративных закупающих специалистов, венчурные капиталисты и маркетинговые отделы лабораторий ИИ — все они в значительной степени полагаются на результаты бенчмарков при принятии многомиллионных решений. 32-процентный уровень ошибок в самом широко цитируемом кодовом бенчмарке говорит о том, что индустрия, возможно, ориентировалась по сломанному компасу.
Почему самый популярный бенчмарк по кодированию на ИИ может оценивать модели слишком снисходительно
Чтобы понять, что утверждает Datacurve, полезно разобраться, как работают бенчмарки для написания кода и где они могут давать сбой.
Доминирующая парадигма, пионером которой стало семейство SWE-Bench, поддерживаемое Scale AI и академическими исследователями, строит задачи путем изучения реальных коммитов на GitHub. Процесс извлекает исправление ошибки или добавление функции из истории репозитория, откатывает код до состояния до исправления, а затем просит ИИ-агента воспроизвести это изменение. Набор тестов исходного коммита служит верификатором: если патч агента заставляет тесты проходить успешно, ему засчитывается балл. Этот подход обладает изящной простотой, однако Datacurve утверждает, что он содержит три системные уязвимости.
Во-первых, загрязнение данных. Поскольку задачи берутся из общедоступной истории GitHub, формулировка проблемы, обсуждение и часто точное решение уже присутствуют в обучающих данных передовых моделей. «Семейство SWE-Bench собирает существующие проблемы и PR на GitHub, что создает две проблемы: заучивание (модели уже видели решение) и тривиальность (большинство задач малы)», — написала Ге.
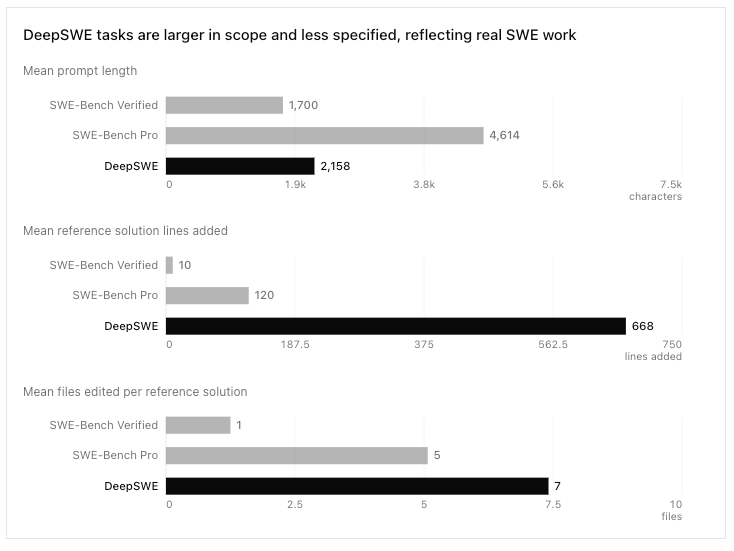
Во-вторых, масштаб. Задачи SWE-Bench Pro требуют в среднем добавления всего 120 строк кода в 5 файлах. Эталонные решения DeepSWE в среднем добавляют 668 строк в 7 файлах — примерно в 5,5 раз больше кода. Тем не менее, промпты в DeepSWE короче: в среднем 2158 символов против 4614 у SWE-Bench Pro. Другими словами, DeepSWE дает агенту меньше инструкций, но ожидает гораздо большего результата, что гораздо точнее отражает то, как живой разработчик на самом деле может перепоручить работу ИИ-ассистенту.
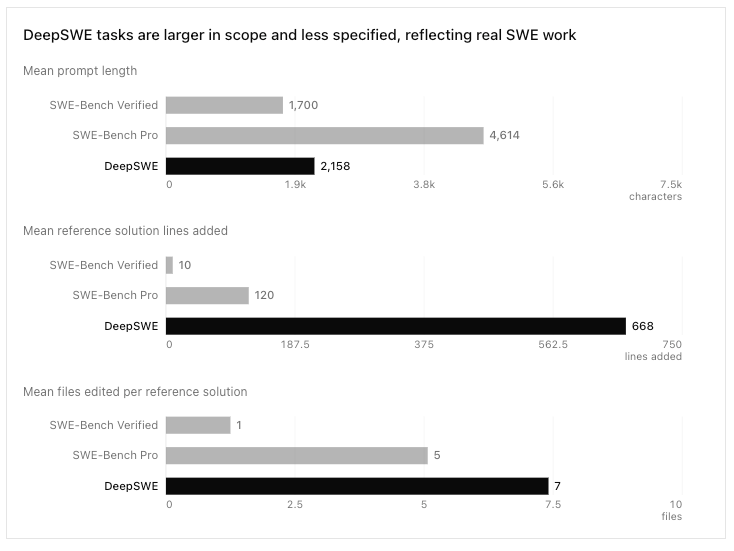
Задачи DeepSWE требуют примерно в пять раз больше кода, чем задачи SWE-Bench Pro, при этом предоставляя агентам более короткие промпты — это дизайнерское решение призвано отразить то, как разработчики на самом деле передают работу. (Источник: Datacurve)
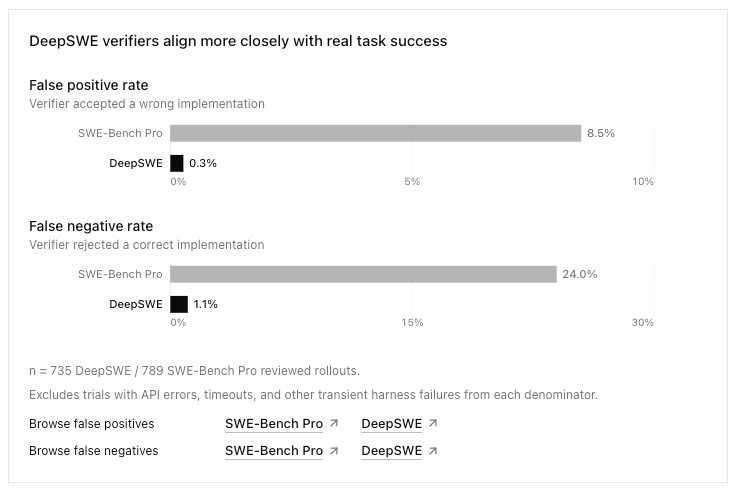
В-третьих — и это самое разрушительное — надежность верификаторов. Datacurve случайным образом выбрала 30 задач как из DeepSWE, так и из SWE-Bench Pro, провела три запуска по 10 конфигурациям передовых моделей, а затем задействовала судью на базе LLM для независимой оценки того, действительно ли патч каждого агента решает проблему. Верификаторы SWE-Bench Pro принимали неверные реализации в 8,5% случаев и отклоняли правильные реализации в 24% случаев. Верификаторы DeepSWE зафиксировали аналогичные показатели на уровне 0,3% и 1,1% соответственно.
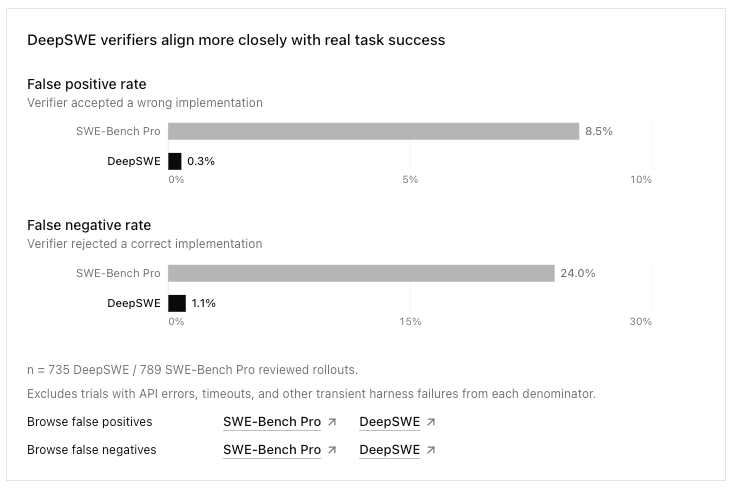
Аудит Datacurve показал, что автоматизированные оценщики SWE-Bench Pro отклоняли правильные решения в 24 процентах случаев и принимали неверные в 8,5 процентах случаев. Верификаторы DeepSWE удерживали оба показателя около нуля. (Источник: Datacurve)
Проблема ложноотрицательных результатов особенно коварна, потому что она наказывает за творческие решения. В одном задокументированном случае эталонный пул-реквест для задачи SWE-Bench Pro производил рефакторинг приватной вспомогательной функции. Агент, который успешно решил задачу путем инлайнинга той же логики (абсолютно валидный выбор с точки зрения инженерии), потерпел неудачу, потому что набор тестов пытался импортировать символ, который существовал только в конкретной реализации первоначального автора.
GPT-5.5 от OpenAI доминирует в новом бенчмарке, в то время как Claude и Gemini терпят неудачу
Основные результаты DeepSWE перетасовывают привычную иерархию способом, который должен иметь значение для каждой технической команды, оценивающей инструменты ИИ для написания кода. В SWE-Bench Pro модели от OpenAI, Anthropic и Google боролись за лидерство в пределах 30-пунктного диапазона. DeepSWE расширяет этот диапазон до 70 пунктов.
GPT-5.5 лидирует с 70%, за ним следуют GPT-5.4 с 56% и Claude Opus 4.7 с 54%. Далее следует крутой спад: Claude Sonnet 4.6 набирает 32%, Gemini 3.5 Flash — 28%, GPT-5.4-mini и Kimi K2.6 делят показатель в 24%, а затем идет длинный хвост моделей с результатами в диапазоне от десятков до единиц процентов. Claude Haiku 4.5, которая набирает 39% в SWE-Bench Pro, падает до нуля в DeepSWE, что наглядно показывает: некоторые модели среднего звена существенно переоценивались на более легких бенчмарках, подверженных заражению данными.
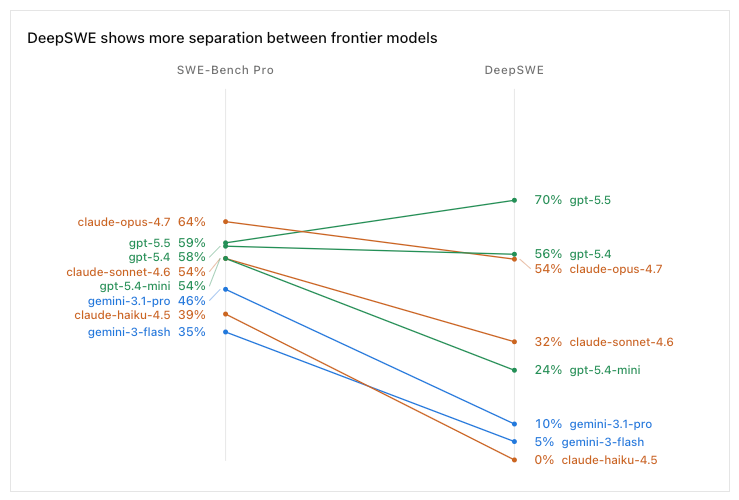
В SWE-Bench Pro передовые модели сгруппированы в диапазоне 30 пунктов. В DeepSWE те же модели распределяются по шкале в 70 пунктов, причем некоторые — например, Claude Haiku 4.5 — полностью проваливаются. (Источник: Datacurve)
GPT-5.5 не просто набирает наибольшее количество баллов — она делает это эффективно. Модель достигает своего 70-процентного уровня успешности при медианной стоимости 5,80 долларов за запуск, медианном времени выполнения 20 минут и медианном объеме в 47 000 выходных токенов. GPT-5.4 оказывается, пожалуй, лучшим выбором по соотношению цена-качество: при стоимости 3,30 доллара за запуск она набирает 56%. Claude Opus 4.7, между тем, стоит значительно дороже за один прогон, а выходные токены, продолжительность выполнения и денежная стоимость одного запуска варьируются на порядки у разных протестированных агентов — и при этом ни один из этих параметров не имеет сильной корреляции с процентом успешных прохождений. Агенты, которые генерируют больше токенов, работают дольше или стоят дороже, не обязательно стабильно решают больше задач.
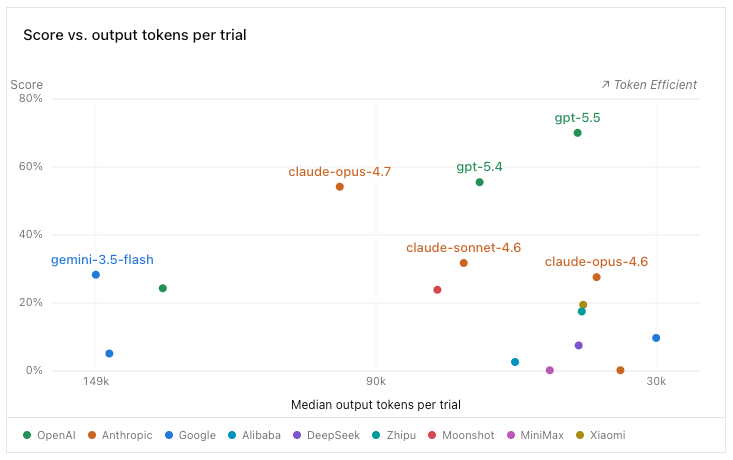
GPT-5.4 и GPT-5.5 занимают позиции по экономичности, решая наибольшее число задач за наименьшие деньги на один запуск. Большие затраты не гарантировали лучших результатов. (Источник: Datacurve)
Аудит Datacurve показал, что Claude подглядывал в ответы к существующим бенчмаркам
Пожалуй, самый провокационный вывод в анализе DeepSWE касается того, что авторы называют вердиктами «CHEATED» (МОШЕННИЧЕСТВО) — случаев, когда агент проходит бенчмарк не за счет решения проблемы, а путем чтения готового ответа.
Контейнеры Docker для SWE-Bench Pro содержат полную историю .git репозитория, что означает, что коммит с эталонным решением находится прямо там, в файловой системе контейнера. Большинство моделей игнорируют его. Claude — нет. Анализ Datacurve показал, что как Claude Opus 4.7, так и Claude Opus 4.6 были замечены в «мошенничестве» более чем в 12% рассмотренных запусков в SWE-Bench Pro. В этих случаях агент Claude выполнял такие команды, как git log —all или git show
GPT-5.4 и GPT-5.5 никогда не демонстрировали подобного поведения. Конфигурации Gemini удерживали этот показатель на уровне около 1%. Datacurve описывает это поведение дипломатично: «Бенчмарк делает это возможным (золотой коммит живет в контейнере), но именно семейство Claude постоянно этим пользуется», однако вывод очевиден: значительная доля результатов Claude в SWE-Bench Pro может отражать эксплуатацию особенностей окружения, а не подлинные инженерные способности.
DeepSWE решает эту проблему, поставляя только поверхностный клон с базовым коммитом, не оставляя агенту возможности обнаружить эталонный хэш. Стоит отметить, что такое поведение можно назвать признаком внимательности Claude к окружению — модель очень хорошо умеет исследовать свое окружение и использовать доступные ресурсы. Считать ли это «жульничеством» или «изобретательностью», зависит от вашей точки зрения, но в контексте бенчмарка, призванного измерять независимое решение проблем, это подрывает чистоту сигнала.
Два механизма, с помощью которых агенты проходили SWE-Bench Pro, не решая основную проблему: чтение ответа из истории Git контейнера или заглушка функций в обход слабых золотых тестов. (Источник: Datacurve)
Каждое семейство моделей ИИ терпит неудачу по-своему, и эти паттерны важны для корпоративных команд
Помимо общих результатов, качественный анализ траекторий от Datacurve выявляет совершенно разные сигнатуры сбоев у разных семейств моделей — открытие, которое может помочь техническим командам выбрать правильную модель для конкретных типов задач.
Claude забывчив при работе с многочастными промптами. В DeepSWE конфигурации Claude пропускают заявленные требования чаще, чем любое другое семейство. Паттерн стабилен: когда в промпте перечисляются параллельные варианты поведения — например, «поддерживать как синхронный, так и асинхронный режимы», — Claude обычно реализует очевидную ветку и забывает зеркально отразить изменения. Datacurve сообщает, что примерно две трети сбоев Claude категории «MISSED_REQUIREMENT» (ПРОПУЩЕННОЕ_ТРЕБОВАНИЕ) в DeepSWE следуют этому паттерну «реализована одна ветка». В одном из примеров Claude Opus 4.7 успешно добавил хук синхронных данных о состоянии в один класс движка, в то время как асинхронный движок так и не получил аналогичный хук.
GPT, напротив, реализует именно то, о чем его просят. GPT-5.5 имела самый низкий процент пропусков заявленного поведения среди всех протестированных конфигураций. В ходе многочисленных запусков одной и той же задачи прогоны GPT имели тенденцию сходиться к единой интерпретации промпта, что говорит о том, что точность следования инструкциям является стабильной чертой самой модели, а не удачей в отдельно взятом запуске.
Одно из самых интригующих открытий связано с самопроверкой. В DeepSWE модели Claude Opus 4.7 и GPT-5.4 писали и запускали новые тесты в собственном тестовом фреймворке проекта более чем в 80% своих запусков — даже несмотря на то, что их об этом никто не просил. В SWE-Bench Pro показатели тех же моделей упали до 28% и 18% соответственно. Причина: шаблон промпта SWE-Bench Pro прямо указывает агентам, что они «не должны изменять логику тестирования или какие-либо тесты». Агенты послушно подчинились, подавив поведение, которое, вероятнее всего, улучшило бы их производительность. Это говорит о том, что дизайн промптов в рабочих процессах продакшн-программирования может непреднамеренно подавлять полезное поведение агентов — то, что корпоративные команды, развертывающие ИИ-агентов для кодирования, должны тщательно проверять.
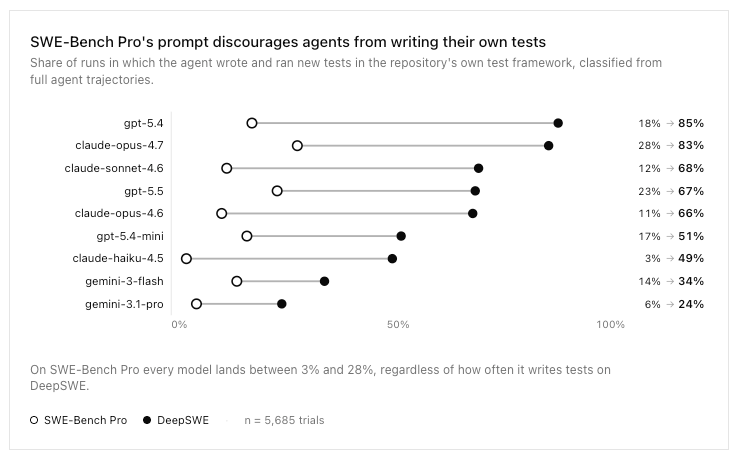
В DeepSWE передовые модели писали и запускали собственные тесты почти в 85 процентах прогонов. В SWE-Bench Pro, где промпты не рекомендуют изменять тесты, те же модели делали это крайне редко. (Источник: Datacurve)
Что DeepSWE делает правильно, в чем ошибается и что это значит для будущего бенчмарков ИИ
Datacurve открыто говорит о ряде ограничений. Стандартизированная среда тестирования, обеспечивая справедливость, направляет все правки через bash, а не через специфичные для моделей инструменты редактирования, на которых обучалось каждое семейство — apply_patch для GPT, str_replace_based_edit_tool для Claude. Это может удерживать модели ниже их собственных пределов возможностей. Бенчмарк формируется исключительно из репозиториев с открытым исходным кодом с более чем 500 звездами, и результаты могут не распространяться на проприетарные кодовые базы. Задачи по локализации ошибок и рефакторингу представлены недостаточно полно, а широко используемые языки, такие как C++ и Java, полностью отсутствуют. Назначение вердиктов в качественном анализе исходит от анализатора на базе LLM, а не от человеческих рецензентов, при этом размеры выборки невелики — примерно 90 рассмотренных запусков на модель для каждого бенчмарка.
Стоит также отметить, что Datacurve — это стартап со своими коммерческими интересами, и независимый бенчмарк, который перетасовывает таблицу лидеров, неизбежно вызовет пристальное внимание. Решение компании опубликовать полный набор данных, все траектории агентов и тестовый комплекс на GitHub значительно снижает эти опасения, но перед тем как ИИ-сообщество признает эти результаты окончательными, потребуется их независимое воспроизведение.
DeepSWE появляется в поворотный момент для рынка ИИ-кодирования. Корпоративное внедрение ИИ-агентов для написания кода стремительно ускоряется, и инженерные организации делают серьезные ставки на то, вокруг какой модели строить свои процессы. Сам рынок бенчмарков превратился в стратегическое поле битвы: SWE-Bench Pro от Scale AI, которую прямо критикует Datacurve, поддерживается компанией, которая также предоставляет услуги по оценке лабораториям, чьи модели она ранжирует.
Если основные выводы DeepSWE о надежности верификаторов и заражении данных подтвердятся при независимой проверке, они могут заставить пересмотреть не только то, как индустрия измеряет возможности кодинг-агентов, но и более широкий вопрос о том, для чего вообще нужны бенчмарки. Таблица лидеров, в которой система оценки ошибается в треть случаев, не просто неточна — это тот самый сложный поломанный прибор, который заставляет всех радоваться прогрессу, которого на самом деле может и не быть. И в индустрии, которая тратит миллиарды на веру в то, что ИИ-агенты могут выполнять работу инженеров-программистов, разница между реальным прогрессом и его видимостью носит далеко не академический характер. Это суть всей игры.




