DeepSeek-V4.1-Flash дебютирует с тарифом $0.003/1M за кэшированный ввод в часы наименьшей нагрузки и бенчмарками, превосходящими GPT-5.6 Sol и Claude Opus 5
Источник: VentureBeat · Carl Franzen


Компания DeepSeek прошлой ночью представила DeepSeek-V4.1-Flash — модель на базе архитектуры mixture-of-experts с 552 миллиардами параметров, встроенной поддержкой визуальных данных, контекстным окном в 1 миллион токенов и архитектурой, созданной для удешевления многократного чтения больших объемов контекста.
Её открытые веса доступны разработчикам и предприятиям для скачивания и использования в коммерческих целях на условиях либеральной и дружественной к бизнесу лицензии MIT на платформе Hugging Face. Однако для разработчиков, оценивающих модель для агентов по написанию кода и других долгосрочных рабочих процессов, заявленные расценки API сразу выглядят весьма привлекательно.
В часы наименьшей нагрузки DeepSeek оценивает V4.1-Flash в $0,003 за миллион входных токенов при попадании в кэш (cache hit), $0,15 за миллион при промахе кэша (cache miss) и $0,60 за миллион выходных токенов. В часы пиковой нагрузки эти тарифы удваиваются.
Это различие имеет принципиальное значение, поскольку агент, который постоянно работает с одним и тем же репозиторием, определениями инструментов, системными инструкциями или историей диалогов, может перечитывать гораздо больше кэшированного контекста по сравнению со свежим. По данным самой DeepSeek, расходы на попадания в кэш могут составлять значительную долю затрат на агентов.
Установленное в DeepSeek время пиковой нагрузки приходится с понедельника по пятницу на периоды 01:00–04:00 и 06:00–10:00 UTC; все остальные часы являются периодами сниженной нагрузки. Таким образом, для задач агентов, допускающих планирование, время запуска рабочей нагрузки становится еще одним рычагом контроля затрат.
Это делает V4.1-Flash особенно полезным тестовым примером для проблемы, которую, судя по собственным исследованиям VentureBeat, многие предприятия до сих пор не осознают в полной мере.
Согласно июльскому опросу VentureBeat Pulse Research 2026 года, охватившему 170 предприятий с штатом более 100 сотрудников, лишь 47% респондентов заявили, что тщательно отслеживают затраты на вычислительные мощности ИИ и окупаемость инвестиций (ROI), в то время как 53% этого не делают. При этом 12% отметили, что еще не занимались решением проблем ограничений памяти для инференса (таких как емкость KV-кэша), а еще 7% вообще не знали о существовании таких ограничений. Даже среди организаций, эксплуатирующих ИИ в продакшене на масштабном уровне, строгий учет затрат практикуют лишь 56%.
Вывод для разработчиков очевиден: сравнение моделей исключительно по стоимости некэшированного ввода может затушевать один из наиболее быстро растущих компонентов экономики агентов.
Показатель в $0,003 меняет правила сравнения
Стоимость кэшированного ввода DeepSeek в часы наименьшей нагрузки необычайно низка по сравнению с пограничными (frontier) API, с которыми она сопоставляет V4.1-Flash.
OpenAI указывает для GPT-5.6 Sol цену в $4 за миллион обычных входных токенов, $0,40 — за кэшированный ввод и $20 — за вывод. Anthropic взимает $5 за стандартный ввод, $0,50 — за попадания в кэш Claude Opus 5 и $25 — за вывод. У модели Kimi K3 от Moonshot AI ввод при промахе кэша стоит $3, при попадании — $0,30, а вывод — $15.
Сравнение DeepSeek не является абсолютно прямым («яблоки к яблокам»), поскольку её минимальные тарифы требуют использования модели в часы вне пиковой нагрузки. Тем не менее, даже в часы пик стоимость V4.1-Flash возрастает всего до $0,006 за миллион токенов кэшированного ввода, $0,30 — за некэшированный ввод и $1,20 — за вывод.
Для упрощенного расчета разработчика представим агента, который сохраняет многократно используемый префикс объемом 500 000 токенов и обращается к этому кэшу в рамках 100 запросов. Это составляет 50 миллионов кэшированных входных токенов. Без учета платы за запись в кэш, нового некэшированного контекста и вывода такие чтения кэша обойдутся примерно в $0,15 для V4.1-Flash в непиковое время по сравнению с $15 для Kimi K3, $20 для GPT-5.6 Sol и $25 для Claude Opus 5 при их опубликованных расценках на чтение из кэша.
|
Модель |
Ввод ($/1M) |
Вывод ($/1M) |
Итого ($/1M) |
Источник |
|
Muse Spark 1.2 / 1.3 Contributor |
$0,10 |
$0,20 |
$0,30 |
|
|
MiMo-V2.5 Flash |
$0,10 |
$0,30 |
$0,40 |
|
|
DeepSeek-V4.1-Flash — вне пика |
$0,15 |
$0,60 |
$0,75 |
|
|
GPT-5.6 Luna |
$0,20 |
$1,20 |
$1,40 |
|
|
MiniMax-M3 |
$0,30 |
$1,20 |
$1,50 |
|
|
LongCat-2.0 — ограниченная акция |
$0,30 |
$1,20 |
$1,50 |
|
|
DeepSeek-V4.1-Flash — часы пик |
$0,30 |
$1,20 |
$1,50 |
|
|
MiMo-V2.5 |
$0,40 |
$2,00 |
$2,40 |
|
|
DeepSeek-V4-Pro — вне пика |
$0,66 |
$1,98 |
$2,64 |
|
|
LongCat-2.0 — стандарт |
$0,75 |
$2,95 |
$3,70 |
|
|
MiMo-V2.5 Pro (≤256K) |
$1,00 |
$3,00 |
$4,00 |
|
|
Gemini 3.7 Flash — до 31 декабря 2026 г. |
$0,75 |
$3,75 |
$4,50 |
|
|
Gemini 3.8 Flash — до 31 декабря 2026 г. |
$0,75 |
$3,75 |
$4,50 |
|
|
DeepSeek-V4-Pro — часы пик |
$1,32 |
$3,96 |
$5,28 |
|
|
Muse Spark 1.1 / 1.2 / 1.3 |
$1,25 |
$4,25 |
$5,50 |
|
|
GLM-5.3 |
$1,40 |
$4,40 |
$5,80 |
|
|
Grok 4.6 — <200K токенов промпта |
$2,00 |
$6,00 |
$8,00 |
|
|
MiMo-V2.5 Pro (>256K) |
$2,00 |
$6,00 |
$8,00 |
|
|
Qwen3.8-Max |
$2,00 |
$6,00 |
$8,00 |
|
|
Gemini 3.7 Flash — начиная с 1 янв. 2027 г. |
$1,50 |
$7,50 |
$9,00 |
|
|
Gemini 3.8 Flash — начиная с 1 янв. 2027 г. |
$1,50 |
$7,50 |
$9,00 |
|
|
GPT-5.6 Terra |
$2,00 |
$12,00 |
$14,00 |
|
|
Grok 4.6 — ≥200K токенов промпта |
$4,00 |
$12,00 |
$16,00 |
|
|
GPT-5.4 |
$2,50 |
$15,00 |
$17,50 |
|
|
Kimi K3 |
$3,00 |
$15,00 |
$18,00 |
|
|
Claude Opus 5 |
$5,00 |
$25,00 |
$30,00 |
|
|
Sakana Fugu Ultra (≤272K) |
$5,00 |
$30,00 |
$35,00 |
|
|
GPT-5.6 Sol — Стандартный режим |
$5,00 |
$30,00 |
$35,00 |
|
|
Claude Fable 5 / Claude Mythos 5 |
$10,00 |
$50,00 |
$60,00 |
|
|
Claude Fable 5.1 / Claude Mythos 5.1 |
$10,00 |
$50,00 |
$60,00 |
|
|
GPT-6 Astra — Стандартный режим |
$10,00 |
$50,00 |
$60,00 |
|
|
GPT-5.6 Sol — Быстрый режим |
$10,00 |
$60,00 |
$70,00 |
|
|
GPT-6 Astra — Быстрый режим |
$20,00 |
$100,00 |
$120,00 |
Реальные рабочие нагрузки не обеспечивают идеального повторного использования кэша, а общая стоимость зависит от длины вывода, токенов рассуждения (reasoning tokens), повторных попыток, вызовов инструментов и показателей успешности задач. Но именно поэтому разработчики, оценивающие агентские рабочие нагрузки, должны измерять коэффициент попаданий в кэш и стоимость выполнения одной задачи, а не умножать общее число токенов промпта на заявленную входную цену модели.
Теперь DeepSeek-V4.1-Flash располагается почти на самом нижнем уровне мирового рынка платных API, при этом демонстрируя возможности, которые превосходят ожидания для своей ценовой категории.
При цене $0,15 за ввод / $0,60 за вывод или $0,75 суммарно за 1 млн токенов в часы наименьшей нагрузки она уступает в текущей таблице лишь моделям Muse Spark уровня Contributor от Meta и MiMo-V2.5 Flash; даже при тарифной сетке в $0,30 / $1,20 в часы пиковой нагрузки (или $1,50 в сумме) она по-прежнему делит позиции с MiniMax-M3 и акционными ценами LongCat, находясь далеко ниже кластера среднего уровня в диапазоне $4,50–$8,00 и значительно ниже премиальных пограничных моделей, таких как Claude Fable/Mythos 5.1, GPT-6 Astra и GPT-5.6 Sol в быстром режиме.
Стратегический смысл заключается в том, что DeepSeek использует V4.1-Flash не просто как дешевую «flash»-модель, а как новый центр тяжести для своего API: в документации указано, что запросы к устаревшей версии V4 Flash теперь обслуживаются V4.1-Flash, и что V4.1 Flash «всесторонне превзошла V4 Pro по производительности, стоимости, скорости и общему времени выполнения», причем V4 Pro после 14 сентября 2026 года будет перенаправляться на V4.1 Flash до появления будущей версии V4.1 Pro.
Данные Pulse от VentureBeat показывают, что системы метрик и мониторинга еще не успели за этим адаптироваться. Лишь 31% опрошенных предприятий назвали стоимость миллиона токенов в качестве основной метрики успеха инфраструктуры, в то время как время безотказной работы и надежность лидируют с 51%, а производительность разработчиков и скорость развертывания достигают 39%. Лишь 22% выбрали общую стоимость владения (TCO) в качестве главного критерия покупки.
Технический отчет DeepSeek также раскрывает внутреннее устройство экономики попаданий в кэш. Компания заявляет, что глобальный KV-кэш остается в постоянном кэше с гарантированным временем жизни не менее 72 часов. Краткосрочный KV-кэш с плавающим окном внимания (sliding-window-attention KV), напротив, хранится в пуле распределенной памяти, выделяемом из 10% DRAM хоста, и имеет минутное время жизни. Когда долгоживущий глобальный кэш сохраняется, а состояние SWA — нет, V4.1-Flash восстанавливает недостающее состояние путем воспроизведения только самого последнего окна внимания вместо всей истории.
DeepSeek сокращает кэш, а не модель
Архитектурное отличие также имеет важное значение. V4.1-Flash использует то, что DeepSeek называет архитектурой Causal Encoder-Decoder, разделяя свои 40 слоев Transformer на 20-слойный каузальный энкодер и 20-слойный декодер. Эта конструкция задействует 8 миллиардов параметров на один токен при чтении входа (префиле) и 16 миллиардов — при генерации вывода.
Это исправляет распространенное заблуждение: V4.1-Flash не является моделью с «активными 8B» на протяжении всего цикла инференса. Она активирует 8B на этапе префила и 16B на этапе декодирования.
Модель сочетает эту архитектуру со сжатой разреженной внимательностью второго поколения (Compressed Sparse Attention 2), иерархической разреженной индексацией и FP4 KV-кэшированием. По словам DeepSeek, эти методы снижают объем глобального KV-кэша до 890 байт на токен (примерно до четверти от размера V4-Flash), в то время как требования к постоянному хранилищу кэша сокращаются примерно в восемь раз.
Для циклов работы агентов с интенсивным вводом это потенциально значимые улучшения производительности обслуживания. Кодинг-агент, который постоянно перечитывает репозиторий, представляет собой именно тот тип рабочей нагрузки, где префилл и эффективность KV-кэша могут играть доминирующую роль.
Но «Flash» больше не означает «маленькая». Предыдущая модель V4-Flash от DeepSeek использовала бэкэнд на 284B с 13B активных параметров. V4.1-Flash увеличивает бэкэнд до 552B, то есть примерно на 94%. Активация на префиле снижается с 13B до 8B, но активация при генерации фактически вырастает с 13B до 16B.
При этом 552B описывают лишь бэкэнд: в техническом отчете DeepSeek отдельно указаны 196B параметров в модулях условной памяти Engram с разреженным доступом.
Этот компромисс вызвал скептицизм среди разработчиков, обсуждающих релиз. Один из комментаторов в обсуждении <запуска на Hacker News задался вопросом, является ли модель на 552B «уже не совсем flash»>>, отметив, что ее гораздо больший общий объем делает локальное развертывание значительно более ресурсоемким, даже если разреженная активация и архитектура кэширования повышают эффективность обслуживания.
Эта критика полезна, но она не столько опровергает заявление DeepSeek об эффективности, сколько уточняет его.
V4.1-Flash не компактнее V4-Flash по общему количеству весов. Она спроектирована так, чтобы потреблять меньше вычислительных ресурсов при приеме токенов и значительно меньше памяти для хранения длинных контекстов. Для разработчиков, приобретающих инференс у DeepSeek, это может трансформироваться в более низкие цены на API. Для команд, планирующих самостоятельно развертывать веса по лицензии MIT, скачок с 284B до 552B делает аппаратное уравнение гораздо менее дружелюбным.
Технический отчет представляет собой важный противовес критике в духе «она просто стала больше». В DeepSeek утверждают, что CED эффективно сокращает вычисления префила вдвое для достаточно длинных последовательностей, в то время как FLOPs декодирования одного токена увеличиваются всего примерно на 25% при увеличении длины контекста в 256 раз — с 4K до 1 миллиона токенов. Иными словами, веса V4.1-Flash стали больше, но DeepSeek спроектировала объем работы, связанной с растущим контекстом, так, чтобы он масштабировался гораздо медленнее.
Существует и соответствующая оговорка. DeepSeek прямо заявляет, что новая архитектура создает границы надежности, которые компания еще не охарактеризовала полностью. По заявлению компании, потенциальные ошибки разреженного отбора CSA2 и приближенное восстановление состояния, используемое в SWA Bounded Replay, могут привести к деградации возможностей в неипробованных краевых случаях (edge cases), особенно в отношении разреженного извлечения данных на очень длинных контекстах и границ возобновления кэша. DeepSeek заявляет, что не наблюдала систематической деградации в собственных тестах, но планирует дополнительное стресс-тестирование.
В собственном релизе DeepSeek даже рекомендует организациям, заинтересованным в крупномасштабном развертывании, связаться с компанией, если у них есть ресурсы порядка 2 000 графических процессоров (GPU) плюс кластер хранения данных.
Бенчмарки многообещающие, но форма рабочей нагрузки важнее
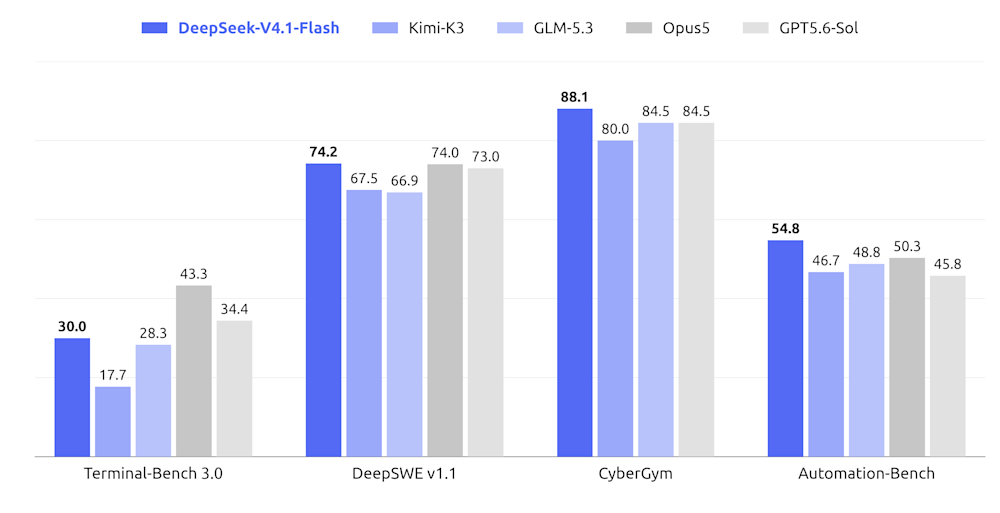
DeepSeek сообщает о результате 74,2 балла в тесте DeepSWE v1.1, что немного опережает 74,0 балла для Claude Opus 5 и 73,0 балла для GPT-5.6 Sol, заявленные компанией. Она также сообщает о результатах V4.1-Flash в 88.1 балла на CyberGym и 54.8 балла на AutomationBench.
Источник: DeepSeek
Это результаты оценок, проведенных самой DeepSeek, и они не демонстрируют единоличного доминирования во всех аспектах. Opus 5 опережает V4.1-Flash со счетом 43,3 против 30,0 на Terminal-Bench 3.0 и 51,8 против 31,2 на Terminal-Bench 4.0, в то время как GPT-5.6 Sol лидирует в таблице DeepSeek по тестам GPQA Diamond и SEC-Bench Pro.
Внутри этих заглавных баллов скрыта еще одна переменная затрат: глубина рассуждений (reasoning effort). DeepSeek запускала сравнительную таблицу при максимальной настройке усилий на уровне 100. Согласно собственным тестам компании, увеличение этого параметра с 25 до 100 поднимает результат DeepSWE v1.1 с 66,0% до 74,2%, а Terminal-Bench 2.1 — с 82,4% до 90,6%, но при этом расходуется примерно в 2,5 раза больше выходных токенов. В DeepSeek отмечают, что прирост носит фронтальный характер: уровни усилий от 60 до 80 восстанавливают большую часть точности максимального режима при бюджете токенов менее половины от максимального, в то время как финальный шаг до 100 делает траектории агента в 1,6–1,8 раза длиннее при сравнительно небольшом приросте.
Это порождает еще одно практическое решение о маршрутизации для разработчиков. DeepSeek предоставляет публичные пресеты API low, high и max, соответствующие значениям усилий рассуждения 50, 75 и 100. Таким образом, команда, оптимизирующая затраты на успешное выполнение одной задачи, может обнаружить, что оптимальная точка работы модели кроется вовсе не в конфигурации с максимальными усилиями, стоящей за ее позициями в таблице лидеров.
Ранние данные от третьих сторон, предоставленные VentureBeat, указывают скорее на ту же тезу о соотношении цены и производительности, а не на чистое лидерство в интеллекте.
В OpenDesign заявили, что V4.1-Flash достигла 98% от показателя качества GPT-6 Astra при 1,4% от его стоимости на наборе повседневных дизайнерских запросов компании. Это узкоспециализированная сторонняя рабочая нагрузка, а не общая оценка модели, но она подкрепляет аргументы в пользу тестирования успешной работы в расчете на доллар, а не только позиций в бенчмарках.
Есть и еще одна производственная оговорка, которую следует заметить разработчикам. DeepSeek вывела из эксплуатации V4-Flash и V4-Flash-Vision-Exp и временно перенаправляет их существующие идентификаторы на V4.1-Flash. Компания также заявляет, что начиная с 14 сентября вызовы по адресу deepseek-v4-pro будут перенаправляться на V4.1-Flash до появления V4.1-Pro.
Эта политика вызвала отдельную волну критики со стороны разработчиков на Hacker News, которые утверждали, что изменение лежащей в основе существующего производственного идентификатора модели может нарушить регрессионное тестирование, даже если замена номинально является более качественной или дешевой. Для команд с жестко настроенными промптами и поведением агентов миграция моделей остается вещью, которую необходимо тестировать, а не принимать на веру.
Релиз с фокусом на соотношение цены и производительности в знаковый момент
Запуск также происходит на фоне расширения коммерческих амбиций DeepSeek. Reuters сообщил на этой неделе, что компания привлекла CITIC Securities в рамках подготовки к возможному листингу на Шанхайской бирже STAR Market. Источники Reuters также сообщали, что текущий раунд сбора средств может оценить DeepSeek в сумму до 500 миллиардов юаней (примерно $75 миллиардов).
Этот контекст повышает ставки вокруг релиза, основное предложение которого заключается не столько в победе во всех бенчмарках, сколько в снижении стоимости запуска производительных моделей в масштабе.
Для разработчиков V4.1-Flash ставит более конкретный вопрос, чем просто проверка того, создала ли DeepSeek очередного дешевого пограничного конкурента. Полезный тест заключается в том, является ли рабочая нагрузка интенсивной по вводу, повторяющейся и кэшируемой в достаточной степени, чтобы задействовать ее тракт префила на 8B параметров и гораздо меньший KV-кэш, и перевешивают ли эта экономия почти удвоившийся объем весов модели и тракт декодирования, который теперь активирует 16B параметров.
Технический отчет добавляет в это уравнение еще одну переменную: выигрывает ли рабочая нагрузка от максимальных усилий рассуждения настолько, чтобы оправдать примерно 2,5-кратное потребление выходных токенов, или же средняя настройка усилий обеспечивает лучший результат по стоимости задачи.
Для создателей агентов это именно тот бенчмарк, который имеет значение: не просто интеллект на токен, а выполненная работа на кэшированный токен, в секунду и на доллар.