


DeepSeek только что выпустила две невероятно мощные модели ИИ, которые соперничают с GPT-5, и они абсолютно бесплатны


Китайский ИИ-стартап DeepSeek выпустил две мощные новые модели искусственного интеллекта, которые, по заявлению компании, не уступают по своим возможностям GPT-5 от OpenAI и Gemini-3.0-Pro от Google, — событие, способное перекроить конкурентный ландшафт между американскими технологическими гигантами и их китайскими соперниками.
Базирующаяся в Ханчжоу компания представила DeepSeek-V3.2, разработанную как повседневный ассистент для логических рассуждений, а также DeepSeek-V3.2-Speciale — высокопроизводительный вариант, завоевавший золотые медали на четырех престижных международных соревнованиях: Международной математической олимпиаде 2025 года, Международной олимпиаде по информатике, Финале чемпионата мира ICPC и Китайской математической олимпиаде.
Этот релиз имеет далеко идущие последствия для технологического лидерства США. DeepSeek в очередной раз доказала, что способна создавать передовые ИИ-системы вопреки экспортным ограничениям США, которые ограничивают доступ Китая к передовым чипам Nvidia, причем компания сделала свои модели абсолютно бесплатными по лицензии с открытым исходным кодом MIT.
«Люди думали, что DeepSeek совершила разовый прорыв, но мы вернулись с гораздо большим масштабом», — написал в X (бывший Twitter) Чэнь Фан, назвав себя контрибьютором проекта. Релиз вызвал бурную реакцию в сети: один из пользователей заявил: «Покойся с миром, ChatGPT».
Как прорыв DeepSeek в области разреженного внимания снижает вычислительные затраты
В основе нового релиза лежит разреженное внимание DeepSeek (DeepSeek Sparse Attention — DSA) — инновационное архитектурное решение, которое драматически снижает вычислительную нагрузку при работе ИИ-моделей с длинными документами и сложными задачами.
Традиционные механизмы внимания в ИИ — ключевая технология, позволяющая языковым моделям понимать контекст — плохо масштабируются по мере увеличения длины входных данных. Обработка документа вдвое большей длины обычно требует в четыре раза больше вычислений. Подход DeepSeek преодолевает это ограничение с помощью так называемого «индексатора молний», который определяет только наиболее релевантные части контекста для каждого запроса, игнорируя остальное.
Согласно техническому отчету DeepSeek, DSA сокращает затраты на инференс примерно вдвое по сравнению с предыдущими моделями при обработке длинных последовательностей. В отчете отмечается, что архитектура «существенно снижает вычислительную сложность, сохраняя при этом производительность модели».
Обработка 128 000 токенов — что примерно эквивалентно 300-страничной книге — теперь обходится примерно в $0,70 за миллион токенов на этапе декодирования по сравнению с $2,40 для предыдущей модели V3.1-Terminus. Это представляет собой 70-процентное сокращение затрат на инференс.
Модели с 685 миллиардами параметров поддерживают контекстные окна объемом 128 000 токенов, что делает их пригодными для анализа объемных документов, кодовых баз и научных статей. В техническом отчете DeepSeek отмечается, что независимые оценки на бенчмарках с длинным контекстом показывают: V3.2 работает на уровне своего предшественника или превосходит его, «несмотря на использование механизма разреженного внимания».
Результаты бенчмарков, поставившие DeepSeek в один ряд с GPT-5
Заявления DeepSeek о паритете с ведущими американскими ИИ-системами основаны на масштабном тестировании в области математики, программирования и логических задач, и эти цифры впечатляют.
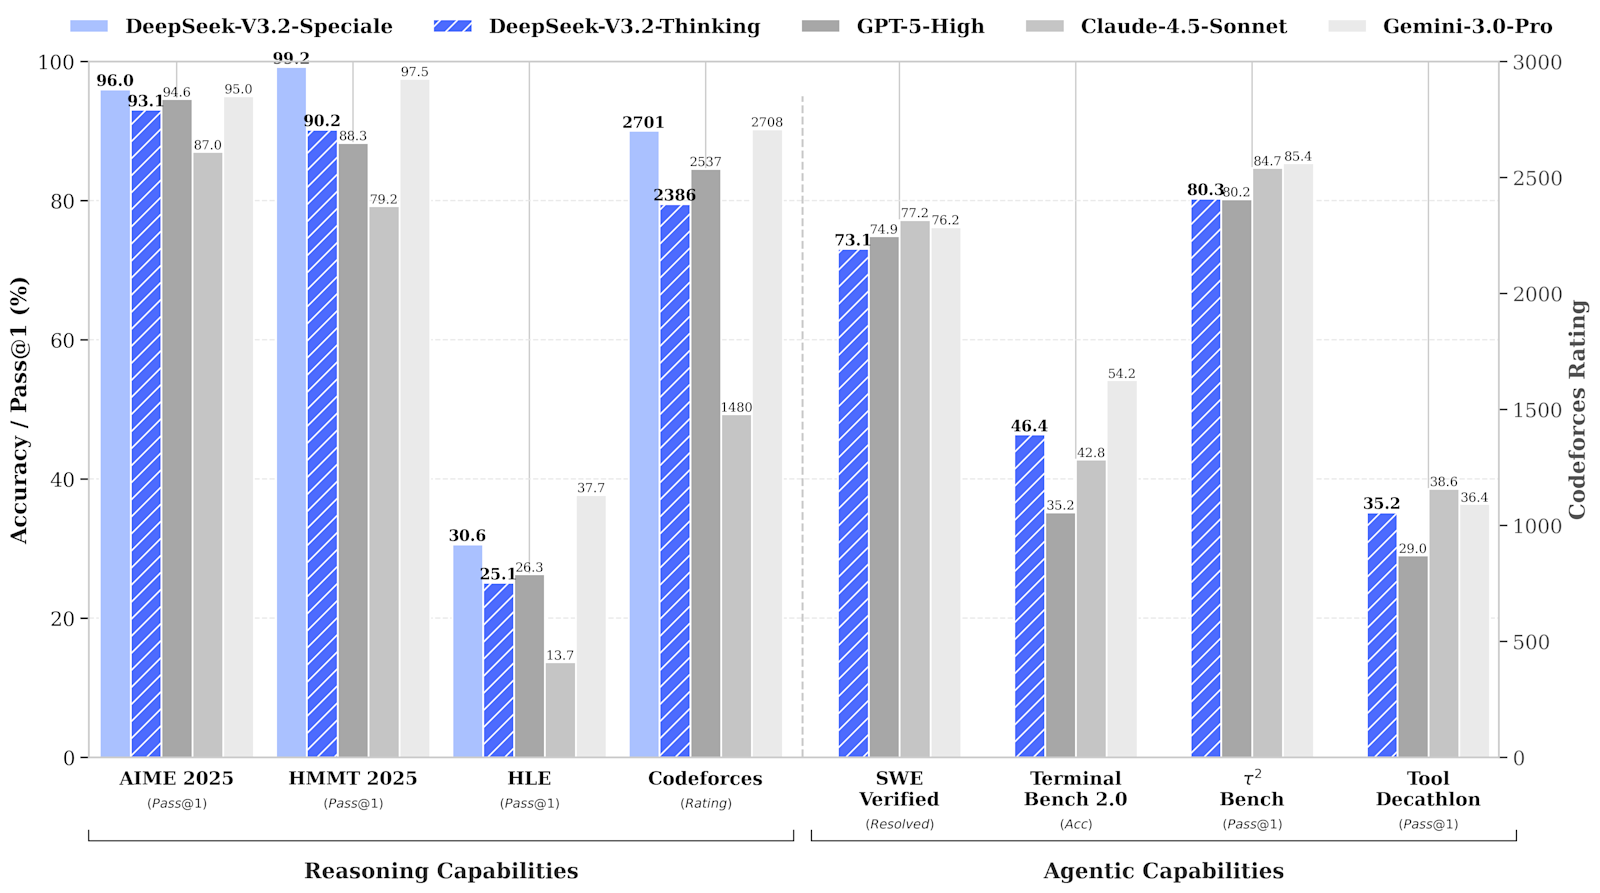
В AIME 2025, престижном американском математическом соревновании, DeepSeek-V3.2-Speciale показала результат в 96,0% правильных ответов по сравнению с 94,6% у GPT-5-High и 95,0% у Gemini-3.0-Pro. На Математическом турнире Гарварда-MIT версия Speciale набрала 99,2%, превзойдя результат Gemini в 97,5%.
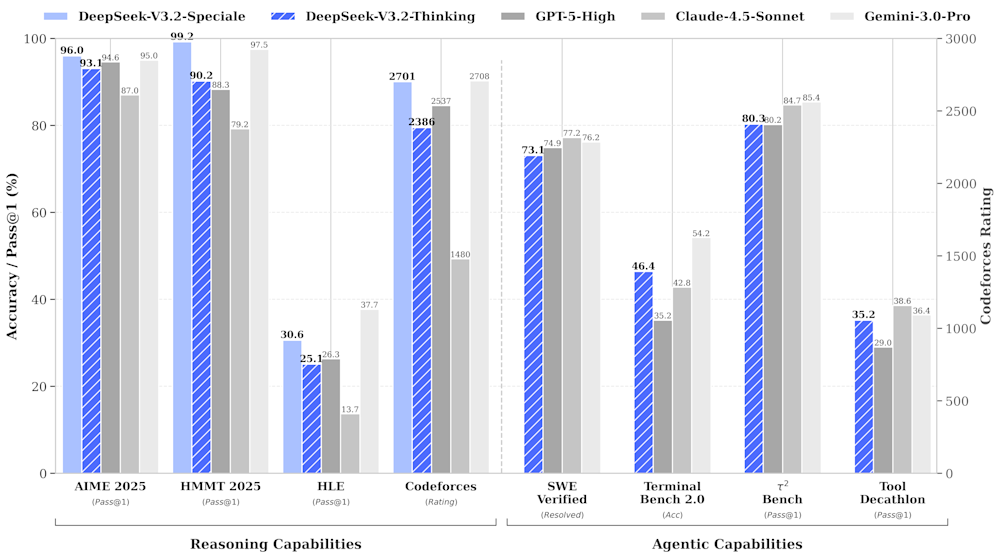
Источник: DeepSeek
Стандартная модель V3.2, оптимизированная для повседневного использования, набрала 93,1% в AIME и 92.5% в HMMT — немного отставая от передовых моделей, но достигнув этого с существенно меньшими вычислительными ресурсами.
Наиболее поразительны результаты соревнований. DeepSeek-V3.2-Speciale набрала 35 баллов из 42 возможных на Международной математической олимпиаде 2025 года, заслужив статус золотой медали. На Международной олимпиаде по информатике она набрала 492 балла из 600 — также золото, заняв 10-е место в общем зачете. Модель решила 10 из 12 задач на Финале чемпионата мира ICPC, заняв второе место.
Эти результаты были достигнуты без доступа к интернету или вспомогательным инструментам во время тестирования. В отчете DeepSeek указано, что «тестирование строго соответствует временным лимитам и ограничениям на попытки, установленным для соревнований».
В бенчмарках по программированию DeepSeek-V3.2 исправила 73,1% реальных программных ошибок в SWE-Verified, конкурируя с GPT-5-High (74,9%). В Terminal Bench 2.0, измеряющем сложные рабочие процессы программирования, DeepSeek набрала 46,4%, что значительно выше показателей GPT-5-High (35,2%).
Компания признает наличие ограничений. «Эффективность работы с токенами остается проблемой», — говорится в техническом отчете, где отмечается, что для достижения качества вывода Gemini-3.0-Pro для DeepSeek «обычно требуются более длинные траектории генерации».
Почему обучение ИИ мышлению в процессе использования инструментов меняет всё
Помимо базовых навыков рассуждения, DeepSeek-V3.2 представляет концепцию «мышления при использовании инструментов» (thinking in tool-use) — способность обдумывать проблемы, одновременно выполняя код, осуществляя поиск в Интернете и манипулируя файлами.
Предыдущие модели ИИ сталкивались с неприятным ограничением: каждый раз при вызове внешнего инструмента они теряли ход мыслей и были вынуждены возобновлять рассуждения с нуля. Архитектура DeepSeek сохраняет цепочку рассуждений при множественных вызовах инструментов, обеспечивая плавное многоэтапное решение задач.
Для обучения этой возможности компания создала массивный конвейер синтетических данных, сгенерировавший более 1800 различных сред задач и 85 000 сложных инструкций. Среди них были такие сложные задачи, как планирование многодневной поездки с ограничениями по бюджету, исправление программных ошибок на восьми языках программирования и веб-исследования, требующие десятков поисковых запросов.
В техническом отчете описывается один из примеров: планирование трехдневной поездки из Ханчжоу с ограничениями по ценам на отели, рейтингам ресторанов и стоимости достопримечательностей, которые варьируются в зависимости от выбора жилья. Такие задачи «сложно решить, но легко проверить», что делает их идеальными для обучения ИИ-агентов.
DeepSeek задействовала реальные инструменты во время обучения — актуальные API веб-поиска, среды программирования и блокноты Jupyter — одновременно генерируя синтетические промпты для обеспечения разнообразия. Результатом стала модель, способная адаптироваться к незнакомым инструментам и средам, что является критически важным навыком для развертывания в реальных условиях.
Гамбит DeepSeek с открытым исходным кодом может перевернуть бизнес-модель индустрии ИИ
В отличие от OpenAI и Anthropic, которые оберегают свои самые мощные модели как проприетарные активы, DeepSeek выпустила как V3.2, так и V3.2-Speciale по лицензии MIT — одной из самых мягких платформ с открытым исходным кодом.
Любой разработчик, исследователь или компания может скачивать, модифицировать и развертывать модели с 685 миллиардами параметров без ограничений. Полные веса моделей, код обучения и документация доступны на Hugging Face, ведущей платформе для обмена ИИ-моделями.
Стратегические последствия этого шага весьма значительны. Предоставляя модели передового уровня в свободный доступ, DeepSeek подрывает позиции конкурентов, взимающих высокую плату за доступ к API. В карточке модели на Hugging Face отмечается, что DeepSeek предоставила скрипты на Python и тестовые примеры, «демонстрирующие способ кодирования сообщений в формате, совместимом с OpenAI», что делает миграцию с конкурирующих сервисов предельно простой.
Для корпоративных клиентов ценностное предложение выглядит крайне привлекательно: производительность передового уровня при драматически сниженных затратах и гибкость развертывания. Однако проблемы с локализацией данных и регуляторная неопределенность могут ограничить внедрение в чувствительных сферах — особенно учитывая китайское происхождение DeepSeek.
В Европе и Америке вокруг DeepSeek возводятся регуляторные барьеры
Глобальная экспансия DeepSeek сталкивается со все возрастающим сопротивлением. В июне уполномоченный по защите данных Берлина Майке Камп заявила, что передача немецких пользовательских данных в Китай со стороны DeepSeek является «незаконной» в соответствии с нормами ЕС, призвав Apple и Google рассмотреть возможность блокировки приложения.
Немецкий регулятор выразил обеспокоенность тем, что «китайские власти имеют обширные права доступа к персональным данным в зоне влияния китайских компаний». В феврале Италия предписала DeepSeek заблокировать свое приложение. Законодатели США предприняли шаги по запрету этого сервиса на правительственных устройствах, сославшись на соображения национальной безопасности.
Сохраняются и вопросы относительно экспортных ограничений США, призванных сдерживать возможности Китая в сфере ИИ. В августе компания DeepSeek намекнула, что в Китае скоро появятся «новые поколения» отечественных чипов для поддержки ее моделей. Компания дала понять, что ее системы работают с чипами китайского производства от Huawei и Cambricon без какой-либо дополнительной настройки.
Сообщается, что оригинальная модель V3 от DeepSeek обучалась примерно на 2000 устаревших чипов Nvidia H800 — оборудование, экспорт которого в Китай впоследствии был ограничен. Компания не раскрывает, что именно обеспечивало обучение V3.2, однако ее непрерывный прогресс свидетельствует о том, что одни лишь экспортные ограничения не способны остановить развитие китайского искусственного интеллекта.
Что релиз DeepSeek означает для будущего конкуренции в сфере ИИ
Этот релиз происходит в переломный момент. После многих лет масштабных инвестиций некоторые аналитики задаются вопросом, не формируется ли пузырь на рынке ИИ. Способность DeepSeek соответствовать американским передовым моделям за малую долю их стоимости ставит под сомнение предположение о том, что для лидерства в сфере ИИ требуются огромные капитальные затраты.
В техническом отчете компании раскрывается, что инвестиции в этап после обучения (post-training) теперь превышают 10% от затрат на предварительное обучение — существенное вложение, которому приписывают улучшение логических способностей. Тем не менее DeepSeek признает пробелы: «Широта мировых знаний в DeepSeek-V3.2 все еще отстает от ведущих проприетарных моделей», — говорится в отчете. Компания планирует исправить это путем увеличения вычислительных мощностей предварительного обучения.
DeepSeek-V3.2-Speciale остается доступной через временный API до 15 декабря, после чего ее возможности будут интегрированы в стандартный релиз. Вариант Speciale разработан исключительно для глубоких рассуждений и не поддерживает вызов инструментов — ограничение, которое устранено в стандартной модели.
На данный момент гонка ИИ между США и Китаем вступила в новую фазу. Релиз DeepSeek демонстрирует, что модели с открытым исходным кодом способны достигать передовой производительности, инновации в области эффективности могут кардинально снизить издержки, а самые мощные ИИ-системы вскоре могут стать общедоступными для любого пользователя, имеющего подключение к интернету.
Как заметил один из комментаторов в X: «То, как Deepseek мимоходом бьет исторические бенчмарки, установленные Gemini, — это просто безумие».
Вопрос больше не в том, сможет ли китайский ИИ конкурировать с Кремниевой долиной. Вопрос в том, смогут ли американские компании сохранить свое лидерство, когда их китайский соперник раздает сопоставимые технологии бесплатно.




