


Cerebras утверждает, что ее чипы запускают ИИ-модель с триллионом параметров почти в 7 раз быстрее, чем облака на GPU


Менее чем через неделю после завершения крупнейшего технологического IPO 2026 года компания Cerebras Systems предпринимает самый агрессивный шаг за всю свою историю с целью завоевать быстро растущий рынок ИИ-инференса. В понедельник базирующийся в Саннивейле производитель чипов объявил о запуске модели Kimi K2.6 — открытой модели с триллионом параметров, разработанной пекинской компанией Moonshot AI — для корпоративных клиентов со скоростью почти 1000 токенов в секунду. Ни один провайдер на базе GPU даже близко не приблизился к таким показателям.
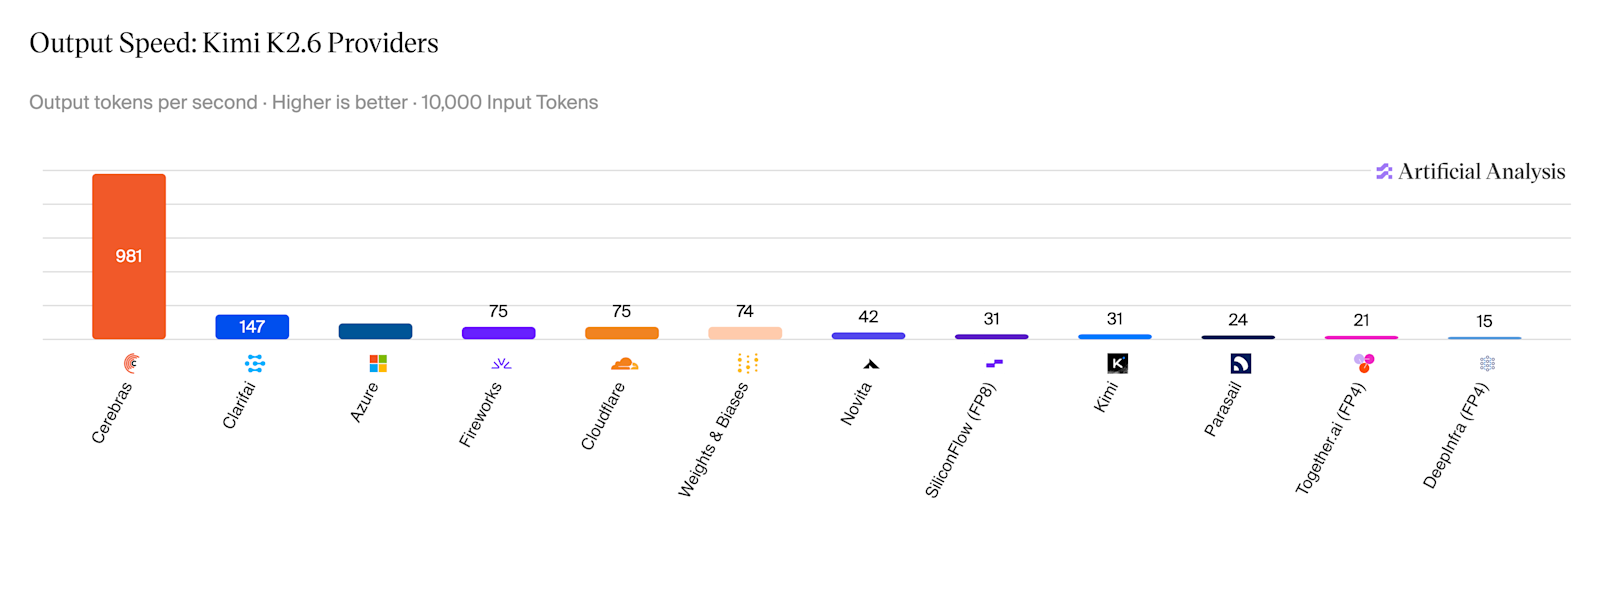
Результат, независимо подтвержденный аналитической фирмой Artificial Analysis, составил 981 выходной токен в секунду, что делает решение Cerebras в 6,7 раза быстрее ближайшего конкурента на базе GPU в облачном сегменте и в 23 раза быстрее медианного значения. Для стандартного запроса на агентное программирование, включающего 10 000 входных токенов, Cerebras выдала полный ответ — включая обработку промпта, рассуждения и 500 выходных токенов — за 5,6 секунды по сравнению с 163,7 секунды на официальном эндпоинте Kimi. Это 29-кратное улучшение времени до получения окончательного ответа.
«Мы действительно хотим внести полную ясность и показать, что способны работать с крупнейшими моделями», — заявил Джеймс Ван (James Wang), директор по продуктовому маркетингу Cerebras, в эксклюзивном интервью VentureBeat в преддверии анонса. — «В данном случае речь идет о Kimi K2.6 — MoE-модели с триллионом параметров на пластинчатой (wafer-scale) архитектуре, которая также работает на той самой невероятной скорости, которой мы славимся».
Этот анонс знаменует собой критический поворотный момент для Cerebras, которая долгое время боролась с укоренившимся мнением, будто ее нестандартные пластинчатые чипы, при всей их ослепительной скорости, способны справляться только с моделями малого и среднего размера. Kimi K2.6 — это первая модель с триллионом параметров и открытыми весами, которую компания когда-либо запускала в продакшн. Имея на руках свежую капитализацию в $95 млрд и $5,55 млрд выручки от IPO, сжигающих баланс, Cerebras дает понять Уолл-стрит, что намерена конкурировать не только на фронтире скорости, но и на фронтире масштаба моделей.
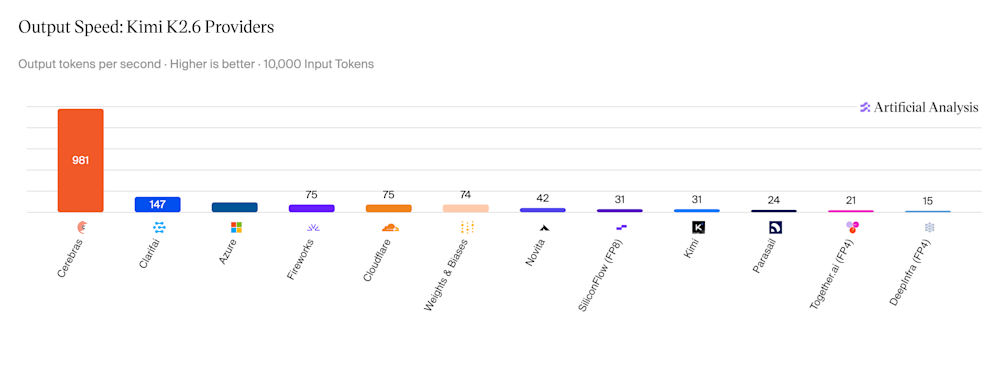
Достигнув скорости 981 выходного токена в секунду, Cerebras выдавала ответы Kimi K2.6 почти в семь раз быстрее ближайшего конкурента и более чем в 65 раз быстрее самого медленного. (Источник: Artificial Analysis)
Почему Cerebras выбрала модель китайской разработки в качестве своего флагмана с триллионом параметров
Выбор Kimi K2.6 отражает как техническую веху, так и коммерческий расчет. Выпущенная 20 апреля компанией Moonshot AI — базирующейся в Пекине структурой, основанной в 2023 году выпускниками Университета Цинхуа и входящей в число китайских компаний «ИИ-тигров» — K2.6 представляет собой Mixture-of-Experts (MoE) модель с триллионом параметров, которая быстро зарекомендовала себя как самая мощная модель с открытыми весами для программирования и выполнения агентских задач. Модель возглавляет чарт SWE-Bench Pro с результатом 58,6, опережая Claude Opus 4.6 и не уступая GPT-5.4, а также демонстрируя лидирующие результаты в таких агентских бенчмарках, как Humanity’s Last Exam и DeepSearchQA. Ее архитектура использует 32 миллиарда активируемых параметров на один токен из общего числа в 1 триллион, задействуя 384 эксперта, из которых 8 выбираются плюс 1 общий на проход вперед (forward pass), при работе в окне контекста на 256 000 токенов.
С практической точки зрения K2.6 — это одна из первых моделей с открытыми весами, которую предприятия могут использовать в качестве прямой замены дорогих и ограниченных по пропускной способности API с закрытым исходным кодом от Anthropic и OpenAI — в особенности для задач программирования и агентских рабочих нагрузок, которые стали наиболее ценными сценариями применения больших языковых моделей. Релиз версии 2.6 расширяет возможности K2.6 от фронтенд-дизайна до полностековых рабочих процессов, включая аутентификацию, операции с базами данных и выполнение долгосрочных задач агентами.
Ван прямо высказался о том, что движет интересом бизнеса. «Прежде всего, они очень мотивированы получить альтернативу Anthropic», — сказал он VentureBeat. — «Модели Anthropic великолепны. Я ими пользуюсь. Уверен, вы тоже ими пользуетесь. Но они довольно дорогие, и у них постоянно заканчиваются мощности». Он описал личный опыт, когда приложение, работающее на API Anthropic, вышло из строя на выходных из-за исчерпания лимитов мощности — анекдот, который, по его словам, находит глубокий отклик у корпоративных покупателей.
Тем не менее, геополитическое измерение этого шага заслуживает внимания. Kimi K2.6 — это модель китайской разработки, которую американский производитель чипов предоставляет американским корпоративным клиентам. Компания Moonshot AI базируется в Пекине, и внедрение K2.6 на Западе происходит в период повышенного внимания к китайским ИИ-компаниям на рынке США. Корпоративным покупателям со строгими требованиями к комплаенсу — особенно в сфере финансовых услуг, здравоохранения и обороны — придется оценивать этот аспект наряду с техническими возможностями модели.
Как пластинчатые чипы решают проблему скорости для триллионных моделей, с которой не справляются GPU
Чтобы понять, как Cerebras удается достигать таких скоростей, необходимо разобраться, чем ее аппаратное обеспечение принципиально отличается от всего остального на рынке. Большая часть инференса в сфере ИИ сегодня работает на кластерах графических процессоров Nvidia — как правило, организованных в стойки по 72 GPU, что Nvidia продвигает под названием конфигурации NVL72. В таких установках параметры модели распределяются по множеству дискретных чипов, соединенных высокоскоростной сетевой инфраструктурой. Данные должны постоянно перемещаться между чипами, и пропускная способность межсоединений между GPU становится узким горлышком, особенно для крупных моделей с сотнями миллиардов или триллионами параметров.
Cerebras применяет радикально иной подход. Ее процессор Wafer-Scale Engine 3 представляет собой единый чип размером с целую кремниевую пластину — примерно с обеденную тарелку — содержащий 44 гигабайта памяти SRAM прямо на кристалле. В отличие от высокоскоростной памяти, используемой в GPU, SRAM располагается непосредственно на процессоре, обеспечивая значительно меньшую задержку и более высокую пропускную способность при доступе к данным. Для Kimi K2.6 Cerebras хранит веса модели в их исходной 4-битной точности, выполняя вычисления с 16-битной плавающей запятой. Веса распределены по нескольким пластинам в кластере примерно из 20 систем CS-3, а активации передаются между ними в потоковом режиме. Что особенно важно, все эксперты для конкретного слоя MoE размещаются на одной пластине, а значит, все-ко-всем коммуникации (all-to-all), необходимые для маршрутизации экспертов, происходят на скоростях SRAM. Согласно техническому описанию Cerebras, сетевая фабрика на пластине обеспечивает пропускную способность, более чем в 200 раз превышающую возможности NVLink в NVL72.
Ван объяснил эту архитектуру с помощью аналогии. «Наши отдельные модули намного крупнее и обладают гораздо большей емкостью — они сопоставимы с 20 стойками, в отличие от 72 GPU», — сказал он. Каждый слой в трансформере может, по сути, одновременно обслуживать отдельного пользователя. «Они работают как очередь, как вы стоите в очереди за бубликами или вроде того — все они занимают разную часть «железа». Но поскольку они перемещаются так быстро, реальный опыт, токены в секунду для одного пользователя на вашей стороне остается прежним, к какому вы привыкли». В сочетании со специализированными ядрами и спекулятивным декодированием это позволяет Cerebras обслуживать MoE-модель с триллионом параметров со скоростью почти 1000 токенов в секунду — скорость, которую компания называет мировым рекордом, достижимым только с помощью пластинчатого оборудования.
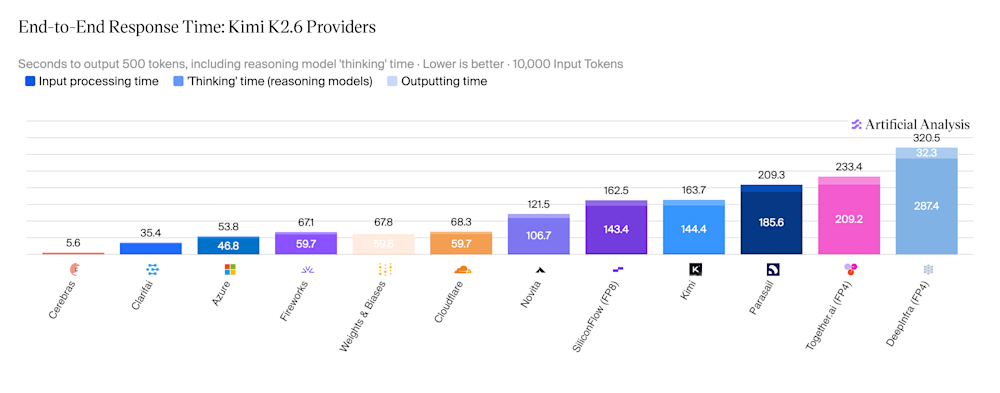
Cerebras сформировала ответ на 500 токенов от Kimi K2.6 за 5,6 секунды — более чем в шесть раз быстрее своего ближайшего конкурента Clarifai и примерно в 57 раз быстрее самого медленного из протестированных провайдеров. (Источник: Artificial Analysis)
Компании из списка Fortune 500 уже тестируют инференс триллионных моделей от Cerebras в продакшене
Cerebras не открывает доступ к K2.6 широкой публике. Вместо этого компания позиционирует решение как ориентированное в первую очередь на корпоративный сектор: компании из списка Fortune 500 в сфере программного обеспечения, финансовых услуг и здравоохранения в настоящее время проводят облачные испытания своих рабочих нагрузок на этой платформе. «Это бренды, о которых вы определенно слышали», — отметил Ван, хотя и воздержался от называния конкретных клиентов из соображений конфиденциальности.
Такой подход с упором на корпоративный сегмент выбран осознанно. Исторически Cerebras отдавала приоритет своим крупнейшим клиентам в ущерб потребительскому API, отчасти из-за ограничений аппаратных мощностей. «Все испытывают дефицит мощностей. Мы расставляем приоритеты в пользу корпоративных клиентов, поэтому мы не показываем модель на потребительском шлюзе или в API, где наблюдается очень непредсказуемый трафик, когда один пользователь фактически может захватить весь ваш кластер», — пояснил Ван. Обслуживание K2.6 также ограничивает возможности компании по одновременному предложению других крупных моделей. «Мы не можем одновременно запустить еще шесть других моделей, понимаете», — признал он. — «Это просто взаимное ограничение самой реальностью».
Говоря о ценообразовании, Ван отметил, что хотя корпоративное развертывание не имеет публичного прайс-листа, затраты компании в целом конкурентоспособны по сравнению с провайдерами на базе GPU. «На всех моделях, для которых у нас есть цены, стоимость весьма сопоставима — возможно, находится в среднем или средне-высоком диапазоне цен на GPU», — сказал он. — «Дело не в том, что раз мы работаем быстро, это стоит в много-много раз дороже». Тем не менее, он провел четкую границу в отношении нижнего сегмента рынка: если вы готовы запускать K2.6 со скоростью 20 токенов в секунду на дешевой инфраструктуре GPU, Cerebras не станет соревноваться по цене. «Мы автопроизводитель на рынке пикапов. Мы не работаем в том сегменте», — заявил Ван. Для чувствительных к скорости рабочих нагрузок — особенно агентского программирования, где разработчики в реальном времени ждут генерации и итерации кода от модели — ценностное предложение предельно простое: сопоставимая стоимость за токен, но на порядок более высокая скорость доставки.
Конкурентная угроза со стороны приобретения Groq компанией Nvidia за $20 млрд маячит на горизонте
Анонс Cerebras появляется в поворотный момент для индустрии чипов ИИ, когда рынок инференса стремительно обгоняет обучение в качестве наиболее коммерчески значимой вычислительной нагрузки. По мере распространения ИИ-агентов в корпоративном ПО скорость инференса напрямую определяет их практическую полезность — и конкурентное давление соответственно усиливается.
Самым значительным конкурентным событием последних месяцев стало приобретение компании Groq корпорацией Nvidia за $20 млрд — сделка, предоставившая гиганту GPU доступ к проприетарной технологии инференса, построенной на базе специализированных процессоров обработки языка (LPU). Ван прокомментировал эту сделку напрямую. «Я думаю, сейчас Nvidia чувствует, что быстрый инференс — это чрезвычайно важный рынок», — сказал он VentureBeat. — «Именно поэтому они готовы потратить $20 млрд на покупку такой компании».
Тем не менее, Ван выразил уверенность в долговечности архитектурных преимуществ Cerebras. И Nvidia, и Cerebras работают примерно в рамках годовых циклов обновления аппаратного обеспечения. «Мы обновляем «железо» периодически. Скоро вы услышите от нас кое-какие новости на этот счет», — намекнул Ван на грядущий анонс оборудования, не вдаваясь в подробности. Что касается программной составляющей, Ван указал на послужной список компании по быстрой адаптации к стремительно развивающейся экосистеме моделей с открытыми весами. «Мы начинали с Llama, поддержали все модели Qwen, а когда разработчики сказали нам, что им нужен GLM, мы запустили GLM. А теперь они говорят нам, что Kimi — лучшая, поэтому мы даем им Kimi», — сказал он. — «В то же время мы также поддерживали лучшие компании в запуске их закрытых моделей — OpenAI, Cognition, Mistral».
Упоминание OpenAI подчеркивает одну из самых необычных деловых связей в ИИ-индустрии. В начале 2026 года OpenAI и Cerebras заключили сделку, оцениваемую, по сообщениям, более чем в $20 млрд, на предоставление вычислительных мощностей и сопутствующих услуг. Ван подтвердил, что Cerebras обслуживает «будущие внутренние модели программирования OpenAI», но отказался раскрывать детали, поскольку ни одна из сторон пока публично не раскрыла технические нюансы соглашения.
План Cerebras: как обслуживать самые умные ИИ-модели быстрее остальных
Ван охарактеризовал развертывание K2.6 как ступеньку, а не конечную цель. Cerebras начала предоставлять услуги инференса в конце 2024 года с относительно небольших моделей и потратила больше года на масштабирование с 70 миллиардов до более чем 1 триллиона параметров. «Мы не могли запустить это в ноябре 2024 года», — сказал он. — «Но мы сделали это сейчас».
Следующая задача компании — перейти от обслуживания лучшей фронтирной модели с открытыми весами к обслуживанию лучших фронтирных моделей в целом, включая решения с закрытым исходным кодом от таких компаний, как Anthropic и OpenAI, которые занимают абсолютные вершины в таблицах лидеров интеллектуальных систем. «Это первая фронтирная модель с открытыми весами, для которой у нас есть четкие и продемонстрированные доказательства», — сказал Ван. — «Думаю, в течение года вы увидите, как мы обслуживаем настоящий фронтир — фронтир на той скорости, которой мы знамениты. И вы можете требовать с нас за это».
На вопрос о том, не перекроет ли текущий релиз темп аппаратных улучшений у Nvidia и других игроков, Ван отреагировал спокойно. «У Nvidia есть очень четкая дорожная карта. Они выступают каждый год на GTC. У них примерно ежегодный продуктовый цикл, как и у нас. Скоро вы услышите от нас новости на этот счет», — повторил он, намекнув на новое «железо» без уточнения деталей.
Он также затронул проблему зависимости от одного поставщика (vendor lock-in), которую не преминет поднять любой технический директор (CTO), оценивающий провайдера инференса с единственным вендором. «Эти компании редко полностью полагаются на одного поставщика», — отметил Ван. — «У них есть стратегии, гарантирующие, что часть трафика может идти к нам, часть — к кому-то еще, а между ними осуществляется балансировка нагрузки. Это не новая проблема. В целом именно так и управляются облачные ресурсы».
В конечном счете это предложение выходит далеко за рамки технических характеристик и скоростей. Ван видит будущее ИИ-индустрии в мире, где автономные агенты — а не разработчики-люди — являются основными потребителями вычислительных мощностей для инференса, и где скорость работы этих агентов определяет конкурентные результаты для развертывающих их компаний. «Мировая экономика сейчас фактически перестраивается вокруг агентов», — сказал Ван. — «Скорость определит, кто победит, а кто проиграет».
Это смелое заявление от компании, которая еще до прошлой недели никогда не торговалась на публичной бирже. Но для Cerebras логика проста: если будущее корпоративного ПО создается ИИ-агентами, которые мыслят со скоростью своего аппаратного обеспечения, то компания, предоставляющая самое быстрое «железо», обеспечивает и самое быстрое мышление. И на рынке, где предприятия тратят миллиарды, чтобы сбрить секунды со времени отклика ИИ, компания, способная запускать модель с триллионом параметров за время, необходимое для того, чтобы налить чашку кофе, вполне может обладать самым убедительным предложением в Кремниевой долине.




