


Anthropic представила «сновидения» — систему, которая позволяет ИИ-агентам учиться на собственных ошибках


Anthropic во вторник представила комплекс обновлений для своей платформы Claude Managed Agents в рамках второй ежегодной конференции разработчиков Code with Claude в Сан-Франциско. Компания анонсировала новую функцию под названием «мечты» (dreaming), которая позволяет ИИ-агентам учиться на собственных прошлых сессиях и совершенствоваться со временем. Это шаг к созданию самоисправляющихся и самосовершенствующихся систем ИИ, которых так ждали корпоративные клиенты, прежде чем доверить агентам рабочие задачи.
Компания также перевела две ранее экспериментальные функции — ожидаемые результаты (outcomes) и многоагентную оркестровку (multi-agent orchestration) — из стадии исследовательского превью в публичную бета-версию, сделав их широко доступными для разработчиков, создающих приложения на базе платформы Claude.
Ранние пользователи уже сообщают о значительных результатах. Юридическая ИИ-компания Harvey зафиксировала увеличение скорости выполнения задач примерно в 6 раз после внедрения функции «мечты». Компания по медицинскому документообороту Wisedocs сократила время проверки документов на 50% благодаря функции результатов. А Netflix теперь обрабатывает логи сотен сборок одновременно, используя многоагентную оркестровку.
Эти анонсы появились в момент невероятного подъема для Anthropic. Генеральный директор Дарио Амодей (Dario Amodei) в ходе беседы на конференции сообщил, что рост компании превзошел даже ее собственные агрессивные внутренние прогнозы.
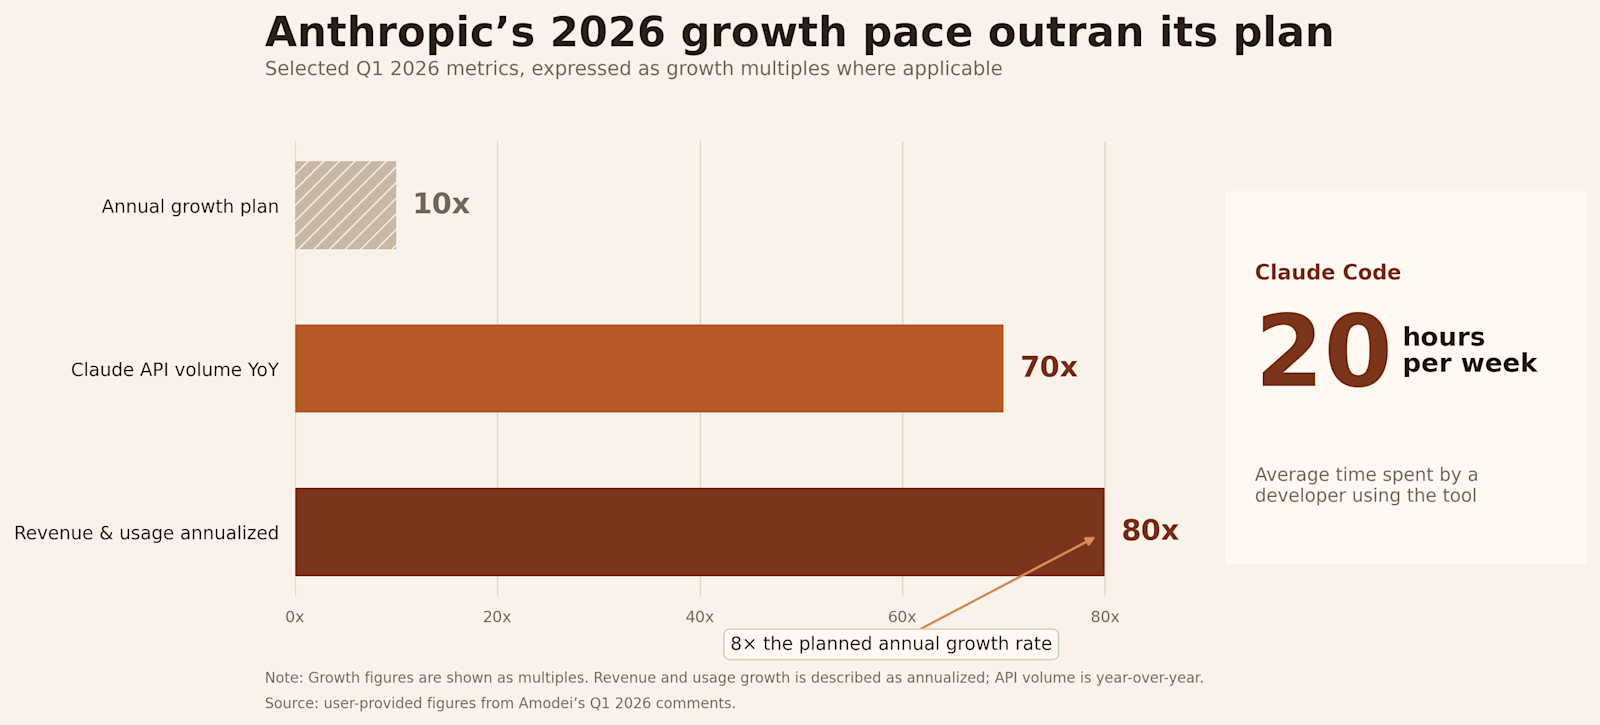
В первом квартале 2026 года Anthropic зафиксировала то, что Амодей охарактеризовал как 80-кратный годовой рост выручки и использования — что намного превысило 10-кратный ежегодный рост, который планировала компания. Объем API на платформе Claude вырос почти в 70 раз год к году, а средний разработчик, использующий Claude Code, теперь тратит 20 часов в неделю на работу с этим инструментом.
«Мы старались очень хорошо подготовиться к миру с 10-кратным ростом в год», — сказал Амодей. — «И тем не менее мы увидели 80-кратный. Именно поэтому у нас возникли проблемы с вычислительными мощностями».
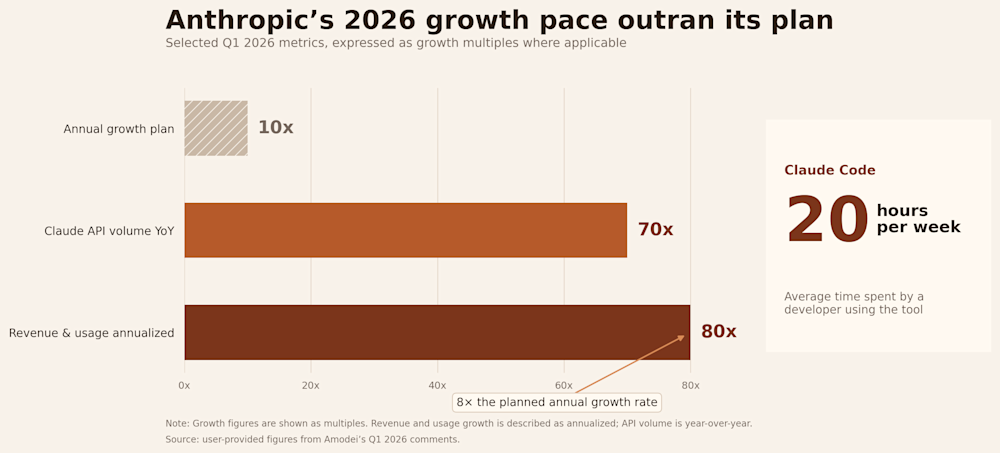
Фактический рост Anthropic в первом квартале 2026 года значительно опередил внутренний план компании. Вместо прогнозируемого 10-кратного ежегодного роста годовая выручка и объемы использования выросли в 80 раз. (Источник изображения: Майкл Нуньес / VentureBeat)
Как функция «мечты» от Anthropic учит ИИ-агентов извлекать уроки из собственной истории
«Мечты» — самая инновационная из трех функций, которую Anthropic стремится четко отделить от традиционных систем памяти. Хотя компания запустила память агентов ранее в этом году (что позволяет Claude сохранять предпочтения и контекст в рамках отдельных сессий и между ними), «мечты» работают на более высоком уровне абстракции. Это запланированный процесс, который анализирует прошлые сессии агента и хранилища памяти, извлекает из них общие паттерны и упорядочивает эти воспоминания, чтобы агенты со временем совершенствовались. Функция выявляет инсайты, которые ни одна отдельная сессия агента не смогла бы заметить самостоятельно: повторяющиеся ошибки, рабочие процессы, к которым несколько агентов приходят независимо друг от друга, и общие предпочтения команды агентов.
Алекс Альберт (Alex Albert), руководящий направлением управления продуктами в области исследований в Anthropic, объяснил эту концепцию в интервью на конференции. Он сравнил «мечты» с тем, как люди в организациях вырабатывают навыки после выполнения той или иной задачи. «Они могут выполнять рабочий процесс с Claude, и в конце этого процесса, после некоторых итераций и проб и ошибок, они хотят зафиксировать этот путь из точки А в точку Б», — сказал Альберт. — «С «мечтами» происходит очень похожая вещь: вместо того чтобы вы вручную создавали навык на основе своего опыта работы с Claude, это делает сама модель, перенося данный контекст на будущие сессии».
Что особенно важно, «мечты» не изменяют базовые веса модели. «Мы не меняем саму модель посредством «мечты» — здесь нет обновления весов или чего-то подобного», — пояснил Альберт. Вместо этого агент записывает полученные знания в виде заметок в обычном текстовом формате и структурированных «руководств» (playbooks), к которым будущие сессии могут обращаться. Это делает весь процесс прозрачным и доступным для проверки людьми. На вопрос о вопросах доверия к агентам, консолидирующим собственные знания, Альберт ответил, что «здесь необходим определенный уровень доверия», однако отметил, что все воспоминания доступны для инспекции, а более умные модели постепенно учатся управлять этим процессом все лучше и лучше. «Они учатся писать лучшие заметки для самих себя в будущем», — добавил он.
Живая демонстрация показала, как ИИ-агенты совершенствуются за ночь без участия человека
Во время основного доклада команда Anthropic продемонстрировала все три функции в прямом эфире на сцене, используя вымышленный аэрокосмический стартап Lumara, которому нужно было автономно посадить дроны на Луну для добычи ресурсов. Команда настроила многоагентную систему с тремя специалистами: агентом-командиром, отвечающим за общий успех миссии, агентом-детектором, определяющим площадки для посадки высокого качества, и агентом-навигатором, управляющим безопасным полетом и посадкой дрона. Были заданы критерии успеха, требующие мягкой посадки, чистой площадки и достаточного запаса топлива для обратного полета на Землю.
Первоначальная симуляция на шести гипотетических посадочных площадках дала хорошие, но несовершенные результаты. Чтобы улучшить показатели, докладчики запустили сеанс «мечты» прямо из консоли разработчика Claude. За ночь агент проанализировал все прошлые сессии симуляции и написал детальное руководство по спуску — исчерпывающий набор эвристик, основанных на паттернах множества запусков миссии. Когда на следующее утро команда запустила новую симуляцию, используя созданное в процессе «мечты» руководство, результаты на площадках, ранее показавших себя хуже всего, заметно улучшились.
«Все, что нам нужно было сделать, — это попросить Кейтлин нажать кнопку», — сказала Анджела Цзян (Angela Jiang), руководитель по продукту платформы Claude, имея в виду свою коллегу на сцене. — «И все благодаря «мечтам»».
Демонстрация наглядно показала, как эти три функции взаимодействуют на практике. Многоагентная оркестровка распределила сложную задачу между специалистами с независимыми контекстными окнами. Функция результатов предоставила критерии, по которым отдельный агент-оценщик оценивал каждый запуск. А функция «мечты» извлекла уроки из этих запусков для повышения эффективности в будущем, сформировав то, что Anthropic называет циклом непрерывного улучшения, не требующим вмешательства человека между итерациями.
Почему Anthropic создала отдельного агента-«оценщика» для проверки работы Claude
Функция результатов, находящаяся сейчас в публичной бета-версии, дает разработчикам возможность определять, как выглядит успех, с помощью критериев (структурного каркаса, стандарта презентации, голоса бренда или любого другого набора требований), после чего позволяет агенту автономно стремиться к этому стандарту. Архитектурная особенность результатов заключается в разделении ответственности. Когда агент завершает работу, отдельный агент-оценщик проверяет результат на соответствие заданным разработчиком критериям в своем собственном независимом контекстном окне. Поскольку оценщик работает в свежем контексте, на него не влияют рассуждения рабочего агента или накопившиеся за сессию предвзятости.
Когда оценщик находит несоответствия между результатом и заданными критериями, он точно указывает, что именно нужно изменить, и рабочий агент предпринимает еще одну попытку. Этот цикл продолжается до тех пор, пока критерии не будут выполнены — без необходимости для человека проверять каждую попытку.
Альберт охарактеризовал общую стратегию верификации Anthropic как использование «больших вычислительных ресурсов на этапе тестирования, когда несколько моделей дольше думают над проблемой, чтобы проверить работу друг друга». Он признал, что привлечение модели для проверки собственной работы вызывает закономерные вопросы, но отметил, что свежее контекстное окно, анализирующее уже завершенную работу, неизменно превосходит попытки заставить ту же долго работающую цепочку искать собственные ошибки. «Вы получите лучший результат, если передадите этот вывод новому экземпляру Claude и скажете: «какие ошибки ты здесь видишь?»» — сказал он. По его словам, сохраняется проблема «затухания внимания» при очень длинных сессиях — ограничение, над устранением которого Anthropic активно работает для будущих моделей.
Этот подход отражает стратегии, уже используемые в GitHub. Марио Родригес (Mario Rodriguez), директор по продукту в GitHub, рассказал во время отдельного выступления на конференции, как Copilot использует аналогичный паттерн советника с моделями Claude: меньшая, более дешевая модель выступает в роли исполнителя, а более крупная — в роли наставника. Когда меньшая модель сталкивается с проблемой, выходящей за рамки ее возможностей, она обращается за советом к крупной модели, а затем продолжает выполнять задачу самостоятельно. Родригес отметил,URIComponent Этот подход обеспечивает уровень интеллекта, близкий к Opus, со значительно меньшими затратами, а GitHub встраивает модели критики в три ключевые точки процесса написания кода: после составления плана, после сложной реализации и после написания тестов, но перед их запуском.
Параллельные ИИ-агенты теперь могут решать задачи, слишком сложные для одной цепочки модели
Многоагентная оркестровка, третья функция, переходящая в публичную бета-версию, позволяет ведущему агенту разбивать крупную задачу на подзадачи и делегировать каждую из них специализированному агенту, у каждого из которых есть своя модель, системный промпт, инструменты и независимое контекстное окно. Каждый шаг этого процесса можно проследить в консоли Claude: видно, какой агент, что именно сделал, в каком порядке и почему.
Такой подход обеспечивает каждому субагенту изолированный контекст, что, по данным Anthropic, дает лучшие результаты, чем попытка одного агента удерживать всю сложность в рамках единой цепочки. «У каждого субагента есть своя независимая цепочка и контекстное окно», — пояснили докладчики. — «Это сделано намеренно: мы обнаружили, что разделение работы с последующим объединением результатов дает лучшие исходы».
Альберт предложил собственное правило для определения того, когда многоагентные архитектуры имеют смысл, а когда лучше оставаться в рамках одной цепочки. «Параллельные агенты лучше подходят для исследований», — сказал он, имея в виду ситуации, когда обрабатывается большой объем контекста, который в итоге будет отброшен. «Если вы пытаетесь ответить на конкретный вопрос, вам не нужны все результаты поиска из областей, где ответ не был найден. Вам нужен только сам ответ».
Он описал практику запуска одноразовых субагентов для специфических задач извлечения данных и возврата в основную цепочку только финального результата. По его словам, в будущем сама модель будет решать, когда распараллеливать задачи. «В дальнейшем вам будет все равно, один это агент, несколько или что-то еще. Вы просто общаетесь с Claude, а нужная архитектура развернется автоматически».
Главная ставка Anthropic: сокращение разрыва между возможностями ИИ и внедрением в реальном мире
Эти три функции являются частью масштабного продвижения платформы, которое Anthropic позиционирует на конференции как преодоление «разрыва между тем, что ИИ может делать, и тем, что он реально делает для людей». Ами Вора (Ami Vora), директор по продукту Anthropic, задала эту тему в своем вступительном слове, отметив, что, хотя возможности моделей развиваются по экспоненте, большинство организаций до сих пор внедряют ИИ по линейной траектории.
Дианна Пенн (Dianne Penn), руководящая разработкой продуктов для исследовательской команды Anthropic, назвала мерой прогресса компании «горизонт задач» — то, как долго ИИ-агент может работать автономно, повышая при этом качество результатов. «В это же время в прошлом году модели могли работать считанные минуты», — сказала она. — «Теперь у большинства из нас есть агенты, работающие часами напролет. Завтра у нас появятся агенты, которые будут проактивными, работающими постоянно и знающими, чем заняться, без потери контекста».
Мероприятие также включало несколько анонсов инфраструктурного характера, призванных помочь разработчикам не отставать от темпов. Anthropic объявила об удвоении пятичасовых лимитов для тарифных планов Pro, Max, Team и Enterprise, а также о существенном повышении лимитов API. Компания сообщила о партнерстве со SpaceX с целью задействовать полные мощности дата-центра Colossus для расширения доступных вычислительных ресурсов — это прямой ответ на дефицит мощностей, о котором говорил Амодей.
Все три функции встроены в Claude Managed Agents, запущенную в публичную бета-версию 8 апреля в качестве готового набора инструментов, объединяющего передовые практики, включая память, интеграцию инструментов и обработку действий. В Anthropic заявляют, что команды, использующие Managed Agents, выпускают продукты в 10 раз быстрее тех, кто строит собственную инфраструктуру агентов с нуля. Альберт описал эту платформу с помощью аналогии с операционной системой: «Используя управляемых агентов, вам не нужно думать обо всех технических деталях настройки окружающей системы», — сказал он. — «Создавая приложение для Mac, вы же не хотите заново реализовывать каждую деталь macOS».
Что функции «мечты», результатов и многоагентной оркестровки значат для будущего корпоративного ИИ
Конкурентные последствия этого шага значительны. В условиях, когда платформы ИИ-агентов от OpenAI, Google и других борются за внимание разработчиков, Anthropic делает ставку на надежность в продакшене — а не только на «сырой» интеллект моделей, — что и определит, какая платформа завоюет корпоративные бюджеты. Функция «мечты» в особенности открывает новые горизонты: в то время как другие платформы предлагают память и использование инструментов, идея систематического анализа агентами собственной истории для извлечения пригодных для повторного использования знаний продвигает отрасль ближе к самосовершенствующимся системам, необходимым бизнесу перед делегированием критически важных задач.
На конференции были представлены компании, уже работающие на таком уровне. Mercado Libre, крупнейшая платформа электронной коммерции в Латинской Америке, задействовала 23 000 инженеров, использующих Claude Code. Они проверили более 500 000 пулл-реквестов с участием человека и нацелены на достижение 90% автономного кодирования к третьему кварталу текущего года. Shopify внедрила Claude Code не только в инженерных отделах, но и в командах дизайна, продуктовых разработок и науки о данных.
Однако именно Дарио Амодей сформулировал наиболее масштабное видение того, к чему все это ведет. Он описал переход от единых агентов к множеству агентов и целому организационному интеллекту — от «команды умных людей в комнате» к тому, что он назвал «страной гениев в дата-центре». Он также подтвердил сделанный примерно год назад прогноз о том, что в 2026 году появится первая компания стоимостью в миллиард долларов, управляемая всего одним человеком. «Этого пока не произошло», — сказал он. — «Но у нас есть еще семь месяцев».
Функция «мечты» уже доступна в рамках исследовательского превью. Функции результатов и многоагентной оркестровки находятся в публичной бета-версии и доступны всем разработчикам на платформе Claude. Будет ли семи месяцев достаточно для того, чтобы основатель-одиночка построил миллиардный бизнес, остается открытым вопросом, но после вторника у них появилось на несколько инструментов больше.




