


ИИ-коэффициент интеллекта оценивает топ-50 языковых моделей
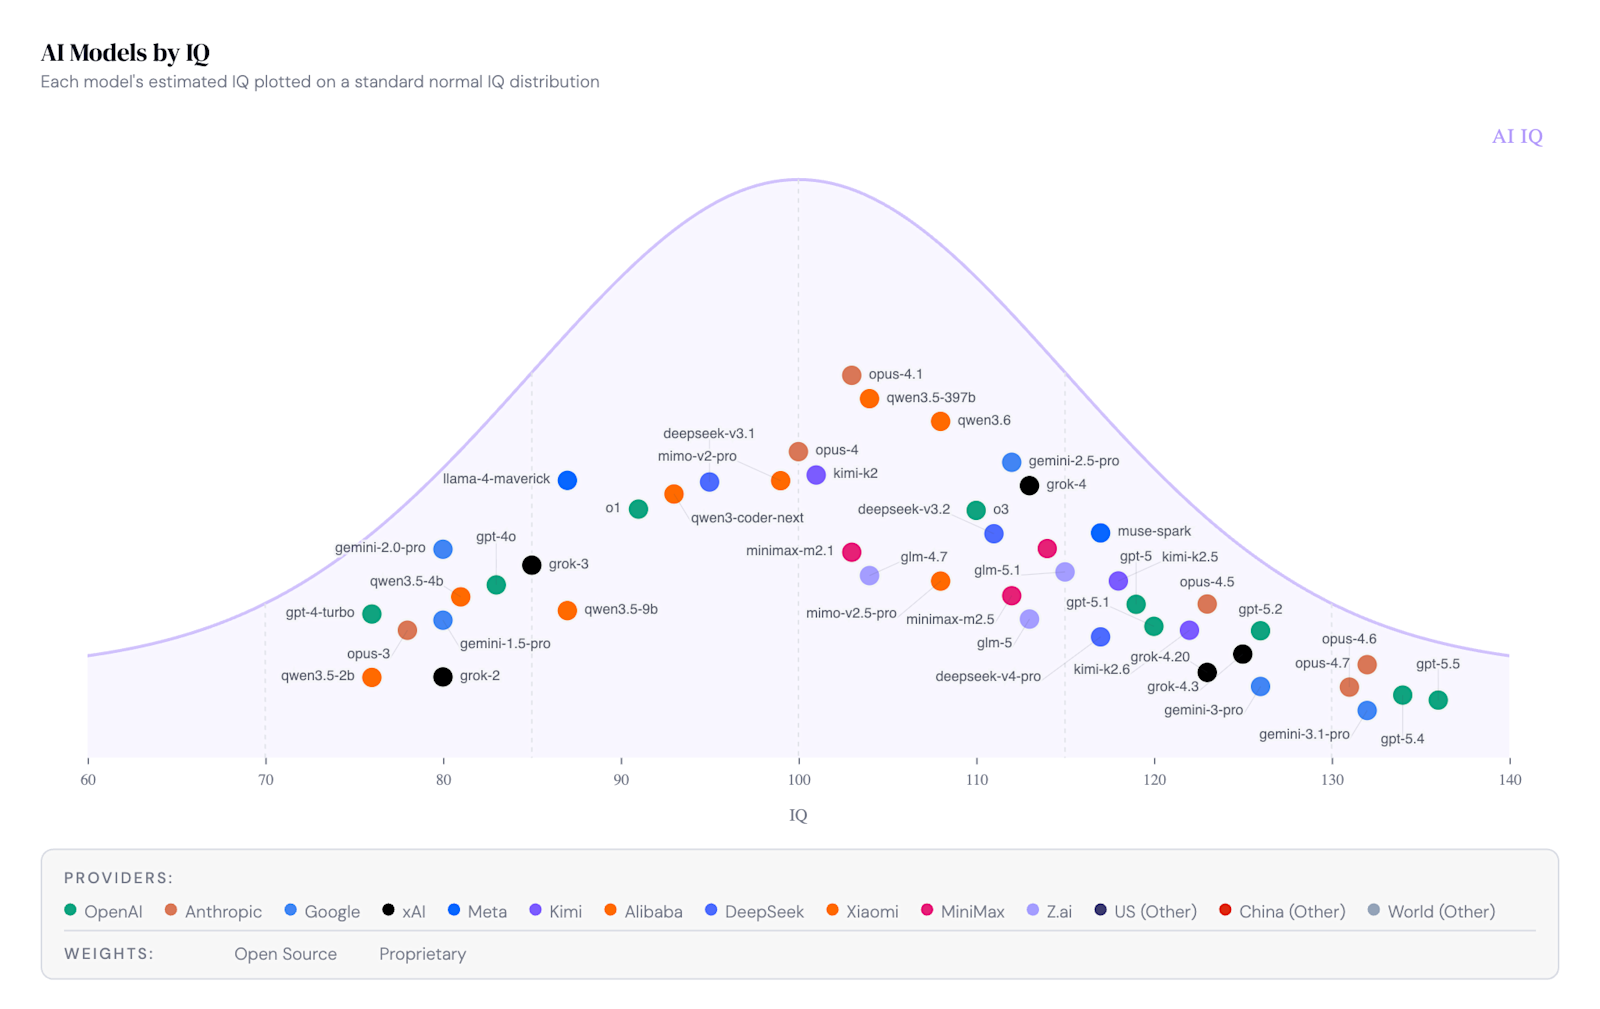


На протяжении десятилетий тест на IQ оставался одним из самых привычных и в то же время самых спорных мерил человеческого интеллекта. Теперь стартап-проект под названием AI IQ применяет ту же метафору к искусственному интеллекту, присваивая примерные коэффициенты интеллекта более чем 50 самым мощным языковым моделям в мире и распределяя их по стандартной колоколообразной кривой.
Результатом стал набор интерактивных визуализаций на сайте aiiq.org, которые на прошлой неделе стремительно разошлись по социальным сетям. Они вызвали похвалу со стороны корпоративных технологов, заявляющих, что графики делают невероятно сложный рынок понятным, и резкую критику со стороны исследователей и обозревателей, предупреждающих, что вся эта концепция вводит в заблуждение.
«Это суперполезно, — написал Тибо Мелен (Thibaut Mélen), технический обозреватель, в соцсети X. — Гораздо проще понять прогресс моделей, когда он отображен вот так, а не в виде очередной гигантской таблицы лидеров».
Брайан Веллмур (Brian Vellmure), бизнес-стратег, высказал аналогичную поддержку: «Это полезно. По личным наблюдениям, совпадает с практическим опытом».
Но негативная реакция последовала незамедлительно. «Это бред. ИИ слишком фрагментарен. Карта — это не территория», — написал пользователь AI Deeply, аккаунт, посвященный обзорам искусственного интеллекта. Это высказывание отразило опасения, разделяемые многими исследователями: сведение широких и неравномерных возможностей языковой модели к единственному числу создает опасную иллюзию точности.
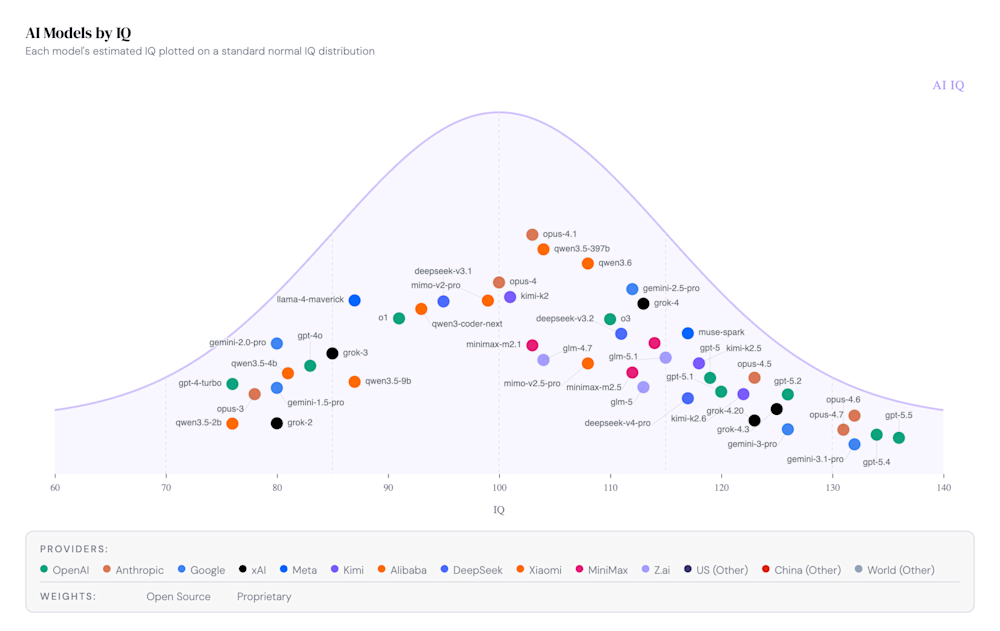
Более 50 языковых моделей ИИ, размещенных на стандартной колоколообразной кривой IQ сайтом AI IQ. Наиболее способные модели скапливаются в правом хвосте распределения. (Источник: AI IQ)
Двенадцать бенчмарков, четыре измерения и одно спорное число: как на самом деле работает AI IQ
Проект AI IQ был создан Райаном Ши (Ryan Shea), инженером, предпринимателем и бизнес-ангелом, наиболее известным как сооснователь блокчейн-платформы Stacks. Ши также является сооснователем Voterbase и инвестировал на ранних этапах в несколько компаний-единорогов, включая OpenSea, Lattice, Anchorage и Mercury. Он имеет степень бакалавра наук в области машиностроения Принстонского университета.
Методология сайта опирается на обманчиво простую формулу. AI IQ объединяет 12 бенчмарков в четыре измерения рассуждений: абстрактное, математическое, программное и академическое. Составной IQ представляет собой прямое среднее арифметическое результатов по этим четырем измерениям: IQ = ¼ (IQ_Abstract + IQ_Math + IQ_Prog + IQ_Acad).
Измерение абстрактного мышления опирается на ARC-AGI-1 и ARC-AGI-2 — печально известные своей сложностью тесты на распознавание образов, разработанные для проверки общего жидкого интеллекта. Математическое мышление включает в себя FrontierMath (уровни 1–3 и уровень 4), AIME и ProofBench. Программное мышление использует Terminal-Bench 2.0, SWE-Bench Verified и SciCode. Академическое мышление задействует Humanity’s Last Exam, CritPt и GPQA Diamond.
Каждый сырой результат бенчмарка сопоставляется с предполагаемым IQ с помощью того, что сайт описывает как «откалиброванные вручную кривые сложности». Что особенно важно, методология сжимает верхние пределы для бенчмарков, которые считаются более простыми или более подверженными загрязнению данных, предотвращая завышение оценок выше 100. Более сложные и менее поддающиеся манипуляциям бенчмарки сохраняют более высокие потолки. Система также консервативно обрабатывает пропущенные данные: моделям нужны результаты как минимум по двум из четырех измерений, чтобы получить расчетный IQ, и в случае отсутствия бенчмарков конвейер намеренно занижает оценки, а не завышает их. На сайте указано, что «каждый вычисленный IQ усредняет все четыре измерения, поэтому отсутствие данных не может сделать модель лучше за счет упущения».
OpenAI лидирует на кривой распределения, но разрыв между ведущими моделями ИИ еще никогда не был столь мал
По состоянию на середину мая 2026 года графики AI IQ рассказывают историю стремительной конвергенции на вершине технологического авангарда и растущего разнообразия в нижестоящих категориях.
Согласно графику динамики пограничного IQ (Frontier IQ Over Time), GPT-5.5 от OpenAI в настоящее время находится на пике колоколообразной кривой с расчетным IQ около 136 — это самый высокий показатель среди всех отслеживаемых моделей. За ней следуют GPT-5.4 (примерно 131), Opus 4.7 от Anthropic (примерно 132) и Opus 4.6 (примерно 129). Модель Gemini 3.1 Pro от Google располагается около отметки 131, что делает группу лидеров чрезвычайно плотной.
Такое сжатие уникально не только для платформы AI IQ. Издание Visual Capitalist, опираясь на отдельный рейтинг на базе тестов Mensa от TrackingAI, недавно отметило ту же динамику, подчеркнув, что «главный вывод заключается в том, насколько сжалась верхушка таблицы лидеров». В этой шкале Grok-4.20 Expert Mode и GPT 5.4 Pro разделили первое место с показателем 145, а Gemini 3.1 Pro набрала 141 балл.
Ниже группы лидеров графики AI IQ демонстрируют плотную «середину поля». Модели от китайских лабораторий — Kimi K2.6, GLM-5, DeepSeek-V3.2, Qwen3.6, MiniMax-M2.7 — группируются в диапазоне примерно от 112 до 118 баллов, что делает ценовую категорию соотношения цены и качества все более конкурентоспособной для корпоративных покупателей, которым не нужна абсолютно лучшая модель для каждой задачи. Один из пользователей X, ovsky, отметил, что эти данные «подтверждают опыт использования sonnet 4.6 в качестве настоящей рабочей лошадки по сравнению с opus 4.5», указав на то, как графики могут подтвердить интуицию специалистов, которую часто упускают общие рейтинги.
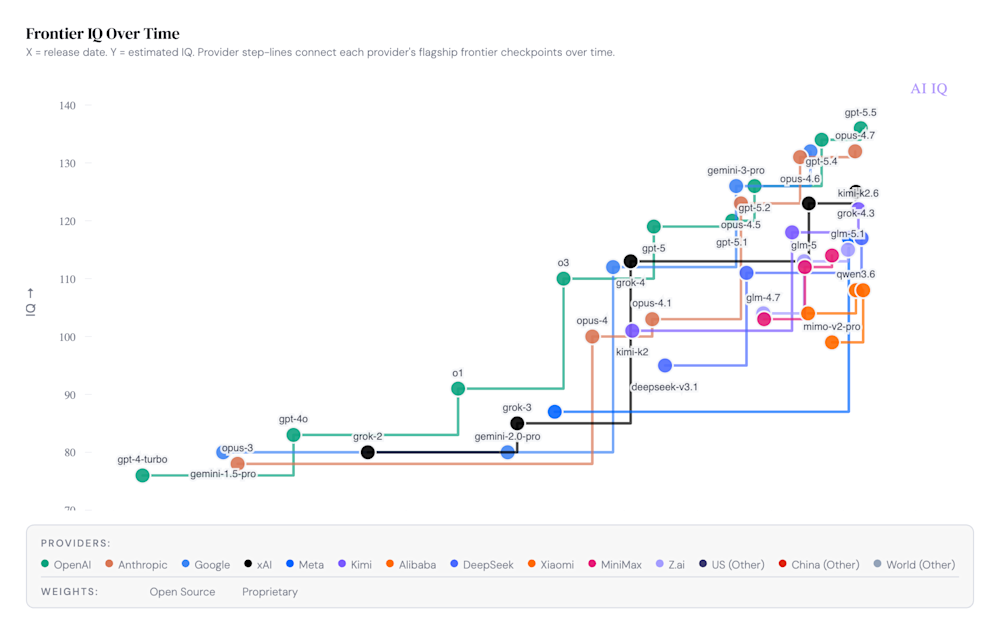
Траектория развития передовых моделей ИИ с октября 2023 года по середину 2026 года по данным AI IQ. Ступенчатые линии, окрашенные в цвета провайдеров, соединяют флагманские релизы каждой лаборатории, показывая прирост примерно на 60 пунктов расчетного IQ за 30 месяцев. (Источник: AI IQ)
Почему оценки эмоционального интеллекта становятся новым полем битвы в рейтингах ИИ-моделей
Что отличает AI IQ от большинства других бенчмаркинговых проектов, так это включение показателя «EQ» — эмоционального интеллекта. На сайте сопоставляются результаты моделей в тестах EQ-Bench 3 (по системе Эло) и Arena Elo для получения предполагаемого EQ с использованием откалиброванных кусочно-линейных шкал, после чего берется взвешенная композитная оценка 50/50.
Оценки EQ дают существенно иной рейтинг, чем один лишь IQ. На диаграмме рассеяния IQ и EQ модель Opus 4.7 от Anthropic лидирует по EQ с результатом около 132, переходя в верхний правый квадрант — самую желанную позицию, свидетельствующую как о высоком когнитивном, так и о высоком эмоциональном интеллекте. GPT-5.5 и GPT-5.4 от OpenAI группируются в зоне высокого IQ, но немного отстают по EQ. Gemini 3.1 Pro от Google занимает прочные позиции посередине по обеим осям.
Один примечательный методологический выбор привлек к себе внимание: EQ-Bench 3 оценивается моделью Claude от Anthropic, что, как признает сам сайт, «создает потенциальную предвзятость оценок в пользу моделей Anthropic». Для исправления этого AI IQ вычитает штраф в 200 пунктов Эло из компонента EQ-Bench для всех моделей Anthropic перед сопоставлением с предполагаемым EQ. Компонент Arena остается без изменений, так как в нем используются человеческие судьи. Такая самокоррекция необычна для мира бенчмарков и намекает на то, что Ши осознает методологическое минное поле, на которое он ступил. Тем не менее, измерение EQ улавливает то, чего один IQ не может: растущую важность разговорных качеств, сотрудничества и доверия в моделях, развертываемых для работы с пользователями.
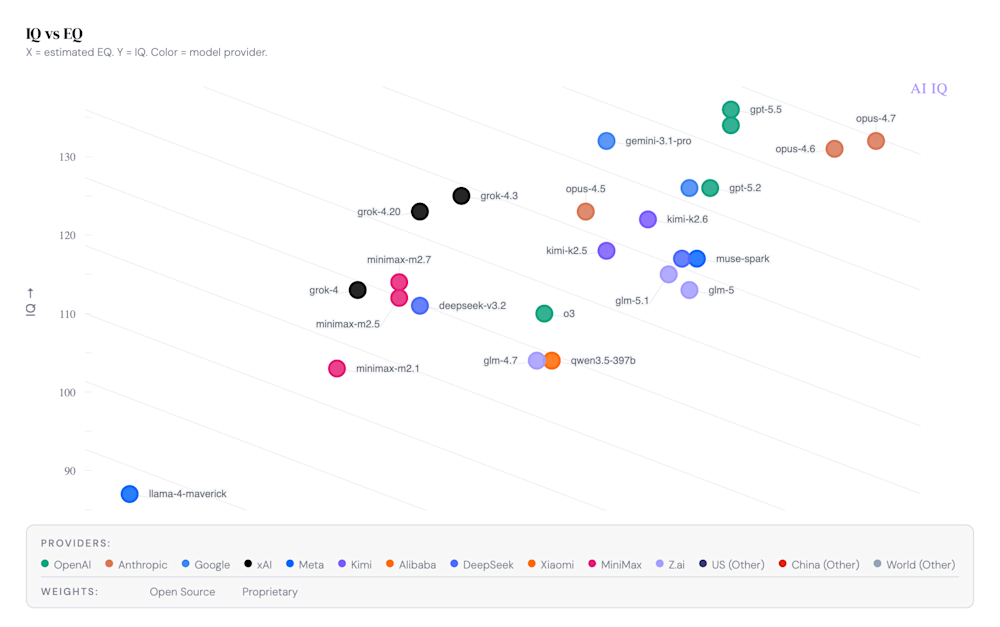
Сопоставление IQ и EQ показывает, что самые умные модели не всегда обладают наибольшим эмоциональным интеллектом. Opus 4.7 от Anthropic доминирует в верхнем правом квадранте. (Источник: AI IQ)
График соотношения затрат и производительности ИИ, который действительно нужно увидеть корпоративным покупателям
Пожалуй, наиболее практичным графиком на сайте является не колоколообразная кривая, а диаграмма рассеяния IQ против эффективной стоимости. На ней сопоставляется предполагаемый IQ каждой модели с метрикой «эффективной стоимости», определяемой как стоимость токенов для задачи с использованием 2 миллионов входных и 1 миллиона выходных токенов, помноженная на коэффициент эффективности использования.
График демонстрирует знакомый паттерн в корпоративных технологиях: лучшие модели не всегда являются самыми выгодными. GPT-5.5 и Opus 4.7 занимают верхний левый угол — высокий IQ, высокая стоимость, причем эффективные затраты на задачу превышают $30 и $50 соответственно. Между тем, такие модели, как GPT-5.4-mini, DeepSeek-V3.2 и MiniMax-M2.7, занимают выгодную позицию посередине: уважаемые показатели IQ от 112 до 120 при эффективных затратах примерно от $1 до $5 за задачу. На самом дешевом краю спектра GPT-oss-20b (открытая модель от OpenAI) фигурирует с эффективной стоимостью около $0.20 и IQ около 107, что потенциально делает ее наиболее экономичным вариантом для массовой классификации или извлечения данных.
Сайт также предлагает 3D-визуализацию, одновременно отображающую IQ, EQ и эффективную стоимость. Пунктирная линия, проходящая через куб, указывает на идеал: более высокий IQ, более высокий EQ и более низкую стоимость. Модели у «зеленого конца» этой оси представляют собой более выгодные универсальные предложения; те, что у «красного конца», жертвуют возможностями, экономичностью или тем и другим сразу. Для директоров по информационным технологиям, изучающих счета за API, вывод очевиден: разрыв в интеллекте между моделью за $50 и моделью за $3 сократился настолько, что маршрутизация (использование дорогих моделей для сложных задач и дешевых для всего остального) больше не является опциональной. Это доминирующая архитектура для серьезных внедрений ИИ.
Критики утверждают, что «фрагментарные» возможности ИИ делают единый показатель IQ опасным заблуждением
Самое громкое возражение против AI IQ носит философский характер, и оно бьет в самую суть. Критики утверждают, что сведение неравномерных возможностей модели к единому баллу скрывает больше, чем открывает.
«IQ как прокси уходит в прошлое — мы наблюдаем всплески плотности рассуждений, которые не соотносятся с g-фактором», — написал Zaya, технологический обозреватель, в соцсети X. — «GPT-5.5 уже достигла насыщения на MMLU-Pro, но все еще проваливает ClockBench в 50% случаев».
Это наблюдение затрагивает то, что исследователи ИИ называют проблемой «фрагментарного интеллекта» (jaggedness): большие языковые модели часто демонстрируют дико неравномерные способности, преуспевая в физике уровня аспирантуры и при этом проваливая задачи, с которыми справился бы ребенок. Составной балл может затушевать эти пробелы.
Пользователь X под ником Pressureangle опубликовал более детальную критику, заявив об «абсолютном отсутствии прозрачности» и утверждая, что сайт так до конца и не раскрывает, как именно создавались или проверялись его калибровочные кривые. Справедливости ради стоит отметить, что AI IQ действительно перечисляет свои 12 бенчмарков и демонстрирует форму каждой калибровочной кривой в своем методологическом окне. Но исходные данные и точные математические преобразования не публикуются в виде открытых наборов данных — этот пробел имеет значение для исследователей, привыкших к полностью воспроизводимым методам.
Другие подвергли сомнению саму исходную посылку. «Столь же бесполезно, как тестирование человеческого IQ», — написал haashim в X. Шубхэм Шарма (Shubham Sharma), писатель в области ИИ и технологий, предложил конструктивную альтернативу: «Почему бы не заставить модели пройти официальный тест (уровня MENSA)? Разве это не был бы самый точный и наиболее „сопоставимый с человеком“ способ оценки интеллекта?» Такой подход уже существует благодаря TrackingAI, которая предлагает языковым моделям пройти тест на IQ Норвежского общества Менса. Но тесты в стиле Mensa измеряют лишь абстрактное распознавание образов, в то время как AI IQ пытается создать более широкий композитный показатель, охватывающий кодинг, математику и академические рассуждения. Как отметил Visual Capitalist, «бенчмарк в стиле IQ охватывает лишь один срезок возможностей». У каждого подхода есть свои компромиссы, и победа в этом споре еще никому не досталась.
Настоящая гонка идет не за наивысший балл, а за умнейший стек моделей
Несмотря на все дебаты о методологии, самым важным сигналом в данных AI IQ может быть вовсе не результат какой-то отдельной модели, а форма рынка, которую обнажают эти графики.
В настоящее время через API доступны более 50 моделей пограничного класса как минимум от 14 крупных провайдеров из США, Китая и Европы. Каждый провайдер публикует собственные бенчмарки, часто специально отобранные для демонстрации сильных сторон. В результате получается Вавилонская башня, где ни одна компания не измеряет одно и то же одинаковым образом. Академические исследования подчеркивают, что «большинство бенчмарков привносят предвзятость, фокусируясь на определенном типе домена», а график Frontier IQ Over Time на AI IQ показывает, как быстро смещаются цели: в октябре 2023 года GPT-4-turbo находилась на уровне расчетного IQ около 75. К началу 2026 года лучшие модели приближались к 135 — это примерно 60 пунктов улучшения за 30 месяцев.
Такой темп поднимает фундаментальный вопрос о том, способна ли вообще какая-либо система оценки за ним поспеть. Сайт сжимает верхние пределы для насыщенных бенчмарков, но по мере того, как модели продолжают исчерпывать лимиты даже самых сложных тестов — ARC-AGI-2, FrontierMath Tier 4, Humanity’s Last Exam, — структура столкнется с теми же эффектами потолка, которые преследовали каждую оценку ИИ до нее. Коннор Форсайт (Connor Forsyth) указал на эту динамику в X: «ARC AGI 3 не согласна», — написал он, ссылаясь на бенчмарк нового поколения, который, возможно, уже подрывает текущие оценки.
AI IQ несовершенен. Его методология частично непрозрачна. Его метафора IQ может вводить в заблуждение. А его создатель признает известные искажения, вероятно, упуская из виду другие. Но альтернатива — продираться сквозь десятки специфичных для провайдеров таблиц бенчмарков, каждая из которых использует разные наборы тестов и соглашения об оценке — еще хуже. Сайт предлагает корпоративным покупателям нечто по-настоящему дефицитное: единую структуру для сравнения моделей по провайдерам, измерениям и ценовым категориям, регулярно обновляемую и обладающую достаточными нюансами, чтобы показать: правильный ответ на вопрос «какая модель лучше?» почти всегда звучит как «зависит от задачи».
Как размышлял Дебдут Гош (Debdoot Ghosh) в X после просмотра графиков: «Теперь роль человека заключается лишь в оркестрации?»
Возможно. Но если данные AI IQ что-то и показывают предельно ясно, так это то, что оркестрация — знание о том, какую модель задействовать, когда и по какой цене — превратилась в отдельную форму интеллекта. И для нее бенчмарка пока еще не существует.




