ИССЛЕДОВАНИЕ — Судный день для агентов: у корпоративного ИИ проблемы с временем выполнения
Источник: VentureBeat · VB Staff


В первом квартале 2026 года в рамках серии исследований Pulse Research издание VentureBeat выявило «мираж управления» (Governance Mirage) — разрыв между организационными схемами управления, которые предприятия нарисовали на бумаге, и реально созданными ими уровнями контроля. Сорок три процента респондентов заявили, что за управление ИИ отвечает централизованная команда; 23% не смогли прийти к единому мнению о том, кто именно за это отвечает; а 31% назвали непрозрачность вендоров главным препятствием.
Эта новая волна исследования задает следующий вопрос: как только вы признаете проблему управления, что ломается в первую очередь при попытке ее решить? Ответ наших респондентов недвусмыслен. Точкой отказа является вовсе не модель. Это среда выполнения (runtime).
Предприятия обнаруживают, что ИИ-агенты, построенные на бессостояниевой (stateless) инфраструктуре — скриптах на Python, цепочках LangChain, спонтанной оркестрации — не выживают в суровых производственных реалиях. Перезапуски контейнеров стирают контекст. Затраты на токены подрывают экономическое обоснование проектов. Галлюцинации на Шаге 3 накладываются друг на друга и приводят к катастрофическим сбоям к Шагу 12. При этом большинство инженерных команд тратят больше времени на управление этой «сантехникой», чем на создание интеллекта, который должен был оправдать инвестиции.
Результаты этого опроса рисуют картину индустрии, оказавшейся на критической развилке. Организации, которые переживут «эру расплаты агентов» (Agentic Reckoning), — это те, которые будут относиться к надежности среды выполнения как к первостепенной инженерной задаче, а не как к второстепенному вопросу, который можно залатать повторными попытками (retries) и промптингом. Те же, кто этого не сделает, окажутся там же, где RPA (роботизированная автоматизация процессов) оставила предприятия десятилетие назад: на кладбище удачных пилотных проектов, которые не смогли пережить второй день.
Методология
VentureBeat провел этот опрос в мае 2026 года в рамках своей постоянной серии исследований Pulse Research, посвященной внедрению агентного ИИ на предприятиях. Респонденты фильтровались по критерию численности персонала: организации с 100 и более сотрудниками. Итоговая квалифицированная выборка состоит из 132 проверенных, высококвалифицированных технологических лидеров, находящихся на переднем крае развертывания корпоративных ИИ-агентов.
Они представляют следующие роли:
|
Директора по ИИ / аналитике (8%) |
Директора по инжинирингу / ИТ (16%) |
|
Вице-президенты по данным / ИИ / аналитике (5%) |
Вице-президенты по инжинирингу / ИТ (5%) |
|
ИТ-директора, технические директора, директора по информационной безопасности (CIO/CTO/CISO) (15%) |
Менеджеры по продуктам и программам (13%) |
|
Консультанты (9%) |
Инженеры по программному обеспечению и машинному обучению (9%) |
|
Корпоративные архитекторы (8%) |
Другое (12%) |
Представленные отрасли включают технологии и ПО (42%), финансовые услуги (20%), профессиональные услуги (8%), здравоохранение и медико-биологические науки (7%), ритейл и потребительский сектор (6%), образование (4%) и другие.
Учитывая наши строгие критерии отбора, эта когорта представляет собой надежный и авторитетный срез тенденций в развивающейся агентной инфраструктуре.
Демография респондентов по размеру компаний:
-
Крупный бизнес (10 000+ сотрудников): 35% выборки
-
Средний и крупный бизнес (500–9 999 сотрудников): 48% выборки
-
Растущий бизнес (100–499 сотрудников): 17% выборки
Эти количественные данные отражают критический момент в эволюции инфраструктуры и лучше всего воспринимаются в комплексе с отчетами VentureBeat по управлению за первый квартал 2026 года и нашими глубокими беседами с практиками, проведенными в течение квартала.
Вывод 1: Среда выполнения (runtime) — это главная проблема
Дебаты о «позвоночнике против мозга» окончены
Фундаментальный вопрос корпоративного ИИ в 2026 году заключается в том, кроются ли сбои агентов в способностях модели к рассуждению — в «Мозге» (Brain), — или в неспособности инфраструктуры среды выполнения управлять состоянием, переживать сбои и координировать выполнение — в «Позвоночнике» (Spine). Мы задали этот вопрос нашим респондентам напрямую.
Проблемы интеграции и управления оказались главной трудностью, но проблемы «Позвоночника» отставали совсем ненамного.
Вывод 1 — Среда выполнения (runtime) — это главная проблема
|
47% говорят, что реальное трение заключается в разрыве интеграции и управления (Integration/Governance Gap) — нехватке стандартизированной соединительной ткани (например, MCP) для безопасного управления доступом к данным между агентами и корпоративными системами |
37% говорят, что сбои — это в первую очередь проблема «Позвоночника» (Spine): бессостояниевая инфраструктура слишком хрупка для продакшна |
17% говорят, что «Мозг» — это основной источник сбоев: передовым моделям все еще не хватает надежности уровня «Системы 2», необходимой для сложных краевых случаев (edge cases), когда рабочие процессы превышают 10+ шагов рассуждения |
Тем не менее, 17% по-прежнему считают «Мозг» основным источником сбоев. Это не погрешность округления — это сигнал. Организации в этой когорте не оспаривают проблему инфраструктуры; они говорят нам, что сами модели еще недостаточно надежны для тех краевых случаев, которые генерируют их рабочие процессы. Дебаты между моделью и средой выполнения носят поищем трехсторонний характер. Если объединить эти ответы, они не противоречат друг другу полностью. Лагери «Позвоночника» и «Разрыва» борются с инфраструктурой и управлением соответственно. Когорта «Мозга» борется с чем-то более фундаментальным: надежностью рассуждений в масштабе.
Это важная находка. Войны передовых моделей — GPT-5 против Claude 4.7 против Grok — поглощают огромное количество внимания в корпоративной технологической прессе. Наши респонденты говорят нам, что эта война на данный момент второстепенна. Модели достаточно умны, а вот инфраструктура вокруг них — нет.
«Модели достаточно умны, но наша бессостояниевая инфраструктура слишком хрупка для управления долгоиграющими многошаговыми агентными процессами.»
— Директор по инжинирингу / ИТ, финансовые услуги, 10 000–49 999 сотрудников
Вывод 2: Налог на самописные решения съедает команды заживо
Инженерный ресурс уходит на сантехнику, а не на интеллект
Если «Позвоночник» является главной точкой сбоя, во что это обходится на практике? Мы спросили респондентов, какой процент еженедельного инженерного потенциала их команды уходит на создание и поддержку кастомной «сантехники» — ручных перезапусков, персистентности состояния, чекпоинтов — вместо реальной логики агентов.
Результаты выявляют рынок, разделившийся на два четких лагеря, с опасной серединой.
Вывод 2 — Налог на самописные решения съедает команды заживо
|
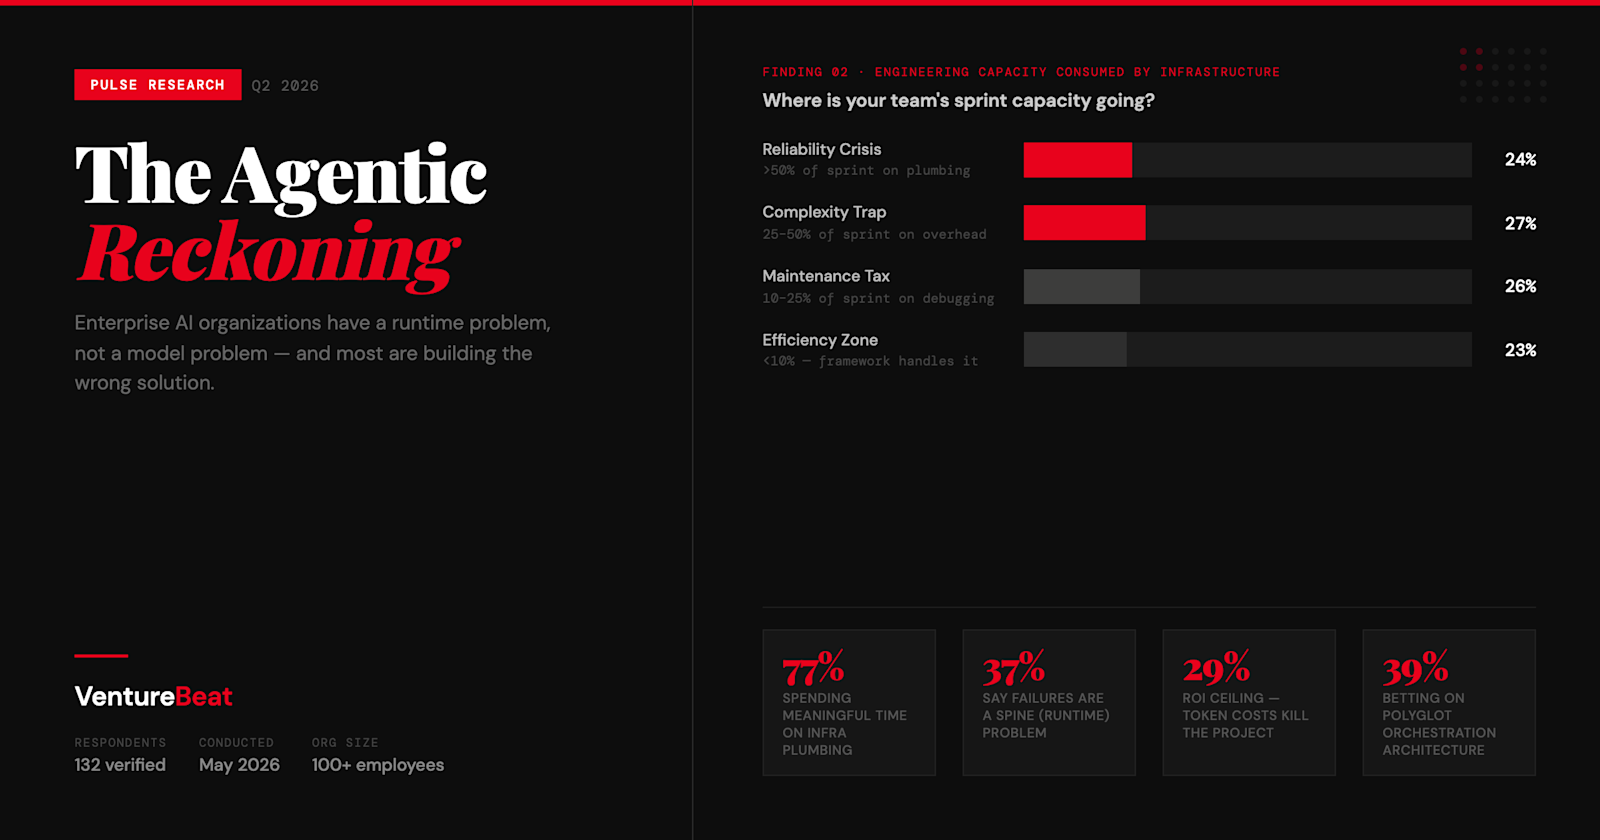
27% находятся в ловушке сложности (Complexity Trap): 25–50% каждого спринта уходит на инфраструктурные накладные расходы и «призрачные сбои» |
26% платят налог на обслуживание (Maintenance Tax) (10–25% емкости спринта): примерно один день в неделю уходит на отладку зависающих скриптов и управление базовым состоянием |
24% находятся в кризисе надежности (Reliability Crisis) (>50% емкости спринта уходит на сантехнику): более половины инженерного времени тратится на нервную систему, а не на мозг |
23% находятся в зоне эффективности (Efficiency Zone) (<10% емкости спринта на сантехнику): надежность обеспечивается фреймворком или платформой; команда сосредоточена на ключевой агентной логике |
Арифметика сурова. Семидесяти семи процентам респондентов приходится тратить значительное время инженеров на инфраструктурные издержки. И лишь 23% — те, чьи фреймворки берут надежность на себя — избежали этого налога. Распределение примечательно своей плоскостью: полюсы Кризиса и Эффективности равны по размеру промежуточным категориям (Ловушка и Налог на обслуживание). Это признак рынка, который частично устранил самые худшие сбои, но еще не избавился от структурных накладных расходов.
Респонденты из Зоны Эффективности не обязательно находятся в более изощренном положении. Во многих случаях они могут использовать управляемые платформы, которые абстрагируют проблему долговечности (durability), или же они просто еще не достигли того масштаба, при котором бессостояниевая архитектура начинает давать сбои. Ловушка сложности — это часто то место, где заканчивается Зона Эффективности.
Для организаций, оказавшихся в зоне Кризиса, существуют прямые бизнес-последствия. Каждый час инженера, потраченный на написание логики повторных попыток или отладку «призрачного сбоя» (скрытого тайм-аута API, из-за которого агент зависает без трассировки стека), — это час, не потраченный на дифференцированную логику, которая должна была оправдать инвестиции в ИИ.
Вывод 3: Амнезия состояний — главный убийца продакшна
Главное техническое препятствие изменилось: стоимость и галлюцинации теперь опережают сбои состояния
Когда ИИ-агенты не доходят до продакшна или не масштабируются, что является главным техническим препятствием? Мы назвали пять кандидатов, начиная от галлюцинаций моделей и перерасхода средств до проблем с задержками (latency).
Вывод 3 — Амнезия состояний — главный убийца продакшна
|
29% ссылаются на потолок рентабельности инвестиций (ROI Ceiling): затраты на токены и инфраструктурные издержки превышают общую ценность проекта для бизнеса |
24% ссылаются на распространение галлюцинаций (Hallucination Propagation): дрейф логики на ранних этапах рассуждений, перерастающий в тотальный сбой системы |
20% ссылаются на призрачные сбои (Ghost Failures): скрытые тайм-ауты API и потерю состояния, когда агент зависает без трассировки стека |
17% ссылаются на амнезию состояний (State Amnesia): агенты теряют контекст из-за перезапусков контейнеров, деплоев или кратковременных сбоев |
10% ссылаются на задержки и нарушения SLA (Latency and SLA Breaches): агент не укладывается в строгие требования по времени устранения проблем, создавая операционные риски даже при правильных рассуждениях |
Распространение галлюцинаций (24%) накапливается незаметно — ошибки в рассуждениях на ранних шагах становятся катастрофическими к Шагу 10. Призрачные сбои (20%) по определению невидимы, а значит, их реальная распространенность, вероятно, выше, чем показывают эти цифры.
Вывод 4: Налог на наблюдаемость тяжелее всего ложится на Microsoft
Затраты на видимость платформ распределены неравномерно
Наше исследование за первый квартал 2026 года определило непрозрачность вендоров как главное препятствие на пути к управлению ИИ — опережая нехватку кадров, инструменты и бюджет. Этот вывод подвел к вопросу: какая экосистема вендоров на практике требует наибольших затрат на достижение базовой видимости в продакшне?
Мы спросили респондентов, какая платформа требует больше всего кастомной телеметрии, ручного инструментирования и «логгирующего клея» для получения видимости сбоев агентов.
Вывод 4 — Налог на наблюдаемость тяжелее всего ложится на Microsoft
|
42% называют Microsoft (GitHub Copilot Workspaces / Agent Framework) обладателем самого высокого налога на наблюдаемость |
30% называют OpenAI (Codex / Agents SDK) |
16% называют Google (Antigravity IDE / Vertex AI Agent Builder) |
12% называют Anthropic (Claude Code / Claude Agent SDK) |
Лидирующая позиция Microsoft в этом рейтинге — не случайность. Это структурная характеристика агентной экосистемы Microsoft: тот же стек Azure/Copilot, который доминирует в корпоративном внедрении ИИ, требует наибольших накладных расходов на инструментирование для заглядывания «под капот».
Это также подтверждает предостережение, сделанное Брайаном Грейсли (Brian Gracely), старшим директором Red Hat, на мероприятии VentureBeat в Бостоне в марте: создание системы контроля исключительно внутри инструментария одного облачного провайдера означает «аренду клетки». Организации, платящие самый высокий налог на наблюдаемость, — это как раз те, кто сильнее всего привязан к провайдерским инструментам.
Следствие для команд, оценивающих архитектуру оркестрации, очевидно: стоимость наблюдаемости — это реальная статья бюджета, которая должна учитываться в любом анализе «создать или купить» (build-vs-buy). Платформа, которая кажется дешевле на уровне API, может накладывать существенно большие инженерные затраты на уровне телеметрии.
Вывод 5: Разрыв между хайпом и реальностью принадлежит OpenAI и Microsoft
Маркетинг агентного кодинга значительно опережает надежность в продакшне.
Мы задали респондентам прямой вопрос: маркетинг агентного кодинга какой из крупных платформ наиболее оторван от реальной технической надежности и отказоустойчивости их продукта? Тридцать два процента ответили, что не знают — эта цифра примерно постоянна во всех трех волнах, что говорит о том, что перманентная неопределенность носит структурный характер, а не является артефактом выборки. Cursor также набрал 6% в этой волне среди тех, у кого достаточно опыта работы в продакшне, чтобы иметь собственное мнение.
Вывод 5 — Разрыв между хайпом и реальностью принадлежит OpenAI и Microsoft
|
45% называют Microsoft (GitHub Copilot Workspaces / AutoGen) |
22% называют OpenAI (Codex / Agents SDK) |
12% называют Google (Antigravity IDE / Agent Manager) |
11% называют Anthropic (Claude Code / Claude Agent SDK) |
Microsoft лидирует с 45%; OpenAI на втором месте с 22%. Этот разрыв слишком велик, чтобы объяснять его исключительно масштабом развертывания. Это говорит о том, что GitHub Copilot Workspaces и AutoGen порождают специфическую категорию разочарования — вероятно, связанную с надежностью многоагентной оркестрации в продакшне, — которая накапливается по мере использования. Платформа, которую в продакшне запускает меньше предприятий, будет накапливать меньше заслуживающих доверия разочарованных практиков.
Более значимое наблюдение заключается в том, что этот разрыв означает для лиц, принимающих решения при оценке новых агентных инструментов. Маркетинг всех основных платформ описывает агентную автономность и надежность на уровне, который развертывания в продакшне пока не обеспечивают. Организации из нашего опроса, вышедшие за рамки пилотных проектов, сталкиваются с этой разницей на собственном опыте.
Вывод 6: Сеть безопасности выстраивается с нуля (first principles)
Предприятия не ждут, пока вендоры решат вопросы безопасности агентов
Как предприятия защищают проприетарные исследовательские данные от утечек ИИ и эксфильтрации через промпты? Вопрос архитектуры безопасности является одним из самых судьбоносных в агентном ИИ, поскольку агенты — в отличие от статических моделей — могут активно вызывать API, перемещаться по файловым системам и выполнять код. Радиус поражения при сбое безопасности здесь качественно иной.
Политики как код (Policy-as-Code) — ведущий механизм безопасности, но с небольшим отрывом.
Вывод 6 — Сеть безопасности выстраивается с нуля (first principles)
|
30% внедряют политики как код (Policy-as-Code) (шлюзы управления): жестко зашитые правила «можно/нельзя» на уровне оркестрации, которые переопределяют намерение, сгенерированное моделью |
25% используют детерминированное маскирование данных: мидлварь, которая редактирует персональные данные (PII) до того, как они попадут в контекст инференса |
23% внедряют идентичность с наименьшими привилегиями (NHI): уникальные, недолговечные нечеловеческие учетные записи и ограниченные ключи API для каждого потока агента |
22% используют изолированные песочницы с заблокированным исходящим трафиком (Egress-Locked Sandboxing): изолированные контейнеры с контролируемым исходящим трафиком для ненадежного кода, сгенерированного моделью |
Подходы NHI и Policy-as-Code существенно различаются по своей философии безопасности. NHI ориентирована на идентичность: она отвечает на вопрос «кто этот агент и к чему ему разрешено прикасаться?». Policy-as-Code ориентирована на правила: она отвечает на вопрос «независимо от того, что решит сделать модель, какие жесткие стоп-краны существуют на уровне инфраструктуры?»
Примерный паритет всех четырех механизмов — главный итог. Так выглядит конвергенция рынка на раннем этапе: доминирующий паттерн еще не сформировался. Примечательно, однако, что изолированные песочницы с заблокированным исходящим трафиком — относительно новый тренд в развертывании агентного ИИ, но он уже набрал 22%. По мере того как все больше агентов получают доступ к корпоративным системам на уровне терминала, соотношение затрат и выгод от песочниц улучшается. Это примечательно, учитывая зрелость дисциплин управления идентификацией и политик как кода в традиционной ИТ-безопасности. Уровень безопасности ИИ пока строится во многом с нуля.
Показатель песочниц (Egress-Locked Sandboxing) заслуживает внимания, несмотря на их меньшую долю. Песочница для выполнения ненадежного кода — самый технически сложный из четырех подходов, но он же является и самой прямой защитой от атак путем внедрения промптов (prompt injection), пытающихся выполнить вредоносный код через инструменты агента. По мере того как агентные системы получают все больше доступа на уровне терминала (тенденция, подтверждающаяся нашим опросом), этот подход может оказаться важнее, чем показывает его текущий уровень внедрения.
«Как нам проводить аудит агентных инструментов, имеющих доступ к нашим проприетарным репозиториям на уровне терминала?»
— Совокупная озабоченность, выраженная несколькими респондентами
Вывод 7: Пропасть сложности реальна, и большинство преодолевает ее
Миграция от бессостояниевых архитектур идет полным ходом, но она фрагментирована
Центральный тезис «Эры расплаты агентов» заключается в том, что бессостояниевые архитектуры на Python/LangChain не могут пережить «пропасть сложности» — точку, в которой многошаговые, долгоиграющие рабочие процессы агентов начинают давать сбои с такой частотой, что развертывание в продакшне становится невозможным. Мы прямо спросили респондентов: мигрируете ли вы в сторону фреймворков долговечного выполнения для решения проблемы потери состояния?
Ответы показывают рынок в переходном состоянии, с существенными разногласиями относительно правильного пункта назначения.
Вывод 7 — Пропасть сложности реальна, и большинство преодолевает ее
|
32% находятся в стадии активной миграции: перенесли или активно переносят логику агентов в слои долговечной оркестрации для сохранения состояния и аудируемости |
27% находятся на этапе оценки архитектуры с приоритетом управления (Governance-First): внедряют долговечные среды выполнения специально для обеспечения границ данных и детерминированных резервных сценариев (fallbacks) |
21% внедряют шлюзы управления на базе политик как код (Policy-as-Code) в качестве своего основного ответа на пропасть сложности |
20% сохраняют приверженность бессостояниевым архитектурам (Stateless Commitment): придерживаются бессостояниевых цепочек и пытаются решить проблемы надежности с помощью промптинга и повторных попыток |
20%, приверженных бессостояниевым архитектурам (и пытающихся решить структурную проблему долговечности с помощью улучшенного промптинга), — это когорта, наиболее подверженная амнезии состояний и призрачным сбоям по мере масштабирования их рабочих нагрузок. По сути, это та же ловушка, в которую попали команды RPA десятилетие назад, когда хрупкая автоматизация процессов латалась все более сложными наборами правил, а не перестраивалась на более устойчивых фундаментах.
Когорта сторонников бессостояниевых архитектур заслуживает переосмысления. Эти команды не обязательно наивны: некоторые строят системы на управляемых платформах, которые действительно абстрагируют управление состоянием. Но часть из них латает структурную хрупкость улучшениями промптинга, и данные о призрачных сбоях в Выводе 3 показывают, что этот подход может приближаться к своему пределу.
Совокупные 59%, находящиеся либо в стадии активной миграции, либо на этапе оценки с приоритетом управления, представляют собой передний край рынка — организации, которые признали архитектурную проблему и инвестируют в ее структурное решение.
Вывод 8: Лидерство «полиглотной оркестрации» невелико — поле разрозненно
Архитектурные убеждения распределены между несколькими ставками
Какая долгосрочная архитектурная философия завоевывает стратегические инвестиции предприятий? Мы предложили четыре варианта, представляющих основные ставки на текущем рынке.
Вывод 8 — Лидерство «полиглотной оркестрации» невелико
|
39% делают ставку на полиглотность (Polyglot Bet): гибридная многоуровневая оркестрация, использующая рассуждения на уровне модели для недетерминированного планирования в сочетании с детерминированными движками правил для критически важного выполнения |
28% делают ставку на облачный управляемый стек (Cloud-Native Managed Stack): основной облачный провайдер (AWS Step Functions, Microsoft ADK) для полной интеграции |
16% делают ставку на монолит на базе модели (Model-Native Monolith): передовые лаборатории (OpenAI/Anthropic) для работы со всем стеком — рассуждениями, состоянием и выполнением |
16% делают ставку на независимую долговечную среду выполнения (Independent Durable Runtime): агностичные слои выполнения (LangGraph, Temporal, Restate) для полного суверенитета данных |
Лидерство ставки на полиглотность говорит о том, что предприятия видят преимущества гибкого подхода: использование архитектур на базе моделей там, где хорошо работают недетерминированные рассуждения, но применение детерминированных структур и конвейеров там, где на карту поставлены точность и критически важное выполнение.
Это имеет прямые конкурентные последствия для передовых лабораторий и облачных провайдеров. Когорта, заявляющая об использовании облачного управляемого стека, весьма значительна. Это, вероятно, отражает корпоративную реальность, в которой развертывания Azure OpenAI Service и AWS Bedrock поставляются со встроенной организационной гравитацией — отношениями с закупками, одобрениями безопасности и существующими конвейерами данных. Ставка на независимую долговечную среду выполнения (16%) сигнализирует о том, что часть команд отвергла как облачную изоляцию (lock-in), так и зависимость от передовых лабораторий в пользу полного архитектурного суверенитета.
Полиглотный результат также помогает объяснить, почему проблемы наблюдаемости и управления, описанные в этом исследовании, столь упорны. Когда ваша архитектура намеренно охватывает несколько слоев оркестрации и нескольких провайдеров, телеметрия ни одного отдельного вендора не дает полной картины. «Dynatrace для ИИ» — единая платформа наблюдаемости, к которой призывал технический директор Mass General Brigham Наллан Срираман (Nallan Sriraman) на мероприятии VentureBeat в Бостоне — становится не просто желательной, а структурно необходимой.
«Предприятия не доверяют ни одному провайдеру настолько, чтобы дать ему полный контроль, но им не хватает инженерного потенциала, чтобы построить все с нуля.»
— Респондент опроса
Вывод 9: Коэффициент принятия пользователями — новый производственный стандарт
Рынок останавливается на метрике человеческого доверия в качестве основного A-SLA
Какие метрики предприятия реально используют для определения готовности ИИ-агента к продакшну? Мы попросили респондентов указать их главный показатель Agentic SLA (A-SLA) — число, которое превыше всего остального говорит им о том, можно ли выпускать агента в свет.
Вывод 9 — Коэффициент принятия пользователями — новый производственный стандарт
47%
Коэффициент принятия пользователями (User Acceptance Rate): процент автономных действий, принятых как есть без вмешательства человека
30%
Верность контекста (Context Fidelity): способность агента поддерживать состояние и память в течение 48+ часов окна выполнения
12%
Точность выбора инструментов (Tool Selection Accuracy): частота, с которой агент выбирает правильный инструмент или вызов API для каждого шага задачи (цель: >99%)
5%
Джиттер задержки (Latency Jitter): постоянство времени отклика в недетерминированных циклах рассуждений
Коэффициент принятия пользователями как доминирующая метрика продакшна важен потому, что это мера человеческого доверия, а не показатель технической производительности. Он не спрашивает, быстро ли работал агент или сохранял ли он состояние. Он спрашивает, захотел ли человек, проверивший его вывод, принять его. По сути, это полевой тест Тьюринга, применяемый на уровне действий.
Сохранение UAR в качестве ведущего показателя отражает реальность того, где до сих пор находится большинство развертываний корпоративных агентов: в режиме «человек в контуре» (human-in-the-loop), где действия агентов требуют проверки человеком перед выполнением. Это рациональный ответ на описанные ранее в исследовании распространение галлюцинаций и призрачные сбои. Организации, еще не решившие проблему надежности среды выполнения, разумно оставляют человека в контуре — и, судя по 132 респондентам, нет никаких признаков того, что это меняется.
Позиция верности контекста на уровне 30% — самый значимый результат. Он напрямую коррелирует с данными об активной миграции в Выводе 7: по мере того как все больше команд переходят на фреймворки долговечного выполнения, проблема памяти на 48+ часов становится их главной заботой в продакшне. Команды, решившие проблему амнезии состояний, теперь сосредоточены на том, помнит ли их агент, чем он занимался вчера. Падение джиттера задержки с 25% до 11% рассказывает дополняющую историю: чистая скорость больше не является главной тревогой. Ее место заняли правильность и долговечность.
Итог: расплата за среду выполнения, а не за рассуждения
Данные рассказывают последовательную историю: для агентов существует дефицит среды выполнения. Предприятия тратят больше времени на инфраструктурную сантехнику, чем на интеллект агентов, а амнезия состояний продолжает уносить жизни продакшн-деплоев. Но линии разломов видны невооруженным глазом. Потолок рентабельности инвестиций обогнал амнезию состояний в качестве главного убийцы продакшна, что означает: проблема инфраструктуры больше не является чисто технической. Экономика токенов и накладные расходы на оркестрацию теперь съедают столько ценности для бизнеса, что спонсоры проектов принимают решение об их закрытии до того, как инженерные команды успевают решить проблему долговечности. Распространение галлюцинаций остается большой проблемой. Голоса за «Мозг» в Выводе 1 по-прежнему значимы. А лидерство полиглотности хрупко, при этом разнообразные архитектуры представлены весьма широко.
Модели, по оценке большинства самих респондентов, достаточно умны — однако 17% с этим не согласны. Что еще недостаточно умного, так это инфраструктура вокруг них: управление состоянием, отказоустойчивость, наблюдаемость, управление идентичностью и детерминированный слой выполнения, который превращает суждения модели в нечто, на что предприятие может поставить свою операционную деятельность.
Тридцать девять процентов тех, кто делает ставку на полиглотность, представляют текущий передний край корпоративного архитектурного мышления. Они строят системы, где интеллект модели сохраняется и используется, но где слой выполнения — «Позвоночник» — детерминирован, аудируем и долговечен по своей конструкции. Они не ждут, пока передовая лаборатория решит это за них. Они не ставят на то, что лучший промптинг исправит хрупкость инфраструктуры. Они строят плоскость управления.
Организации, все еще приверженные бессостояниевым архитектурам (все еще верящие, что ручные повторные попытки и умный промптинг могут заменить долговечное выполнение), с наибольшей вероятностью пополнят статистику следующей волны. Призрачные сбои — главное препятствие. Паттерн знаком: ранние последователи диагностируют проблему на архитектурном уровне, мигрируют на долговечные среды выполнения и избегают точки отказа. Поздние последователи унаследуют ее. Пропасть сложности не теоретическая. Это стена, к которой большинство текущих агентных архитектур уже карабкается.
Расплата касается среды выполнения и экономики, а не рассуждений.
Основано на ответах 132 квалифицированных корпоративных респондентов (компании от 100+ сотрудников). Размер выборки небольшой; данные следует рассматривать как индикативные. Респонденты включают директоров, вице-президентов, CIO, CTO и корпоративных архитекторов из сфер технологий, финансовых услуг, ритейла, здравоохранения и других секторов.