


Маршрутизация инструментов ИИ-агентов сокращает использование токенов на 99%
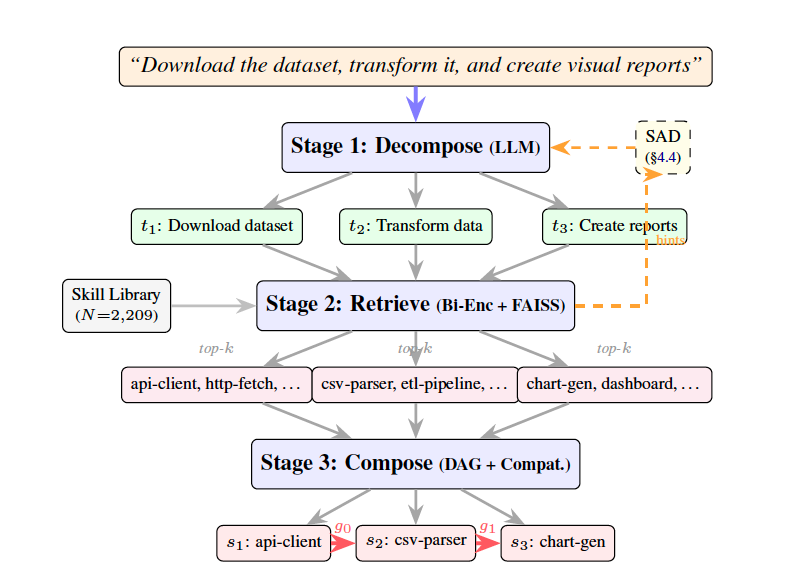


По мере того как корпоративные ИИ-системы масштабируются для обработки сложных рабочих процессов, специалисты сталкиваются с проблемой маршрутизации подзадач к нужным инструментам и навыкам. У агентов могут быть сотни инструментов и навыков, и они начинают путаться в том, какой из них использовать на каждом этапе рабочего процесса.
Чтобы решить эту проблему, исследователи из Alibaba разработали SkillWeaver — фреймворк, который создает граф выполнения для заданной задачи и выбирает подходящие навыки для каждого из узлов. Они также представили декомпозицию на основе осведомленности о навыках (Skill-Aware Decomposition, SAD) — новый метод, использующий цикл обратной связи, который позволяет агенту итеративно извлекать и проверять подходящие кандидаты инструментов. Такой композиционный подход и механизм обратной связи отличают SkillWeaver от других фреймворков маршрутизации инструментов, которые выбирают инструменты за один шаг.
SkillWeaver применим к реальным ИИ-приложениям, где агенты автономно управляют экосистемами из множества инструментов, такими как Model Context Protocol (MCP), для выполнения многошаговых бизнес-операций, включая сканирование наборов данных, преобразование информации и создание визуальных отчетов.
На практике эксперименты исследователей со SkillWeaver показывают, что внедрение такого подхода с поиском и маршрутизацией значительно повышает точность и при этом сокращает потребление токенов более чем на 99% по сравнению с наитивным предоставлением агентам доступа ко всей библиотеке инструментов.
Главный вывод для разработчиков ИИ-агентов заключается в том, что детализация декомпозиции задач является самым узким местом для точного поиска инструментов.
Проблема маршрутизации навыков
Навыки — ключевой паттерн в архитектурах современных LLM-агентов. Навык представляет собой модульную спецификацию многократно используемого инструмента, в которой используется структурированная документация на естественном языке.
Поскольку корпоративные агенты интегрируются с масштабными экосистемами инструментов, точная маршрутизация пользовательских запросов к нужным навыкам становится сложной задачей. Предоставление всей библиотеки в распоряжение LLM для поиска подходящего инструмента крайне неэффективно, быстро исчерпывает лимиты контекста и потребляет сотни тысяч токенов.
Большинство современных фреймворков использования инструментов пытаются решить эту проблему с помощью поиска по API, сопоставления документации или иерархических структур, которые рассматривают маршрутизацию строго как выбор единичного навыка или как проблему для каждого отдельного шага.
Однако эта парадигма одного навыка недостаточна для корпоративных сред, поскольку реальные запросы по своей сути композиционны. Стандартный бизнес-запрос вроде «Скачай набор данных, преобразуй его и создай визуальные отчеты» не может быть выполнен с помощью одного инструмента. Он требует разбиения промпта и последовательного объединения клиента API, процессора данных и инструмента визуализации в единый план многошагового выполнения.
Как работают SkillWeaver и SAD
Чтобы справиться с этим, исследователи определяют проблему обработки сложных задач, требующих нескольких навыков, как «композиционную маршрутизацию навыков». Получив сложный пользовательский промпт и огромную библиотеку инструментов, агент должен одновременно выяснить, как разбить запрос на последовательность атомарных подзадач, как сопоставить каждую подзадачу с единственным наилучшим доступным навыком и как объединить эти навыки в исполняемый план.
SkillWeaver организует этот процесс через три четких этапа: декомпозиция (Decompose), поиск (Retrieve) и компоновка (Compose). На первом этапе LLM выступает в роли декомпозитора задач, разбивая сложный запрос пользователя на последовательность подзадач, каждая из которых требует одного навыка. После того как подзадачи четко определены, система использует модель эмбеддингов для сравнения каждой подзадачи с библиотекой навыков, чтобы сформировать шорт-лист лучших кандидатов среди инструментов для каждого шага.
На финальном этапе планировщик оценивает извлеченных кандидатов на основе того, насколько хорошо они работают вместе. Он проверяет совместимость между навыками, чтобы убедиться, что выходные данные одного инструмента естественным образом переходят во входные данные следующего. Затем он создает окончательный план выполнения в виде направленного ациклического графа (DAG), который отражает зависимости, позволяя независимым задачам потенциально выполняться параллельно.
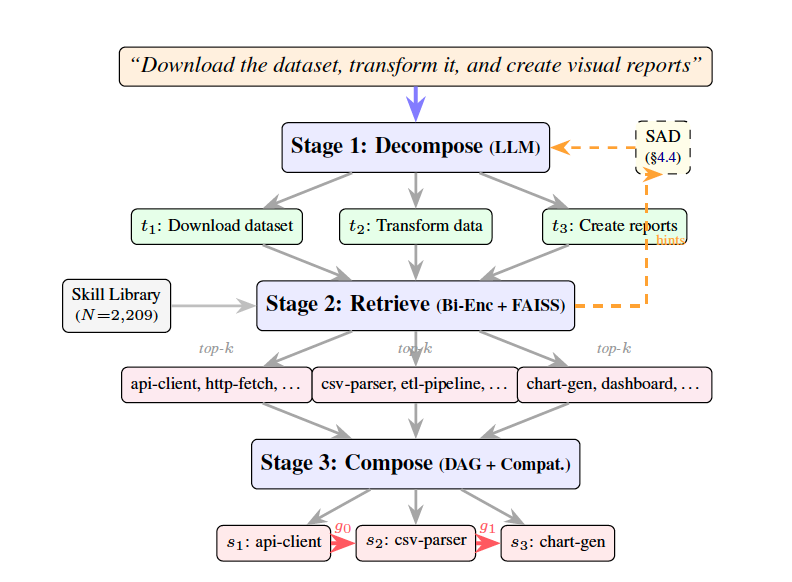
Фреймворк SkillWeaver
Например, рассмотрим пользователя, который просит ИИ-агента «Скачать набор данных, преобразовать его и создать визуальные отчеты». На этапе декомпозиции LLM-декомпозитор разбивает эту задачу на три отдельные подзадачи: скачивание набора данных, преобразование данных и создание отчетов.
На этапе поиска система сканирует библиотеку и находит кандидатов, таких как «api-client» или «http-fetch» для первой задачи, «csv-parser» или «etl-pipeline» для второй и так далее. Наконец, на этапе компоновки эти варианты оцениваются, выбирается конкретная комбинация «api-client», «csv-parser» и «chart-gen», обладающая наибольшей совместимостью, и они объединяются в готовый к выполнению рабочий процесс.
Ключевая сложность этого конвейера заключается в том, что LLM часто выдают общие описания шагов, которые не совпадают со специфическим техническим словарем реальных навыков, имеющихся в библиотеке. Чтобы исправить это, в SkillWeaver внедрена итеративная декомпозиция с учетом навыков (SAD) — новый цикл обратной связи. SAD работает следующим образом: LLM создает черновой план, выполняет предварительный поиск для обнаружения частично совпадающих навыков, а затем передает эти найденные навыки обратно в LLM в качестве подсказок. Это позволяет LLM переписать свою декомпозицию так, чтобы степень детализации и лексика идеально соответствовали реально существующим инструментам.
SkillWeaver в действии
Чтобы оценить эффективность SkillWeaver в реалистичных корпоративных сценариях, исследователи создали собственный бенчмарк под названием CompSkillBench. Он состоит из 300 многошаговых запросов разного уровня сложности. Чтобы отразить условия реального мира, они использовали библиотеку из 2209 реальных навыков из публичной экосистемы MCP, охватывающих 24 функциональные категории, такие как облачная инфраструктура, финансы и базы данных.
В качестве основного движка исследователи использовали легкую модель с 7 миллиардами параметров (Qwen2.5-7B-Instruct) для декомпозиции задач в сочетании со стандартным средством поиска на основе семантики (MiniLM с индексом FAISS) для поиска инструментов. SkillWeaver сравнивался с тремя основными конфигурациями: методом «LLM-Direct» методом грубой силы, при котором все имена инструментов закладывались в промпт большой модели; базовой декомпозицией на основе LLM без SAD; и циклом агента в стиле ReAct.
Эксперименты показывают, что декомпозиция задач является главным узким местом. Стандартное поведение LLM оказывается неэффективным при работе с крупными библиотеками инструментов, но цикл обратной связи SAD кардинально меняет ситуацию. В базовой конфигурации модель 7B достигала точности декомпозиции (то есть прогнозирования правильного количества шагов) лишь в 51,0% случаев. При активации цикла обратной связи SAD точность подскочила до 67,7% (у более крупной модели Qwen-Max точность достигла 92%). На «сложных» задачах, требующих от четырех до пяти различных навыков, SAD повысила точность на 50%.
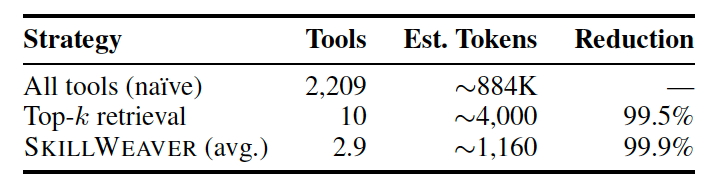
По сравнению с наитивным подходом SkillWeaver сокращает потребление токенов более чем на 99% (источник: arXiv)
Один из удивительных выводов заключается в том, что более крупные модели без руководства могут работать хуже. При тестировании в базовой конфигурации у более крупной модели с 14 миллиардами параметров точность упала ниже показателей модели 7B, поскольку она склонна излишне декомпозировать задачи на микроскопические, ненужные шаги. После внедрения SAD подсказки по найденным инструментам вернули модель к реальности и повысили ее точность. Это говорит о том, что согласование агента со словарем конкретных инструментов зачастую приносит больше пользы, чем использование более крупной и дорогой LLM.
Еще один важный вывод касается экономии токенов. Базовая линия LLM-Direct, в которой использовалась очень крупная модель Qwen-Max, показала, что передача всех инструментов в промпт большой модели не работает. Несмотря на практически безупречные возможности разбиения задач, эта масштабная модель находила правильную категорию инструмента лишь в 21,1% случаев при перегрузке вариантами инструментов. Целенаправленный подход поиска и маршрутизации SkillWeaver значительно превзошел этот результат по точности и одновременно сократил потребление контекстного окна с примерно 884 000 токенов примерно до 1 160 токенов на запрос, что составляет снижение на 99,9%. Для разработчиков это означает радикальное снижение затрат на API и более высокую скорость ответа.
Наконец, традиционный базовый метод ReAct полностью провалился, достигнув 0% точности декомпозиции. Его цикл естественным образом сводит многошаговые планы к изолированным действиям, вместо того чтобы явно выстраивать связную последовательность из нескольких инструментов.
Рекомендации для разработчиков
Хотя исследователи еще не опубликовали исходный код SkillWeaver, их работа построена на готовых инструментах, которые легко воспроизвести.
Декомпозиция на основе осведомленности о навыках (SAD), являющаяся ключевой инновацией в центре фреймворка, представляет собой продуманный цикл промпт-инжиниринга и поиска. Авторы поделились шаблонами промптов в своей статье, и разработчики могут реализовать их самостоятельно, используя стандартные оркестрационные библиотеки вроде LangChain, LlamaIndex или даже простые скрипты на Python.
Что касается компонента поиска, авторы создали базовый фреймворк с использованием all-MiniLM-L6-v2 — модели эмбеддингов с открытым исходным кодом. Они обнаружили, что замена на чуть более мощный готовый энкодер (BGE-base-en-v1.5) мгновенно повышает точность без какой-либо тонкой настройки (fine-tuning). Хотя готовый би-энкодер отлично справляется с попаданием релевантного инструмента в топ-10 кандидатов почти в 70% случаев, ему сложно стабильно ставить идеальный инструмент ровно на первое место — это удается лишь примерно в 37% случаев. Чтобы преодолеть этот разрыв, командам, скорее всего, потребуется внедрить вторичный кросс-энкодер или реранкер на основе LLM для переупорядочивания этой десятки лидеров.
Одно из требований предварительной подготовки заключается в векторизации библиотеки инструментов и заблаговременном создании индекса FAISS. На практике это незначительное препятствие. Создание эмбеддингов и индексация всех 2209 навыков из бенчмарка заняли всего 15 секунд. После создания извлечение инструментов из индекса добавляет менее 15 миллисекунд задержки на запрос. Для корпоративных сред синхронизация индекса инструментов — это тривиальная фоновая задача.
Текущим ограничением SkillWeaver является отсутствие восстановления после ошибок. Хотя SkillWeaver успешно выстраивает совместимый DAG для выполнения, пилотное исследование авторов выявило сложности многошаговых цепочек инструментов. Например, если вызов API падает на втором шаге, рушится вся цепочка. Основной вклад статьи ограничивается фазой маршрутизации и планирования. Для полноценного развертывания в продакшене разработчикам необходимо построить собственные механизмы восстановления после ошибок, отката и повторных попыток поверх этапа компоновки, чтобы справляться с реальными тайм-аутами API или некорректными ответами.




