


Память ИИ-агентов: MRAgent сокращает использование токенов до 27 раз
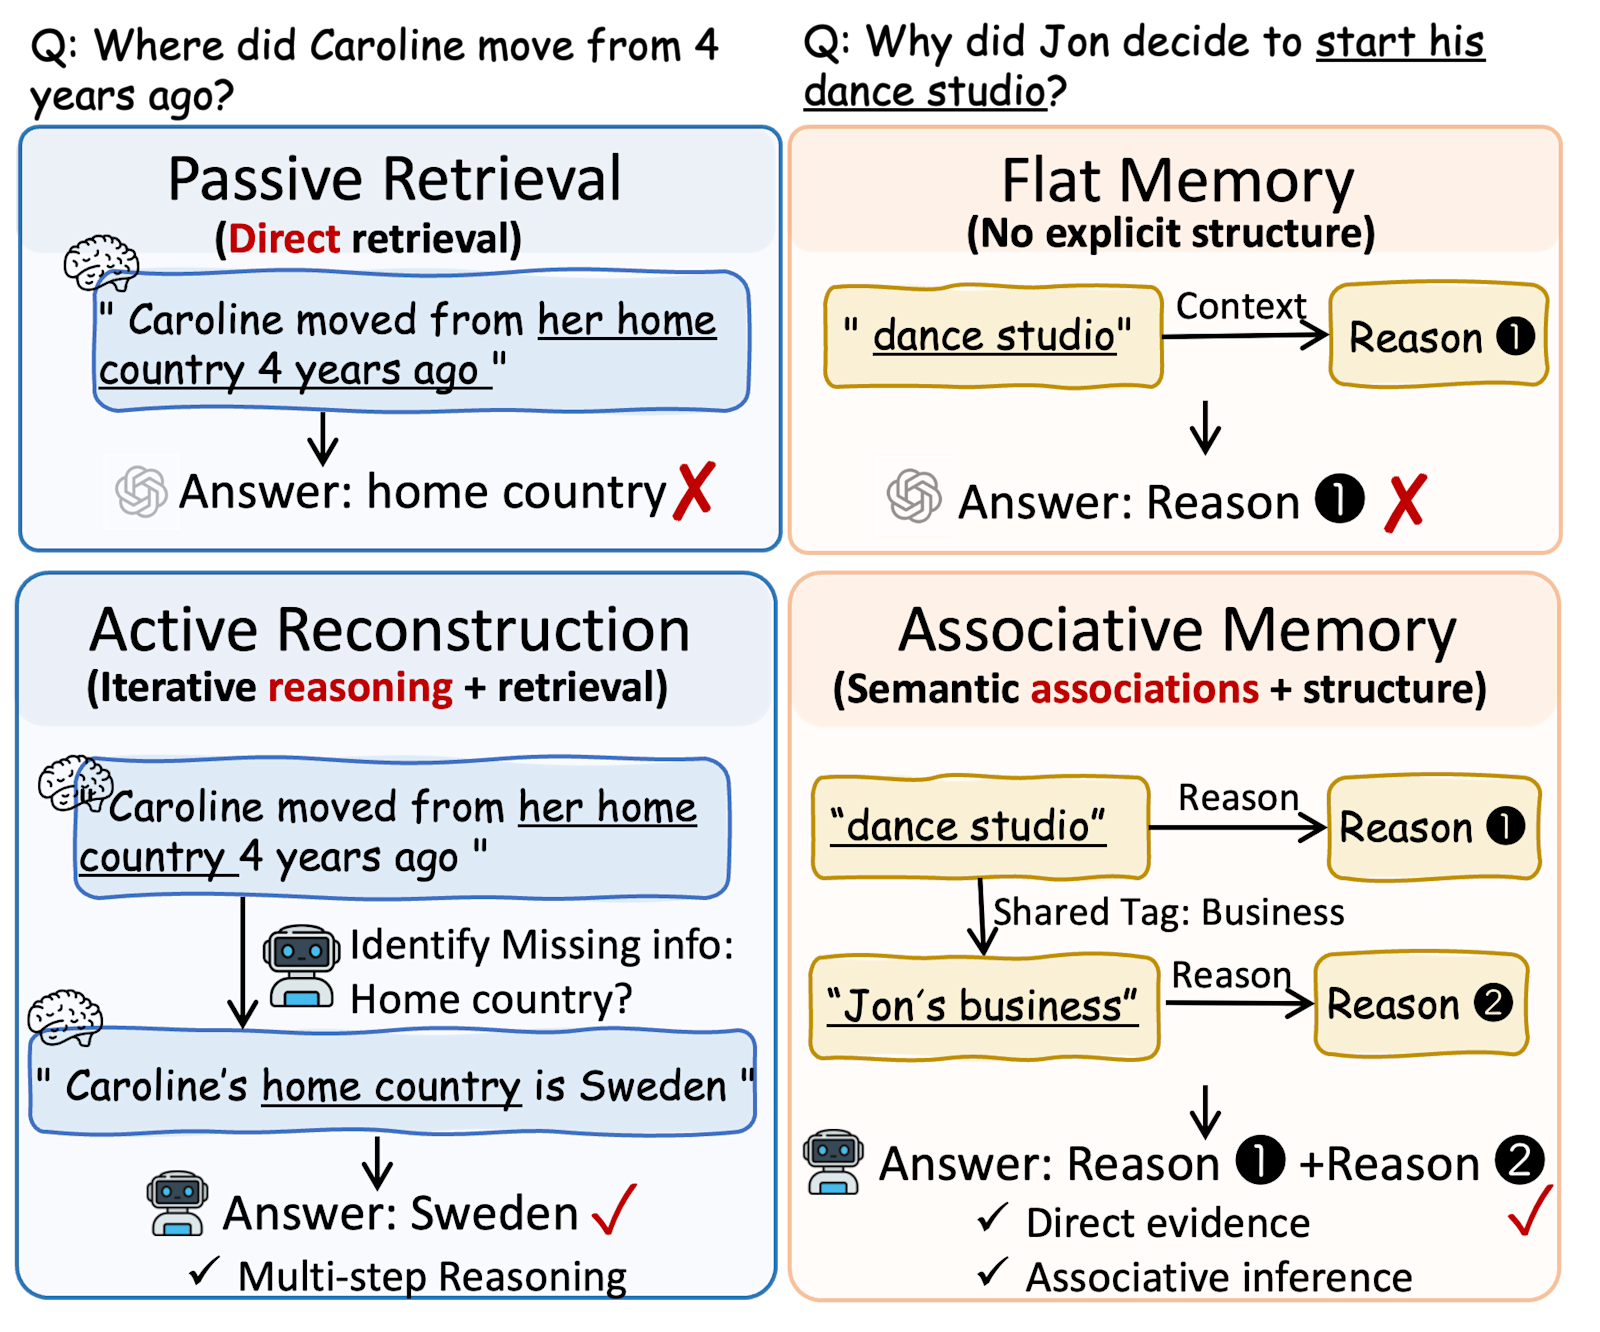


Рассуждения на длинных дистанциях обнажают главную слабость ИИ-агентов: контекстные окна заполняются слишком быстро, а конвейеры извлечения данных выдают шум вместо полезного сигнала.
Чтобы решить эту проблему, исследователи из Национального сингапурского университета разработали MRAgent — фреймворк, который отказывается от статического подхода «извлечение с последующим рассуждением». Вместо этого он использует механизм, позволяющий агенту динамически формировать свою память на основе накапливающихся данных.
Эта многоэтапная реконструкция памяти интегрирована в процесс рассуждения большой языковой модели (LLM). Хотя это не единственный фреймворк в данной области, MRAgent значительно сокращает потребление токенов и затраты времени на выполнение по сравнению с другими подходами к управлению агентной памятью.
Ограничения пассивного извлечения в задачах с длинным контекстом
В классических конвейерах извлечения документы находятся с помощью векторного поиска или обхода графов, после чего передаются в LLM для анализа. Такой пассивный подход не работает, поскольку он не способен объединить рассуждения с доступом к памяти, что приводит к трем серьезным узким местам:
-
Эти системы не могут менять стратегию поиска прямо в процессе рассуждений. Если агент запрашивает документ и обнаруживает, что ему не хватает важной детали — например, определенной даты или имени, — у него нет возможности отправить новый запрос на основе этой находки.
-
Фиксированные коэффициенты сходства и предопределенные расширения графов возвращают поверхностные совпадения, которые переполняют контекстное окно LLM нерелевантным шумом, ухудшая качество рассуждений.
-
Существующие системы сильно зависят от заранее созданных структур (таких как результаты top-k и статические функции релевантности), что ограничивает гибкость, необходимую для масштабирования в условиях непредсказуемых и долгосрочных пользовательских сессий.
Исследователи утверждают, что для преодоления этих ограничений разработчикам следует перейти к «процессу активной и ассоциативной реконструкции» — концепции, вдохновленной когнитивной нейробиологией.
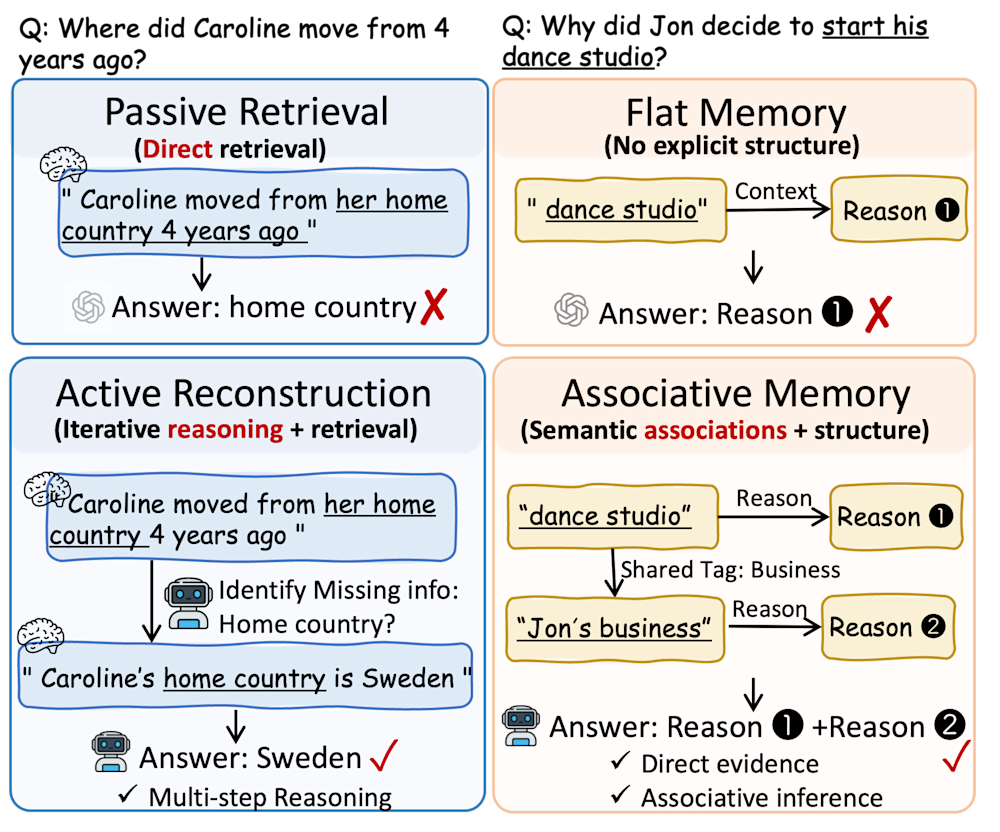
Пассивное извлечение против активной реконструкции памяти (источник: arXiv)
В рамках этой парадигмы извлечение воспоминаний происходит последовательно, а не в виде пассивного чтения из статической базы данных. Система начинает с небольших специфических триггеров из запроса пользователя (например, имени человека, действия или места). Эти начальные подсказки указывают на связанные концепции или категории, а не на массивные блоки текста.
Следуя по этим опорным точкам метаданных, агент шаг за шагом собирает небольшие фрагменты информации. Он использует каждую новую крупицу данных для направления своего следующего шага, пока успешно не соберет полную и точную картину.
Как MRAgent реализует активную реконструкцию памяти
Вместо того чтобы рассматривать память как статическую базу данных, MRAgent (Memory Reasoning Architecture for LLM Agents) воспринимает её как интерактивную среду. При обработке сложного запроса агент задействует аналитические способности базовой LLM для изучения нескольких возможных путей поиска по структурированному графу памяти.
На каждом шаге LLM оценивает собранные промежуточные данные и использует их для итеративной оптимизации поиска. Она выводит новые поисковые ограничения, идет по путям с наилучшей информацией и отсекает нерелевантные ветви. Это позволяет MRAgent собирать глубоко скрытые данные, не загромождая контекст LLM шумом.
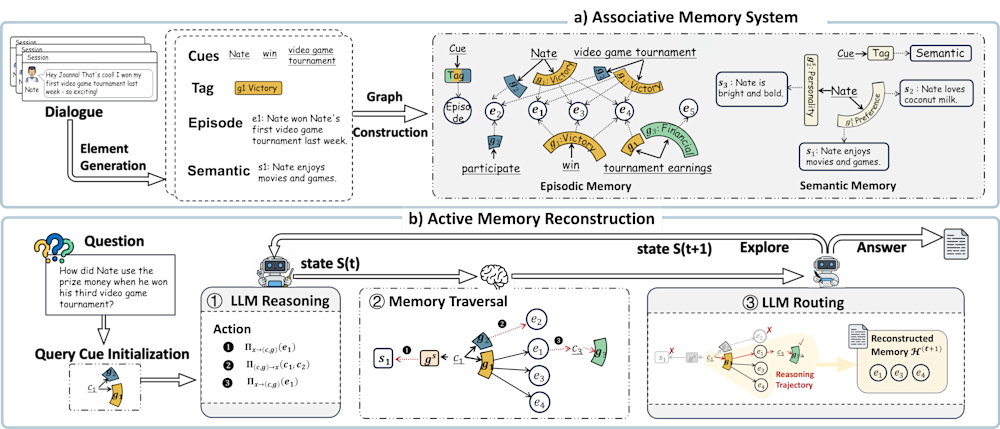
Архитектура MRAgent (источник: arXiv)
Чтобы сделать это активное исследование вычислительно эффективным и масштабируемым, фреймворк организует свою базу данных с помощью механизма «Cue-Tag-Content» (Подсказка-Тег-Контент). Он работает как многоуровневый ассоциативный граф с тремя типами узлов:
-
Подсказки (Cues): детальные ключевые слова, такие как сущности или контекстные атрибуты, извлеченные из общения с пользователем.
-
Контент (Content): фактически сохраненные единицы памяти. Они делятся на многоуровневые слои, такие как эпизодическая память для конкретных событий и семантическая память для стабильных фактов и предпочтений пользователя.
-
Теги (Tags): семантические мосты, которые суммируют связи между конкретными подсказками (Cues) и контентом (Content).
Такая структура обеспечивает высокоэффективный двухэтапный процесс извлечения. Сначала LLM переходит от Подсказок к потенциальным Тегам. Поскольку Теги явно отражают семантические связи и структурную взаимосвязь данных, агент оценивает эти краткие резюме на предмет их релевантности. LLM определяет перспективные пути обхода и отсеивает ненужные ветки до того, как тратить вычислительные ресурсы и токены промпта на доступ к подробному и тяжелому контенту памяти.
Например, пользователь может спросить ИИ-агента: «Как Нейт распорядился призовыми деньгами после победы в своем третьем турнире по видеоиграм?»
-
Сначала MRAgent извлекает из запроса детализированные стартовые подсказки, такие как «Нейт», «турнир по видеоиграм» и «победа».
-
Агент соотносит эти начальные подсказки с графом памяти и просматривает доступные ассоциативные теги, связанные с ними. Он видит такие теги, как «Победа в турнире» и «Участие в турнире». Поскольку агента интересует только то, что человек сделал после победы в чемпионате, MRAgent отбрасывает тег участия и выбирает тег победы.
-
Агент извлекает эпизодический контент, связанный с выбранной парой «Подсказка-Тег», получая три различных эпизода памяти, в которых Нейт выиграл турнир.
-
MRAgent изучает эти три воспоминания, решает, что одно из них особенно важно для запроса, а два других отбрасывает.
-
Обладая этой информацией, он обновляет свои подсказки и начинает новый раунд поиска и фильтрации. Из нового извлеченного эпизода памяти агент добавляет в подсказки «выигрыш на турнире» и использует это для перехода к новым тегам и поиска новой информации. Он повторяет этот процесс до тех пор, пока не соберет достаточно данных для ответа на запрос, который может звучать примерно так: «Нейт сберег деньги».
VB Transform · 14–15 июля · Менло-Парк · Агентная оркестровка
Intuit перестроила свою многоагентную систему за 60 дней. Что именно они изменили — и почему?
На конференции Transform руководители инженерных отделов из Intuit, Target и Instacart расскажут о том, как они переработали свои архитектуры оркестровки ради надежности, масштабируемости и реальных пользователей.
Производительность MRAgent на отраслевых бенчмарках
MRAgent функционирует наряду с несколькими другими фреймворками, решающими задачу создания агентной памяти. В числе альтернатив — A-MEM (граф-ориентированный фреймворк агентной памяти) и MemoryOS (иерархический фреймворк памяти). Среди других решений для постоянной памяти можно выделить LangMem и Mem0.
Исследователи протестировали MRAgent на отраслевых бенчмарках LoCoMo и LongMemEval. Они проверяют способность агентов справляться с задачами и диалогами с длинным контекстом, охватывающими десятки сессий и сотни реплик. В качестве базовых моделей использовались Gemini 2.5 Flash и Claude Sonnet 4.5. Система тестировалась в сравнении со стандартным RAG, A-MEM, MemoryOS, LangMem и Mem0.
MRAgent продемонстрировал стабильное превосходство над всеми базовыми решениями для обеих моделей и для всех типов вопросов с большим отрывом.
Однако для корпоративных разработчиков наиболее критичным показателем часто является вычислительная стоимость. В тестах LongMemEval MRAgent сократил потребление токенов промпта всего до 118 тыс. на один пример. Для сравнения, A-Mem потратил 632 тыс. токенов, а LangMem израсходовал 3,26 млн токенов на запрос. MRAgent также эффективно сократил время выполнения вдвое по сравнению с A-Mem: с 1122 до 586 секунд.
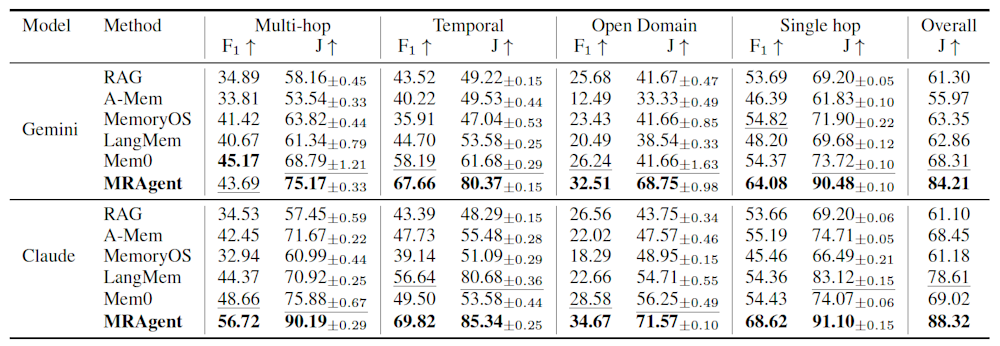
Производительность MRAgent (источник: arXiv)
Секрет практической эффективности MRAgent кроется в его поведении по требованию. Оценка тегов и отсечение нерелевантных путей до этапа извлечения экономят деньги и контекстное пространство. Кроме того, система автономно оценивает накопленный контекст и интуитивно знает, когда следует прекратить поиск, полностью избегая избыточного исследования данных.
Особенности реализации и разработки
Хотя MRAgent крайне эффективен, структуру «Подсказка-Тег-Контент» необходимо подготовить до того, как агент сможет к ней обратиться. Разработчикам предстоит продумать архитектуру базовой базы данных памяти так, чтобы LLM могла эффективно перемещаться по ассоциативным элементам и отсекать ненужные пути без резкого роста вычислительных затрат.
К счастью, разработчикам не нужно вручную размечать или структурировать эти данные. Авторы спроектировали MRAgent с автоматизированным конвейером дистилляции, который использует LLM для обработки истории сырых взаимодействий и автоматического наполнения графа памяти. Задача разработчика заключается в реализации и оркестровке этого автоматизированного конвейера приема данных, а не в ручной разметке.
Вам потребуется настроить фоновую задачу или потоковый конвейер, который пропускает необработанные действия пользователей через шаблоны промптов для извлечения метаданных перед их сохранением в графовой базе данных.
Тем не менее авторы подчеркивают, что это легковесный этап построения, и MRAgent намеренно сохраняет процесс приема данных простым.
Авторы опубликовали код на GitHub.




