


Исследователи Google представили концепцию «верной неопределенности», позволяющую языковым моделям делать наилучшие предположения вместо галлюцинаций


Большие языковые модели (LLM) продолжают бороться с галлюцинациями, что представляет собой серьезное препятствие для их практического применения в корпоративном секторе. Борьба с этими ошибками — задача непростая, заставляющая разработчиков моделей лавировать между жесткими компромиссами, где устранение фактических ошибок часто приводит к подавлению корректных ответов.
В новой научной работе исследователи из Google вводят концепцию «верной неопределенности» (faithful uncertainty) — метакогнитивного метода, который согласует ответ модели с ее внутренней уверенностью. Такое согласование позволяет модели предлагать гипотезы с надлежащей долей сомнения (например, «По моему лучшему предположению…») вместо того, чтобы по умолчанию переключаться на бесполезную бинарную логику «ответить или воздержаться».
В реальных агентских ИИ-приложениях такое метакогнитивное осознание служит важнейшим уровнем контроля. Оно позволяет автономным системам точно определять, когда их внутренних знаний достаточно, а когда им необходимо задействовать внешние инструменты или поисковые API для устранения пробелов.
«Плата за полезность» текущих стратегий смягчения последствий
Понимание причин возникновения галлюцинаций у LLM сводится к разграничению двух возможностей: знает ли модель факты или знает ли она то, что ей известно. Исторически большинство улучшений в плане фактологичности ИИ достигалось за счет расширения границ знаний, то есть разработчики просто закладывали в параметры модели больше фактов за счет масштабирования и увеличения объема обучающих данных.
Однако расширение базы знаний модели не приводит автоматически к улучшению ее способности осознавать свои границы — то есть отличать известное от неизвестного и признавать собственные ограничения.
«Существует два основных способа повысить фактологичность LLM, — рассказала VentureBeat Галь Йона (Gal Yona), исследователь из Google и соавтор работы. Первый — продолжать обучать модель новым фактам». Но, как отмечает Йона, «возможности модели конечны, а „длинный хвост“ знаний фактически бесконечен».
Когда модели достигают этого предела, предполагается, что они осознают то, чего не знают, и просто воздерживаются от ответа. Однако для LLM это задача inherent (неотъемлемо) сложная.
«Именно поэтому большинство практических попыток сократить количество галлюцинаций с помощью различных вмешательств так и не доходят до стадии внедрения, — поясняет Йона. — Они действительно уменьшают число галлюцинаций, но при этом наносят ущерб полезности, поскольку модель в итоге отказывается отвечать на те вопросы, которые ей на самом деле известны».
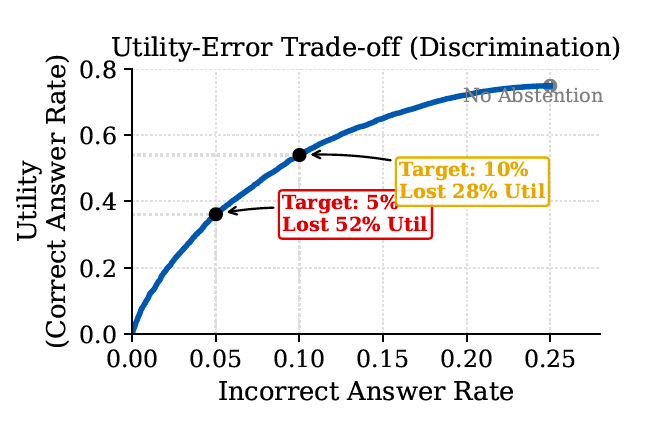
Эта неспособность проводить различие между известным и неизвестным порождает то, что авторы статьи называют «платой за полезность» (utility tax). Навязывание стандарта нулевых галлюцинаций требует от модели воздерживаться от ответов всякий раз, когда она испытывает хотя бы малейшую неуверенность, что приводит к отбрасыванию огромных объемов абсолютно верной информации. Например, авторы демонстрируют, что снижение исходного уровня ошибок с 25% до жесткого целевого показателя в 5% заставляет разработчиков отсеивать 52% правильных ответов модели.
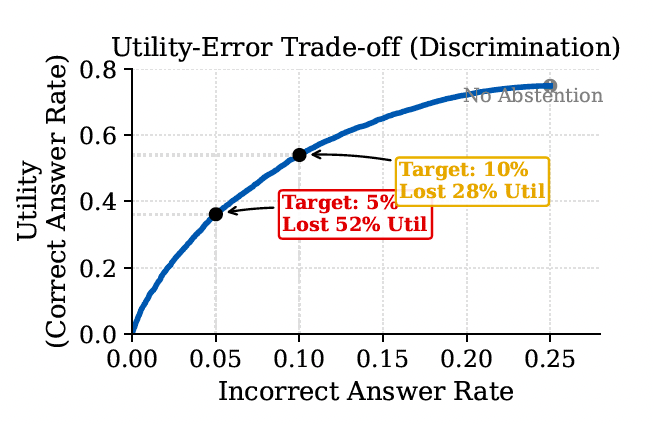
Плата за полезность в виде галлюцинаций (источник: arXiv)
Рассмотрение всех ошибок как галлюцинаций заставляет корпоративные системы выбирать между надежностью и полезностью. Разработчики приложений, как правило, не готовы платить эту огромную «плату за полезность» и превращать свои модели в бесполезные инструменты.
В результате они оптимизируют системы так, чтобы приоритетом оставался охват информации, вынуждая модели работать в режиме, при котором они продолжают генерировать уверенные галлюцинации.
VB Transform · 14–15 июля · Менло-Парк · Агентная оркестровка
Intuit перестроила свою мультиагентную систему за 60 дней. Что они изменили и почему?
На конференции Transform инженерные лидеры из Intuit, Target и Instacart расскажут о том, как они перепроектировали свои архитектуры оркестровки ради надежности, масштабируемости и реальных клиентов.
Переосмысление галлюцинаций как уверенных ошибок
Чтобы преодолеть проблему «платы за полезность», исследователи предлагают перестать рассматривать любую фактическую ошибку как галлюцинацию. Вместо этого они переосмысляют галлюцинации как «уверенные ошибки» (confident errors) — неверную информацию, преподносимую авторитетно и без должных оговорок.
Такое тонкое переосмысление разрушает жесткую дихотомию «ответить или воздержаться» и позволяет модели выражать свою неуверенность.
В рамках этого нового подхода, если модель допускает фактическую ошибку, но соответствующим образом оговаривает свой ответ (например, заявляя: «Я не до конца уверен, но мне кажется…»), это не галлюцинация. Это просто гипотеза, предложенная пользователю на рассмотрение. Выражая неуверенность, ИИ сохраняет свою полезность — делясь имеющимися у него частичными или вероятными знаниями — без ущерба для доверия пользователя.
Тем не менее, если ИИ-ассистент будет снабжать каждый свой ответ дисклеймером, пользователю придется перепроверять абсолютно всё, что полностью сведет на нет смысл использования такого инструмента.
Решение, предлагаемое исследователями, — это «верная неопределенность». Этот подход требует согласования лингвистической неопределенности модели (слов, которые она использует для выражения сомнений) с ее внутренней неопределенностью (фактической внутренней статистической уверенностью в конкретном ответе). Это гарантирует, что модель делает оговорки только тогда, когда ее внутреннее состояние действительно отражает противоречивую информацию или информацию с низкой вероятностью.
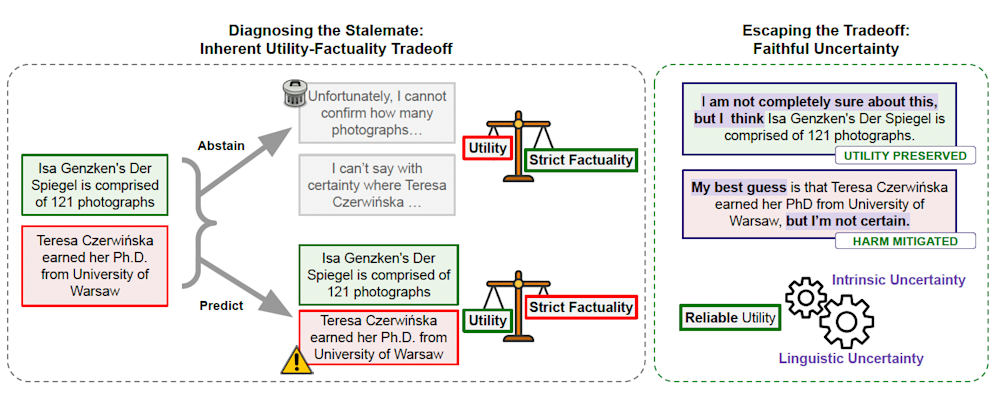
источник: arXiv
Верная неопределенность составляет основу «метакогнитивности» — способности ИИ осознавать собственную неопределенность и действовать с ее учетом. Чтобы понять это на практическом примере, вспомним интуитивную аналогию с визитом к врачу. Мы доверяем врачам не потому, что они всезнающи. Мы доверяем им потому, что они четко различают уверенный диагноз («У вас перелом») и обоснованную гипотезу («Возможно, это растяжение, но давайте проведем тесты»).
Практические последствия для корпоративного ИИ
В рамках новой концепции ошибки, в которых модель искренне уверена, но которые фактически неверны, классифицируются как «честные заблуждения». Это представляет расширение знаний (обучение модели на больших объемах данных) и верную неопределенность как полностью взаимодополняющие усилия. Расширение знаний отодвигает абсолютные границы знаний наружу, минимизируя честные ошибки, в то время как верная неопределенность честно сообщает о том, где именно в данный момент проходят эти границы.
Этот новый подход имеет важные последствия для агентских приложений. Переход к агентскому ИИ может создать впечатление, будто знание о том, чего модель не знает, избыточно, поскольку модели могут просто искать информацию во внешних базах данных. Однако доступ к внешним инструментам на самом деле лишь усиливает потребность в верной неопределенности. В агентских системах метапознание становится центральным уровнем контроля, управляющим всей системой.
Внешние инструменты решают проблему хранения, поскольку модели больше не нужно кодировать каждый факт в своих параметрах. Тем не менее, это порождает новую проблему управления: когда именно следует извлекать информацию, проверять факты и координировать эти внешчные инструменты. Без верной неопределенности агент фактически действует вслепую и вынужден полагаться на внешние статические эвристики или избыточно усложненные структуры.
«Модель может искать то, что ей уже и так достоверно известно — тратя впустую время ожидания и ресурсы без какой-либо выгоды. Или наоборот: она уверенно отвечает по памяти там, где следовало бы выполнить поиск, выдавая правдоподобный, но неверный результат», — отмечает Йона. Современные фреймворки агентов пытаются решить эту проблему снаружи с помощью классификаторов запросов или правил обязательного поиска, однако Йона подчеркивает, что такие решения «статичны и хрупки». Используя свою внутреннюю неуверенность для регулирования собственного поведения, агент динамично оптимизирует использование инструментов, решая задействовать поиск только тогда, когда его внутренняя уверенность действительно низка.
Помимо принятия решений о необходимости поиска, верная неопределенность критически важна для оценки результатов такого поиска. Если инструмент возвращает некачественную или неожиданную информацию, метакогнитивный агент не слепо принимает всё, что попадает в его контекстное окно. Вместо этого он использует осознание своей неуверенности, чтобы сопоставить полученные внешние сигналы со своими собственными внутренними априорными представлениями. Это предотвращает подхалимаж (sycophancy), при котором система могла бы доверять внешним источникам, противоречащим ее собственным достоверным знаниям.
Парадокс бутстрэппинга: подводные камни обучения неопределенности
Для корпоративных разработчиков достижение такой верной неопределенности оказывается сложнее, чем кажется на первый взгляд. Для этого необходимо обучить модели синтаксису неопределенности с помощью контролируемой тонкой настройки (supervised fine-tuning, SFT). Поскольку предварительно обученные модели в основном питаются авторитетными текстами, их нужно явно учить произносить фразы вроде: «Я не совсем уверен, но мне кажется, что VentureBeat была основана в…»
Однако SFT привносит «парадокс бутстрэппинга». В отличие от стандартных обучающих датасетов, где «правильный ответ» одинаков независимо от модели, абсолютной истиной для неопределенности является собственная динамическая база знаний модели.
«В этом-то и подвох: „правильное“ выражение неопределенности по своей сути динамично, поскольку оно зависит от того, что конкретная модель знает или не знает на данном этапе обучения, — говорит Йона. — Если вы обучаете модель на метке, которая говорит „Я не знаю X“, но модель на самом деле знает X, вы учите ее галлюцинировать неуверенность… Обучающие данные статичны, а целевой ориентир подвижен, и это фундаментальное противоречие, с которым командам приходится бороться».
Путь к ИИ, обладающему самосознанием
Для предприятий, стремящихся внедрить эти возможности без дорогостоящей переподготовки, промптинг служит наиболее доступной отправной точкой. «Инженерия промптов — это то, чем большинство инженеров занимаются уже сегодня; это обеспечивает наименее сопротивляемый путь к совершенствованию метакогнитивного поведения в настоящем», — считает Йона. Корпоративные разработчики могут изучить такие фреймворки, как MetaFaith — проект с открытым исходным кодом, соавтором которого ранее выступала Йона, чтобы начать применение метакогнитивного промптинга к готовым моделям.
Тем не менее, Йона предупреждает, что «остается значительный потенциал, который один лишь промптинг решить не в силах», а это означает, что в конечном итоге индустрии придется полагаться на передовое обучение с подкреплением (RL), чтобы глубоко встроить метапознание в процесс обучения моделей.
В конечном счете, по мере того как предприятия переходят от изолированных чат-приложений к сложным мультиагентным рабочим процессам, самосознание станет определяющей предпосылкой для надежной автономности. Но оценка того, действительно ли модель обладает таким осознанием, остается сложнейшей технической задачей.
«Как на самом деле оценить, способна ли модель чувствовать свои внутренние состояния? — задается вопросом Йона. — Даже у людей сложно определить или отделить „истинную“ способность к самонаблюдению от умелой опоры на косвенные признаки. Мы сталкиваемся ровно с теми же трудностями в случае с LLM: модель может научиться имитировать стиль неуверенности, не ощущая при этом своего внутреннего состояния. Разработка систем оценки, способных уловить эту разницу — одна из важнейших нерешенных проблем в данной области».




