Эксклюзив: OpenAI представила Performance Factory — систему оптимизации программного обеспечения на базе Codex, которая обеспечивает высокую скорость работы ChatGPT


Когда обновление программного обеспечения замедляет работу приложения, инженерам приходится проходить через несколько этапов: изучать метрики, отслеживать запросы между сервисами, находить ответственный за проблему код и тестировать возможные решения.
Теперь, когда основную нагрузку по написанию и изменению кода берут на себя ИИ-агенты, ручная проверка изменений кода на предмет производительности становится одним из ключевых узких мест жизненного цикла разработки ПО.
Чтобы решить эту проблему, OpenAI создала Performance Factory — новую внутреннюю ИИ-систему на базе Codex, которая автоматизирует расследование и устранение регрессий производительности. OpenAI уже использует Performance Factory, чтобы ChatGPT оставался быстрым.
Согласно эксклюзивному инженерному отчету, предоставленному VentureBeat, система отследила более 1 700 расследований и установила первопричины более чем 600 случаев всего за три с небольшим месяца. Это в среднем 17 автоматизированных расследований в день.
Performance Factory позволяет увидеть, как агенты для написания кода могут эволюционировать от решения отдельных задач к построению автоматизированных рабочих процессов, координирующих работу ИИ-агентов и инженеров-людей. Такой подход помогает инженерным командам использовать скорость разработки ПО с помощью ИИ, оставляя человеческое внимание для решений, требующих суждения.
От ручной отладки к автоматизированным рабочим процессам
Поначалу команда OpenAI по инженерии производительности полагалась на ручные расследования. Когда сервис замедлялся, инженеры изучали логи и трассировки, просматривали изменения кода и отлаживали работающие системы. Чтобы упростить эти расследования, команда разработала более 30 специализированных инструментов.
Codex изменил то, как инженеры работали с этими инструментами. Вместо того чтобы вручную искать по кодовым базам и телеметрии, инженеры могли спросить Codex, почему сервис стал работать медленнее. Агент мог изучить логи и воспользоваться инструментами, чтобы дать ответ. Но направлять процесс по-прежнему должны были инженеры.
Чтобы снизить эту зависимость, команда разработала многократно используемый навык Codex под названием perf-forensics, который фиксирует процедуры расследования, принятые в команде производительности, чтобы агент мог их воспроизводить.
После тестирования и доработки навыка OpenAI могла передать Codex оповещение о производительности и получить диагноз за один запуск.
На этом этапе инженеры превратились в посредников между системами мониторинга и Codex. Они копировали оповещения в Codex, а затем вставляли результаты в Slack. Поэтому, что вполне естественно, команда просто подключила оповещения к облачным сессиям Codex.
Однако расследования заканчивались диагнозом, который требовал проверки и реализации инженером. Тем временем команда производительности ChatGPT сталкивалась с регрессиями почти ежедневно и с трудом успевала их отслеживать.
В комментариях для VentureBeat команда производительности OpenAI пояснила, что изначально создала систему отслеживания регрессий, чтобы справляться с растущей нагрузкой. Это привело к пониманию того, что каждая отслеживаемая регрессия может стать задачей, которую Codex будет автоматически расследовать и проводить через разные этапы — например, установление первопричины, предложение исправления и проверку восстановления.
Это стало основой архитектуры Performance Factory, построенной на задачах.
Как работает Performance Factory
Performance Factory организует инженерную работу в виде задач, которые проходят через заранее определенные рабочие процессы. Задача может начинаться с оповещения о производительности и продвигаться через расследование, установление первопричины, изменения кода, проверку и верификацию.
Каждая задача хранит свое состояние и результаты независимо, поэтому разные агенты могут работать над одной и той же проблемой на разных этапах. По словам команды производительности OpenAI, запись задачи содержит поле свободной формы, куда агенты оставляют заметки, а также структурированные метаданные — например, когда началась регрессия и когда была установлена ее первопричина.
Вместо того чтобы копировать в задачу большие объемы данных профилирования, агенты записывают релевантные метрики, запросы и общие выводы. Следующий агент получает запись задачи и может заново выполнить эти запросы, если ему нужно проверить результаты. Благодаря этому объем информации, передаваемой между агентами, остается управляемым, а доступ к исходным доказательствам сохраняется.
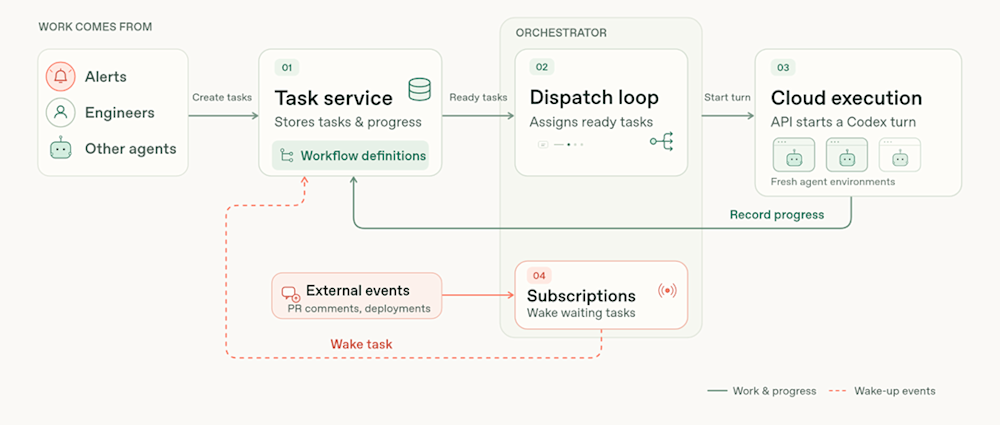
OpenAI Performance Factory (источник: OpenAI)
Система состоит из четырех основных компонентов.
-
Сервис задач хранит задачи и их прогресс. Инженеры определяют рабочие процессы с помощью конфигурационных файлов и предоставляют промпты в формате markdown, определяющие, что агенты должны делать на каждом этапе.
-
Цикл диспетчеризации периодически проверяет задачи. Когда задача готова к переходу на следующий этап, он запускает сессию Codex и назначает ей задачу. Агент записывает свои выводы и обновляет задачу по завершении работы.
-
Третий компонент — внутренний API для запуска Codex в облаке. Агенты работают в средах, имеющих доступ к репозиториям кода OpenAI и инфраструктуре наблюдаемости. Они устроены так, чтобы OpenAI могла контролировать разрешения и отслеживать действия агентов.
-
Наконец, подписки связывают задачи с внешними событиями. Например, если агент открывает pull request и ему нужна проверка инженера, задача может быть приостановлена до получения отзыва инженера на GitHub.
Performance Factory в действии
Первая конкретная реализация Performance Factory в OpenAI — Regression Workflow, ориентированный на регрессии производительности. Regression Workflow запускается при срабатывании настроенного оповещения. Он создает задачу, которую агенты расследуют с помощью навыка perf-forensics, ранее разработанного командой OpenAI.
Сначала агент определяет, что изменилось: он изучает затронутые метрики и выясняет, когда производительность начала ухудшаться и какие запросы пострадали.
Сузив круг поиска, агент пытается установить причину, изучая ряд артефактов, включая изменения кода, логи и трассировки.
Однако в OpenAI обнаружили, что агенты иногда останавливались на первом правдоподобном объяснении, даже если доказательства не полностью его подтверждали.
Чтобы решить эту проблему, команда внедрила процесс «состязательной проверки», в котором отдельная сессия Codex оспаривает исходный диагноз. Проверяющий получает всю запись задачи, но начинает с чистого контекста. Его инструкции прямо предписывают находить пробелы в диагнозе, проверять подтверждающие доказательства и тестировать альтернативные объяснения. Это позволяет проверяющему посвятить всю сессию оспариванию выводов исходного агента.
Например, в одном из расследований агент связал сбои в разговорах ChatGPT с ошибками при загрузке изображений. Проверяющий агент заметил, что внутренний сервис, отвечающий за поиск файлов, уже восстановился, тогда как запросы изображений продолжали завершаться ошибкой. Поэтому проверяющий вновь открыл расследование, поскольку исходный диагноз не объяснял продолжающиеся сбои.
По словам команды производительности OpenAI, поначалу состязательный проверяющий возвращал на доработку значительное число диагнозов. Команда использовала эту обратную связь для улучшения инструкций исходного агента-расследователя, сократив число случаев, возвращаемых на дополнительную работу. Сейчас состязательная проверка возвращает около 25% диагнозов.
Когда диагноз проходит состязательную проверку, Codex предлагает исправление и открывает pull request. Инженер проверяет код и решает, выполнять ли слияние.
Результаты показывают разрыв между диагностикой проблем и внедрением надежных исправлений. По данным команды производительности OpenAI, из более чем 600 расследований, дошедших до установления первопричины, около 400 продвинулись до предложенного исправления. Примерно 50 исправлений, которые в итоге были выпущены, были созданы под влиянием предложений агентов или совпадали с ними, а около 15 выпущенных исправлений представляли собой именно те pull requests, которые написал Codex.
Команда признает, что эти результаты не дотягивают до ее амбиций в области автоматического устранения проблем. Однако значительная часть работы по устранению регрессий связана с их обнаружением, установлением причин, отслеживанием прогресса и проверкой восстановления. Performance Factory автоматизировала большую часть этого процесса, а повышение качества предлагаемых исправлений остается приоритетом. OpenAI также завершила создание набора тестов для оценки рабочих процессов, который планирует использовать для улучшения исправлений, генерируемых агентами.
Команда производительности OpenAI выяснила, что Codex лучше всего справляется, когда причина регрессии ясна, а исправление относительно локально. Например, изменение кода может привести к тому, что приложение несколько раз сериализует один и тот же разговор при обработке запроса. Codex может выявить избыточную работу и предложить сериализовать разговор один раз и повторно использовать результат.
Более сложные изменения по-прежнему представляют трудность, особенно когда новая функция увеличивает задержку и требует архитектурных изменений. Агенты иногда предлагают чрезмерно сложные исправления или создают новые проблемы. Например, добавление кэша может сократить время отклика, но привести к устареванию данных. Поэтому OpenAI добавила состязательную проверку и для предлагаемых исправлений.
После того как инженер развертывает исправление, другой агент проверяет, устранена ли проблема с производительностью. Если проблема сохраняется, рабочий процесс отправляет задачу обратно на дальнейшее расследование.
Еще одной проблемой, которую пришлось решать OpenAI, стало управление объемом выводов, генерируемых агентами. Изначально инженерам предоставили пользовательский интерфейс, переполненный результатами расследований, и им приходилось самим определять, какие выводы важны.
Теперь система облегчает инженерам навигацию по результатам: она группирует связанные инциденты, ранжирует их по оценочному влиянию и формирует сжатые отчеты с графиками и метриками. Это помогает инженерам оценивать предлагаемые изменения, не восстанавливая каждое расследование по необработанным выходным данным агентов.
Уроки для корпоративных ИИ-команд
Разработчики агентных рабочих процессов могут извлечь несколько ключевых уроков из работы OpenAI над Performance Factory. Эти практики применимы к агентным системам и за пределами инженерии производительности.
Избегайте ИИ-усталости. Там, где люди должны проверять результаты работы ИИ-агента, старайтесь, чтобы им предоставлялась наиболее существенная информация, — иначе их захлестнет избыток контента (так называемый AI slop).
Сохраняйте доказательства, не перегружая контекст агента. Подход OpenAI, при котором в записях задач хранятся общие выводы и воспроизводимые запросы, позволяет агентам передавать работу друг другу без пересылки больших объемов необработанной телеметрии. Этот шаблон помогает командам строить многоэтапные рабочие процессы, которые остаются управляемыми по мере усложнения расследований.
Оценивайте агентов и их взаимодействие с людьми. OpenAI проводит ретроспективное тестирование расследований на исторических инцидентах, измеряя, насколько точно агенты определяют момент начала проблем, их влияние и возможные причины. Такие оценки требуют осторожности: исторические данные могут устаревать, а информация, собранная после инцидента, может раскрыть правильный ответ. Команда также отдельно оценивает сводки, генерируемые агентами, чтобы понять, могут ли инженеры разобраться в доказательствах и предлагаемых действиях.
Отслеживайте работу самих агентов. OpenAI ежедневно запускает агента, который изучает недавние логи агентов на предмет повторяющихся сбоев инструментов и проблем с разрешениями. Когда он находит проблему, которая регулярно блокирует расследования, Performance Factory может создать задачу и предложить исправление на проверку инженеру. Затем оценки проверяют, устраняет ли изменение проблему.
От реактивного обслуживания к непрерывной оптимизации
Сейчас Performance Factory сосредоточена на реагировании на настроенные оповещения, но OpenAI планирует расширить ее до проактивной оптимизации.
Команда изучает возможности для агентов сравнивать профили CPU, данные о памяти и трассировки запросов между релизами, чтобы выявлять замедления, которые могут пропустить оповещения мониторинга. Она также разрабатывает рабочие процессы для таких задач, как подбор оптимального размера сервисов, где агенты могут выявлять неэффективные конфигурации автомасштабирования.
OpenAI изучает, смогут ли агенты в будущем развертывать некоторые низкорисковые исправления без одобрения человека.
По словам команды производительности OpenAI, автоматизация расследований регрессий позволила инженерам уделять больше времени долгосрочному повышению производительности вместо постоянного реагирования на инциденты. Команда также надеется превращать знания, полученные инженерами в ходе отдельных расследований, в многократно используемые рабочие процессы, способные улучшать сервисы по всей организации.
Такой подход может позволить инженерным командам сохранять и применять знания о производительности в разных проектах и сервисах. Уроки одного расследования могут подсказать агентам, как выявлять и устранять похожие проблемы спустя месяцы, сокращая объем рутинной отладки и позволяя инженерам сосредоточиться на более стратегических оптимизациях.