До 60% вычислительных мощностей GPU уходит на повторный расчёт контекста. Флеш-память может вернуть эти ресурсы в работу
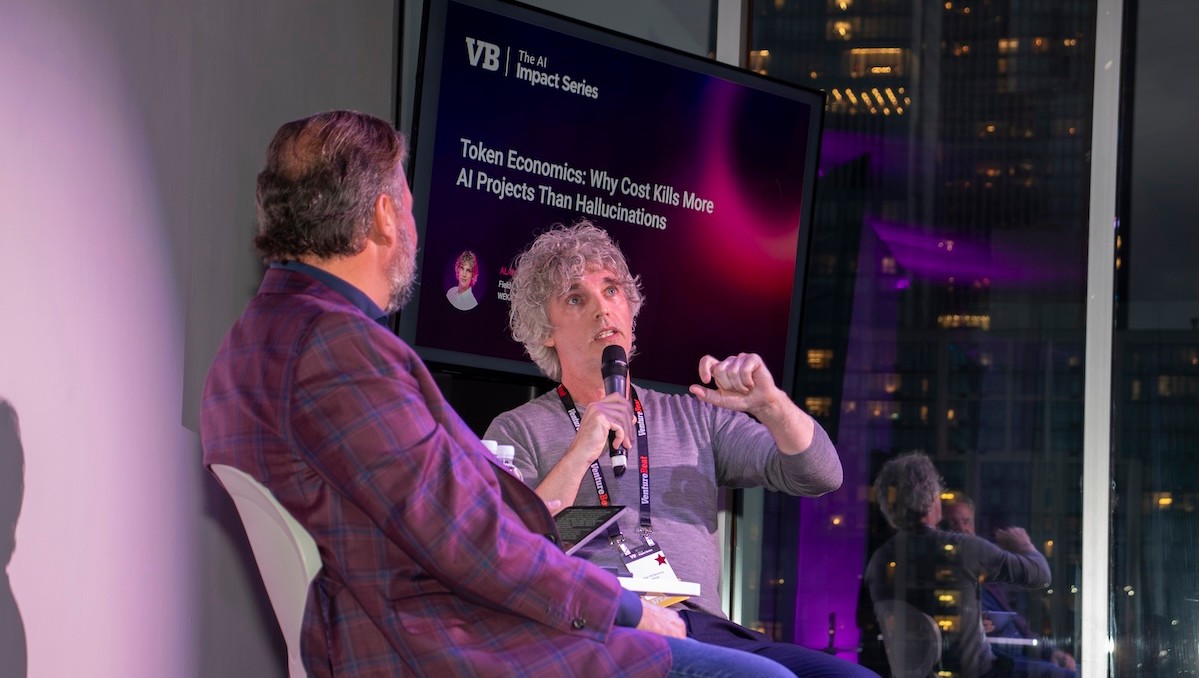


Графические процессоры (GPU), выполняющие инференс больших языковых моделей, могут тратить до 60% вычислительных ресурсов на повторный расчёт контекста, который уже обработали, говорит Алан МакСевени, технический директор WEKA по работе с клиентами. В беседе с ведущим аналитиком VentureBeat Робом Стречэем на последнем мероприятии серии VentureBeat AI Impact Series МакСевени объяснил, что причина потерь — в том, как большие языковые модели хранят историю диалога в памяти GPU. По его словам, устранение этой проблемы позволяет компаниям обслуживать в несколько раз больше пользователей на уже имеющемся оборудовании. Наибольшие сложности у клиентов WEKA с повышением эффективности возникают на уровне инфраструктуры — отдельно от показателей приложений, которые каждая компания оптимизирует под свою сферу деятельности.
«Ограничения, с которыми сталкиваются компании, связаны с бюджетом, доступностью электроэнергии и площадями дата-центров, — сказал МакСевени. — Сейчас эти факторы мешают многим организациям расти, поэтому все пытаются получить больше отдачи от уже сделанных капитальных вложений».
Почему GPU повторно вычисляют кэш KV при многоэтапном инференсе LLM
При многоэтапном инференсе GPU сохраняют обработанный контекст в кэше KV, чтобы не пересчитывать его после каждого обмена сообщениями. Но память GPU ограничена: когда старый контекст вытесняется, после возобновления сеанса GPU может понадобиться заново обработать ту же историю.
«Если не использовать стратегию работы с этой проблемой, загрузка GPU при выполнении новых задач может опуститься до 30%, — сказал он. — При грамотной стратегии она может превышать 90%, а в лучшем случае достигать 95%».
По его словам, когда компания строит собственную инфраструктуру для задач ИИ, на GPU приходится более 80% бюджета, поэтому карта, которая тратит вычислительные циклы на повторные расчёты, — это «колоссальная трата денег».
Флеш-память NVMe эффективнее DRAM для выгрузки кэша KV
Индустрия уже переходит к более активному повторному использованию и выгрузке кэша KV — от Mooncake и недавних методов DeepSeek до платформы контекстной памяти Nvidia CMX, встроенной в стек Vera Rubin. МакСевени утверждает, что флеш-память NVMe — более экономичное место для хранения такого кэша, чем увеличение объёма серверной DRAM: она не уступает DRAM в хранении кэша KV, гораздо лучше масштабируется и обходится намного дешевле.
«Вы как можно быстрее выгружаете эти данные, освобождаете GPU для другого пользователя, а затем загружаете данные обратно, когда они ему понадобятся», — сказал он.
От скорости такой замены зависит, сколько людей может обслуживать один GPU. Если система умеет достаточно быстро выгружать кэш и загружать его обратно, каждый GPU может обслуживать в четыре-пять раз больше пользователей. Компания, которой не хватает мощностей, сможет разместить на имеющихся серверах в четыре-пять раз больше людей или агентов, прежде чем заказывать ещё один GPU.
Как Augmented Memory Grid от WEKA распределяет кэш KV между серверами с GPU
Augmented Memory Grid от WEKA, работающая на программном обеспечении для хранения данных NeuralMesh, извлекает кэш KV с серверов с GPU, хранит его централизованно и загружает обратно на любой узел в дата-центре. Поэтому сеанс можно приостановить на одном сервере и продолжить на другом, не заставляя второй GPU повторно обрабатывать историю.
По словам МакСевени, централизованное хранение кэша KV позволило увеличить число пользователей на тех же GPU в семь раз и поднять объём вывода с 200 000 до 2 миллионов токенов за тот же период — по сравнению с выгрузкой в DRAM. Однако оптимизация кэша не решает проблему на уровне приложения.
«Всё равно нужно максимально оптимизировать приложение, рабочий процесс и конвейер», — пояснил он.
Решение о том, что оптимизировать в первую очередь — веса модели с помощью квантования и тонкой настройки или обвязку модели, — зависит от клиента. Однако большинство команд с реальным опытом работы с LLM уже научились сокращать число галлюцинаций, уменьшать потери и проверять результаты. Гораздо заметнее пробел в знаниях об инфраструктуре: многие клиенты до сих пор не знают, сколько резервных мощностей можно высвободить в их существующих системах для обработки большего числа запросов и обслуживания большего числа пользователей.
Как получить выгоду от экономии на кэше KV — за счёт GPU или API с оплатой за токен
По словам МакСевени, вопрос не в том, стоит ли строить собственный стек вместо использования размещённого сервиса: выгоду получает тот, кто контролирует GPU. Это может быть как компания, использующая собственное оборудование, так и компания, арендующая отдельные экземпляры GPU и запускающая на них собственное программное обеспечение.
«Если вы платите провайдеру базовой модели за каждый токен, большая часть выгоды от кэширования на его стороне достаётся ему, а не вам», — сказал он.
Это становится ещё важнее по мере сокращения доступности GPU. МакСевени напомнил, что Google сообщила клиентам: на каждый GPU, заказанный для Google Cloud, но ещё не установленный, уже есть покупатель на весь срок его эксплуатации. А клиентам, не оформившим резервирование до декабря, не стоит рассчитывать на доступность мощностей по запросу. Поставщики услуг, закупающие оборудование в условиях того же дефицита, столкнутся с аналогичными ограничениями.
«Создание части собственной инфраструктуры, возможно, не придёт вам в голову в первую очередь, — сказал МакСевени. — Но это может стать необходимостью».