Модели принятия решений, такие как Jev, справляются с тем, чего не могут правила SQL. Вот как команды по работе с данными их используют


Платформы данных принимают решения весь день. SQL-запрос оставляет строки, значения в которых превышают порог, находит совпадения по ключевому слову и объединяет две таблицы по общему идентификатору. Если задание завершается с ошибкой, конвейер отправляет его на повторный запуск. Такие правила работают, когда ответ представлен в данных в четкой форме.
Но они дают сбой, когда ответ зависит от языка или приблизительной оценки. Срочный ли это запрос в службу поддержки? Описывают ли две записи о донорах одного и того же человека? Относится ли должность к продажам или к разработке? Команды по работе с данными решали такие задачи с помощью моделей машинного обучения (ML), обученных для одной конкретной задачи, или больших языковых моделей (LLM), которые выдают текст, подлежащий обработке кодом.
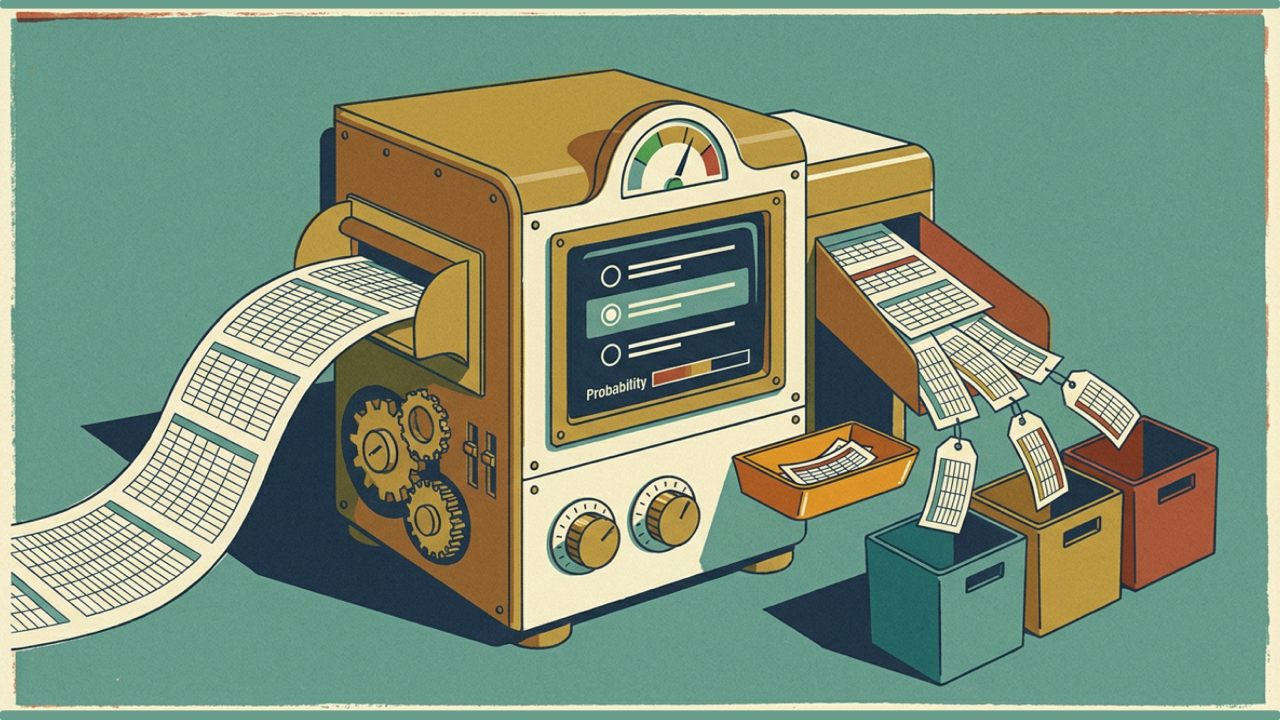
Модели принятия решений, также известные как модели «Система 1», предлагают еще один вариант. Они выносят одно конкретное суждение — например, определяют, является ли запрос срочным, — и возвращают структурированный ответ. Сторонники считают, что их главное преимущество — соответствие задаче. Многие подобные операции сводятся к небольшим решениям, которые повторяются для миллионов строк, и для них не нужны ни абзац текста, ни отдельная модель, обученная под каждую задачу.
В последние недели рынок моделей принятия решений стремительно вырос после того, как 15 сентября TypeSafe AI представила Jev. Модель возвращает вариант, оценку или ответ «да» или «нет» — каждый с показателем уверенности. Такой ответ можно поместить в столбец и использовать для следующего шага конвейера. Поставщики платформ данных, включая Databricks, Snowflake, MotherDuck и Astronomer, опубликовали информацию о поддержке этого подхода или инструкции по работе с моделями принятия решений. На рынке также появились новые варианты таких моделей от AWS, OpenAI и Cloudflare, что расширило их выбор.
Майкл Леоне, вице-президент и ведущий аналитик Moor Insights & Strategy, сказал, что решающее значение имеет формат ответа.
«Чат-модель выдает абзац, который нужно обработать, тогда как модель принятия решений возвращает метку и вероятность, которые сразу попадают в столбец. С ними можно работать как с любыми другими данными в хранилище: фильтровать, объединять и формировать отчеты», — сказал Леоне в интервью VentureBeat.
Что такое модель принятия решений и какое место она занимает в стеке данных
Модель принятия решений отвечает на вопрос типизированным значением, а не текстом.
Получив входные данные и набор вопросов, модель принятия решений, такая как Jev, возвращает вариант из фиксированного списка, оценку по шкале или вероятность ответа «да» либо «нет». В публикации о запуске TypeSafe говорится, что возможные варианты ответа задаются заранее, поэтому каждый ответ соответствует ожидаемому типу и сопровождается показателем уверенности.
Паван Потхукучи, руководитель платформы ИИ в Snowflake, сказал, что выбор между SQL, моделью принятия решений и универсальной LLM зависит от того, как должен выглядеть ответ. Модель принятия решений подходит, когда ответ нужно выбрать из известного набора вариантов, выставить по критериям или представить как «да» либо «нет», а задача выполняется для тысяч или миллионов строк. Для составления резюме, извлечения данных в свободной форме и полноценного многоэтапного рассуждения по-прежнему нужна универсальная LLM.
«Если задачу можно решить обычным SQL — например, проверить, превышает ли значение порог, или найти совпадение по ключевому слову, — просто используйте SQL», — сказал Потхукучи в интервью VentureBeat. «Это дешевле, и вы точно знаете, что именно он делает».
По словам Потхукучи, лучшие конвейеры сочетают все три подхода. SQL выполняет детерминированную фильтрацию, модель принятия решений выносит многочисленные суждения и направляет работу, а к более крупной модели обращаются только в сложных случаях.
Как платформы данных интегрируют модели принятия решений
В последние недели платформы данных внедряли модели принятия решений несколькими способами.
Databricks выбрала два пути. Один из вариантов — использовать SemIf-OpenJev, проект сообщества с открытыми весами, который извлекает вероятности вариантов из существующей открытой модели. Он работает на бессерверных графических процессорах, а вызывать его можно из SQL с помощью ai_query. Кроме того, Databricks представила ai_decide — SQL-функцию, которая сейчас находится в бета-версии и работает на основе модели принятия решений, совместимой, по словам компании, с API TypeSafe.
Snowflake Decision, доступная сейчас в режиме закрытого тестирования, вызывается через функцию AI_COMPLETE в Cortex AI Functions. Потхукучи сказал, что модель создана специально для принятия решений и работает внутри защищенного периметра Snowflake в рамках существующих политик управления данными. По его словам, Snowflake также добавляет версию с меньшей задержкой под названием Snowflake Decision Fast и предоставляет доступ к моделям принятия решений через Cortex REST API, не уточнив сроки.
Расширения сообщества позволяют напрямую встраивать Jev в SQL-движки. Одно из них — расширение DuckDB — добавляет функции jev и jev_choice, а расширение Postgres делает то же самое для PostgreSQL.
Что создают команды по работе с данными
Для моделей принятия решений типа Jev все еще очень рано, однако уже появляются различные варианты их применения.
«Мы видим пять основных сценариев использования моделей принятия решений, которые интересуют клиентов: определение настроений пользователей; классификация документов, электронных писем и запросов в службу поддержки; маршрутизация ИИ-агентов; сопоставление данных в разных системах; а также принятие операционных решений и решений в сфере управления рисками», — сказал Потхукучи.
Классификация и оценка
Astronomer, продающая управляемый сервис Astro для Apache Airflow, сообщила, что использует в производственной среде задание для сортировки примерно 250 000 должностей по типу сотрудника и функции. Сейчас оно работает с помощью функции AI_CLASSIFY в Snowflake. В тесте на 4 000 должностей Astronomer сообщила, что Jev справилась за 66 секунд и 16 центов, тогда как та же задача с AI_CLASSIFY по стандартной цене обошлась бы, по оценке компании, в 11–21 доллар.
MotherDuck, продающая облачный сервис на базе DuckDB, добавила функцию SQL prompt_jev() в свои платные тарифы. В одном из примеров в анонсе функция извлекает основную жалобу из таблицы с расшифровками обращений в поддержку. По результатам внутреннего теста на 100 000 новостных статей из общедоступного набора данных по четырем темам MotherDuck сообщила, что Jev классифицировала строки за 40 секунд, потратив 50 центов, с точностью 89%. По данным MotherDuck, модель OpenAI показала точность 88% почти за 32 минуты, обойдясь в 37,58 доллара.
Сопоставление
Southbridge AI, стартап, занимающийся задачами в области данных и ИИ, использовал Jev для сопоставления доноров и комитетов в отчетах о финансировании избирательных кампаний в Огайо. Согласно отчету стартапа, конвейер, в котором Jev выполняла основную работу, а вторая модель проверяла случаи с низкой уверенностью, позволил сократить расходы на модели на 99,56% по сравнению с передовой моделью.
Управление конвейерами
Astronomer сообщила, что поддержка Jev появится в следующей версии пакета Airflow common AI provider. Оператор может направлять рабочий процесс в зависимости от ответа модели, а строки с показателем уверенности ниже заданного порога — отправлять на проверку человеку. Отдельная политика повторных попыток позволяет спросить модель, какая именно ошибка произошла: при ошибке доступа задание сразу завершается, а при сетевой ошибке повторяется после короткой паузы.
Что следует учесть перед внедрением модели принятия решений
Чтобы понять, подходит ли модель принятия решений для конкретного конвейера данных, нужно изучить задачу и взвесить возможные варианты.
Стефани Уолтер, руководитель направления по стеку ИИ в HyperFRAME Research, отметила, что платформы данных уже много лет поддерживают модели машинного обучения для классификации, оценки и прогнозирования. Модели вроде Jev позволяют разработчикам задавать критерии поиска — например, выявлять в обращениях в службу поддержки угрозы отмены заказа, — не обучая для этой задачи отдельную модель.
«Это может упростить применение ИИ к корпоративным данным, но сравнивать его следует с традиционным машинным обучением и правилами, а не только с дорогими универсальными LLM», — сказала Уолтер в интервью VentureBeat. «Клиентам следует делать выбор с учетом точности, трудозатрат на поддержку и совокупной стоимости».
Дело не только в стоимости. Уолтер предупредила: то, что модель превосходит по цене избыточно крупную модель, еще не означает, что она лучше всего подходит для задачи.
Еще один важный фактор — показатель уверенности. Каждый ответ Jev сопровождается вероятностью, и команды используют ее, чтобы решать, какие строки обрабатывать автоматически, а какие передавать человеку.
«Больше всего людям нравится вероятность, которая сопровождает каждый ответ: они могут сами определить, где провести границу», — сказал Потхукучи.
Однако эту границу все равно нужно проверить.
«Каждый ответ также сопровождается оценкой уверенности модели, и эти оценки нужно проверить на собственных данных, прежде чем предпринимать какие-либо действия. Модель, которая уверенно выглядит на тестовых данных поставщика, может гораздо чаще ошибаться на ваших данных», — сказал Леоне.
Что это значит для предприятий
Для специалистов по данным и команд ИИ распространение моделей принятия решений имеет несколько последствий.
«В будущем модели принятия решений станут диспетчерами трафика внутри конвейеров ИИ и рабочих процессов агентов, — сказал Потхукучи. — Они будут определять, что требуется для каждого запроса, и направлять его в нужное место».
Это поднимает вопрос о том, кто отвечает за решения, принимаемые такими моделями.
«Пока никто по-настоящему не определил, кто отвечает за эти решения, — сказал Леоне. — Кто-то должен задать варианты, из которых модели разрешено выбирать: например, в какие команды можно направить обращение или что считать подозрительным требованием. Это решение бизнеса, которое часто оказывается погребено где-то в конвейере данных».
Модели принятия решений вполне могут стать для команд по работе с данными еще одной отличной возможностью усилить свое влияние.
«Думаю, платформы данных будут конкурировать за то, чтобы встроить в платформу механизмы распределения ответственности и проверки — так же, как они поступили с управлением данными», — сказал Леоне.