Стэнфорд и Nvidia повышают эффективность обучения ИИ


Новое исследование исследователей из Стэнфордского университета и Nvidia предлагает способ для моделей ИИ продолжать обучение после развертывания — без увеличения затрат на инференс. Для корпоративных агентов, которым приходится обрабатывать длинные документы, тикеты и логи, это попытка обрести «долгую память», не платя за затраты на внимание, которые растут вместе с длиной контекста.
Этот подход, получивший название «сквозное обучение во время инференса» (End-to-End Test-Time Training, TTT-E2E), переосмысляет языковое моделирование как задачу непрерывного обучения: вместо того чтобы запоминать факты на этапе предварительного обучения, модели учатся адаптироваться в реальном времени по мере обработки новой информации.
Результатом стал трансформер, который способен соответствовать точности моделей с полным вниманием на длинных контекстах, работая при этом с эффективностью, близкой к RNN, — это потенциальный прорыв для корпоративных рабочих нагрузок, где длина контекста вступает в конфликт со стоимостью.
Компромисс между точностью и эффективностью
Для разработчиков, создающих системы ИИ для работы с длинными документами, выбор архитектуры модели часто сопряжен с болезненным компромиссом между точностью и эффективностью.
С одной стороны находятся трансформеры с полным самовниманием, которые в настоящее время являются золотым стандартом точности. Они спроектированы так, чтобы сканировать ключи и значения всех предыдущих токенов для каждого нового сгенерированного токена, обеспечивая безошибочное извлечение информации. Однако эта точность обходится в высокую цену: вычислительные затраты на один токен значительно возрастают с увеличением длины контекста.
С другой стороны находятся последовательностные модели с линейным временем работы, которые сохраняют затраты на инференс постоянными, но с трудом удерживают информацию на очень длинных контекстах.
Другие подходы пытаются найти золотую середину — внимание со скользящим окном, гибриды, сочетающие внимание с рекуррентностью, и прочие трюки для повышения эффективности, — но они по-прежнему уступают полному вниманию в сложных задачах языкового моделирования.
Ставка исследователей заключается в том, что недостающим элементом является сжатие: вместо того чтобы пытаться точно воспроизвести каждый токен, модели должны преобразовывать то, что действительно важно, в компактное состояние.
Обучение во время инференса (Test-Time Training)
Главная инновация работы заключается в применении обучения во время инференса (TTT) к языковому моделированию. Это превращает модель из статической базы данных в гибкого ученика.
При стандартном развертывании ИИ модели обучаются минимизации потерь, после чего развертываются как замороженные артефакты. Если вы попытаетесь заставить статическую модель учиться во время работы, она обычно показывает плохие результаты, поскольку ее никогда не учили эффективно обновлять себя.
Исследователи решают эту проблему, переходя от стандартного предварительного обучения (обучения модели фактам) к метаобучению (обучению модели тому, как учиться). Цель состоит в том, чтобы оптимизировать «инициализацию» модели так, чтобы она могла быстро поглощать новую информацию при переходе в рабочий режим.
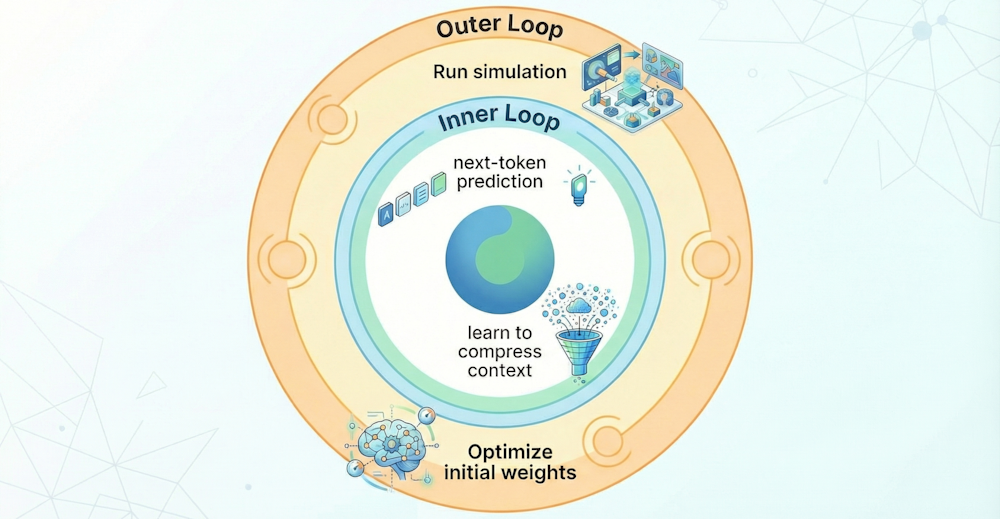
Обучение во время инференса использует два цикла для оптимизации моделей в рамках «метаобучения» (источник: VentureBeat с NotebookLM)
Процесс включает в себя симуляцию обучения во время инференса на этапе тренировки:
-
Внутренний цикл (обучение): Во время обучения модель воспринимает текст как поток и выполняет небольшие временные обновления по мере прогнозирования следующего токена, симулируя то, как она адаптировалась бы при инференсе.
-
Внешний цикл (обучение обучению): Затем система обновляет инициализацию модели, чтобы следующий раунд потоковой адаптации происходил быстрее и точнее.
Хотя идея изменения весов модели во время развертывания может показаться рискованной для руководителей предприятий, ориентированных на надежность, соавтор Ю Сун утверждает, что математически это безопаснее, чем кажется.
«Модель стоит воспринимать как RNN с огромным скрытым состоянием», — говорит Сун. Он отмечает, что если компания считает безопасным развертывание стандартных трансформеров или RNN, профиль стабильности TTT сопоставим с ними.
Архитектура с двумя видами памяти
Для реализации TTT-E2E исследователи модифицировали стандартную архитектуру трансформера, чтобы поддержать эту новую парадигму обучения, создав иерархию, которая разделяет дешевую обработку кратковременного контекста и выборочные обновления долгосрочной памяти.
-
Модель использует внимание со скользящим окном (Sliding Window Attention) вместо полного внимания. Это служит «рабочей памятью» модели, которая обращается только к фиксированному окну недавних токенов для обработки мгновенного синтаксиса и локальных ссылок. Это гарантирует, что стоимость обработки нового токена остается постоянной, а не растет по мере расширения контекста.
-
Модель использует «целевые обновления весов». В то время как у стандартных моделей веса полностью заморожены во время использования, TTT-E2E назначает определенные разделы (слои многослойного перцептрона в последних 25% блоков модели) изменяемыми.
-
Архитектура использует «двухпотоковое хранилище», чтобы модель не забывала свои общие знания при изучении нового документа. Каждый обновляемый блок содержит два компонента MLP: один статичный слой, хранящий общие предварительно обученные знания, и один динамический слой, который обновляется в реальном времени для хранения контекста текущего документа.
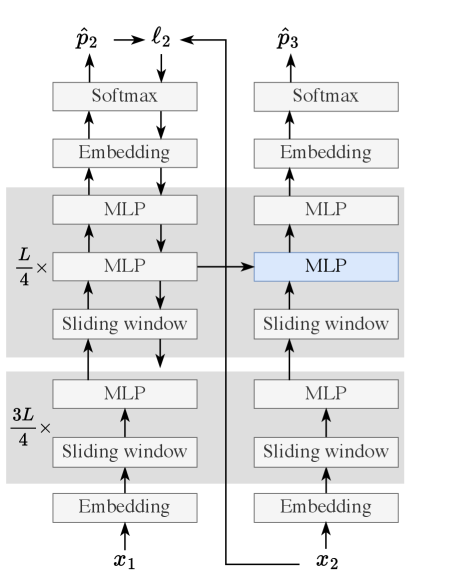
Архитектура TTT-E2E (источник: arXiv)
Инновация заключается в том, как модель обрабатывает информацию, выходящую за пределы скользящего окна. В стандартной модели со скользящим окном, как только токен покидает поле зрения, он забывается. TTT-E2E предотвращает это с помощью сжатия. По мере перемещения окна модель использует предсказание следующего токена для «сжатия» проходящей информации прямо в веса динамических слоев MLP. Это консолидирует суть и факты из более ранних частей документа в структуру модели, служа долгосрочной памятью.
TTT-E2E в действии
Главный результат: TTT-E2E продолжает улучшаться по мере роста длины контекста — догоняя полное внимание или превосходя его, — в то время как эффективные базовые модели выходят на плато примерно после 32 000 токенов.
Чтобы подтвердить свой подход, исследователи обучили модели размером от 125 миллионов до 3 миллиардов параметров. Они использовали двухэтапный процесс обучения: предварительное обучение на контекстах из 8 000 токенов и тонкую настройку на контекстах из 128 000 токенов. Эти модели тестировались в сравнении с надежными базовыми моделями, включая трансформеры с полным вниманием, трансформеры со скользящим окном внимания (SWA), гибридные модели (Mamba 2 и Gated DeltaNet) и TTT-KVB (более ранняя форма обучения во время инференса).
Результаты подчеркивают значительный прорыв в масштабировании. Самый критический эксперимент проверял производительность по мере увеличения входного документа с 8 000 до 128 000 токенов. Трансформер с полным вниманием, являющийся золотым стандартом, продолжал улучшать свою производительность (снижать потери) по мере роста контекста. Напротив, эффективные базовые модели, такие как Mamba 2, Gated DeltaNet и SWA, уперлись в потолок, и их производительность ухудшалась или выравнивалась после 32 000 токенов.
Новый метод TTT-E2E успешно масштабировался с длиной контекста, имитируя поведение полного внимания. В экспериментах с использованием моделей на 3B параметров TTT-E2E фактически поддерживал более низкую перплексию (лучшую производительность), чем полное внимание на протяжении всего контекстного окна.
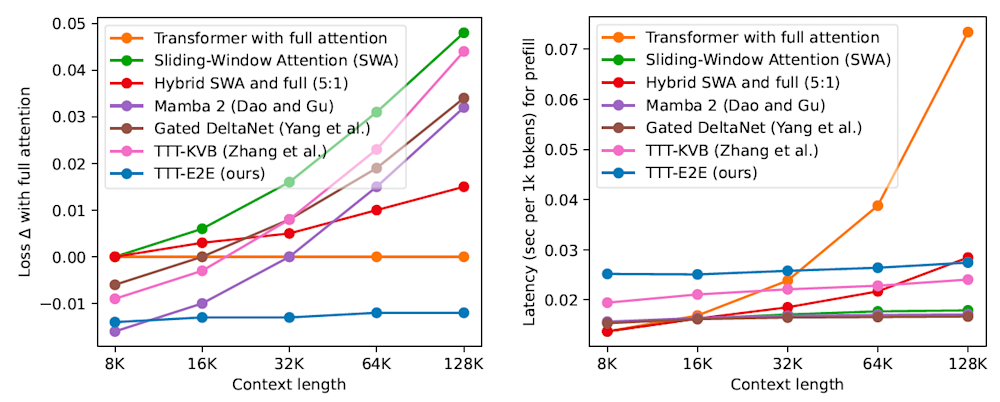
TTT-E2E практически достигает точности трансформеров с полным вниманием, сохраняя при этом эффективность моделей на базе RNN (arXiv)
Что критически важно, эта производительность не была достигнута в ущерб скорости. По задержке инференса TTT-E2E соответствовал эффективности RNN. При длине контекста в 128 тыс. токенов TTT-E2E работал в 2,7 раза быстрее трансформера с полным вниманием на оборудовании Nvidia H100.
Что крайне важно для внедрения, Сун отмечает, что модели TTT можно развертывать для инференса уже сегодня на стандартной инфраструктуре трансформеров для достижения такого ускорения. Однако он предупреждает, что сторона обучения (в частности, внешний цикл) в настоящее время является более сложной и медленной, чем стандартные методы, что представляет собой препятствие, требующее инженерной оптимизации.
Преимущества становятся еще более разительными по мере масштабирования данных. Сун утверждает, что это преимущество должно еще больше увеличиться на контекстах длиной в миллион токенов, хотя эти цифры являются прогнозами, а не сегодняшними результатами бенчмарков.
Тем не менее, подход имеет специфические ограничения, обусловленные его философией проектирования. Исследователи провели тест «Иголка в стоге сена», который требует от модели извлечь конкретную, изолированную часть информации (например, пароль), спрятанную в большом блоке текста. В этой оценке полное внимание значительно превзошло все остальные методы, включая TTT-E2E.
Это происходит потому, что полное внимание полагается на кэш, который обеспечивает практически безошибочное извлечение конкретных деталей, в то время как TTT-E2E полагается на сжатие. Сжатие отлично улавливает интуицию и основную информацию, но может терять специфические, случайные детали, которые не вписываются в изученные паттерны.
Это различие имеет серьезные последствия для корпоративных конвейеров данных, в частности для RAG (поисково-дополненной генерации). Сун предполагает, что TTT не сделает RAG устаревшим, но переопределит его. Он сравнивает TTT с «обновлением человеческого мозга» общими знаниями, в то время как RAG останется необходимым инструментом для обеспечения точности, «подобно тому, как людям все еще нужно записывать вещи в блокнот». Для корпоративных команд вывод заключается в том, что TTT сокращает частоту обращения к поиску, но не устраняет потребность в точной внешней памяти.
Хотя метод был продемонстрирован на архитектуре трансформеров, исследователи отмечают, что «в принципе, TTT может быть применен к любой базовой архитектуре», которая позволяет разделять компоненты долгосрочной и кратковременной памяти.
«Мы верим, что эти два класса памяти будут продолжать дополнять друг друга», — заключили исследователи.
Заглядывая в будущее, Сун прогнозирует смену парадигмы, при которой основной формой памяти ИИ станет сильно сжатая, а не точная память. Хотя модели сохранят «разумное» окно идеального запоминания размером около 128 000 токенов, он верит, что архитектуры TTT в конечном итоге откроют «сжатую память из миллиардов токенов», кардинально изменив то, как корпоративные агенты балансируют между способностью к воспроизведению, стоимостью и длиной контекста.