


Meta: инфраструктура не готова к ИИ-агентам
Источник: VentureBeat · Sean Michael Kerner


Организациям необходимо трансформироваться, чтобы соответствовать потребностям агентного ИИ.
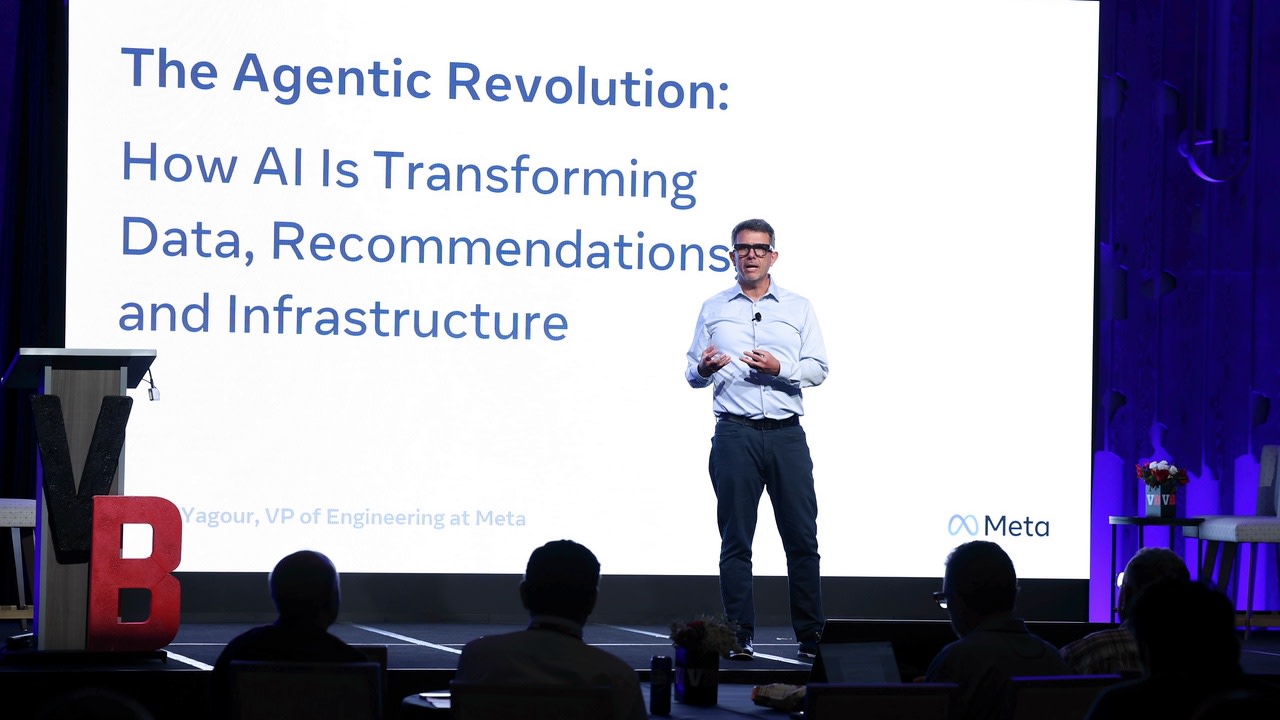
Вице-президент Meta по инженерным разработкам Барак Ягур (Barak Yagour) начал свое выступление на конференции VB Transform 2026 в очках Ray-Ban Meta AI — наглядном свидетельство того, как глубоко ИИ уже проник в нашу физическую жизнь. Но его главный тезис пошел дальше: корпоративная инфраструктура строилась для людей, а не для ИИ-агентов, и теперь это несоответствие начинает давать о себе знать.
Ягур, возглавляющий подразделение данных и инфраструктуры компании, рассказал аудитории, что количество агентных запросов к системам данных Meta возросло в 30 раз всего за полгода. По его словам, это переворот, который разрушает базовые принципы, на создание которых компания потратила два десятилетия.
Этот сдвиг происходит не только в Meta. В прошлом году автоматизированный трафик на сайтах превзошел человеческий, достигнув 51% от общего объема, согласно отчету Imperva за 2025 год о вредоносных ботах. При этом объем такого трафика растет примерно в восемь раз быстрее человеческого, говорится в отчете HUMAN Security за 2026 год о состоянии ИИ-трафика. Ягур привел оба этих показателя, чтобы описать то, что он назвал точкой перегиба, которая уже наступила внутри его собственной компании.
Ягур обозначил этот сдвиг как открытый вопрос для инфраструктурных команд во всем мире. «Что происходит с инфраструктурой, которую мы годами строили, когда ее главными потребителями становятся агенты, а не люди? — задался вопросом Ягур. — Именно в таком мире мы сейчас и оказываемся».
Пропускная способность, идентификация и скорость дают сбой одновременно
По словам Ягура, внутри инфраструктуры Meta одновременно рушатся три базовые предпосылки: в отношении емкости (capacity), идентификации (identity) и скорости (velocity).
Что касается емкости, математика больше не работает так, как привыкли инженерные команды. «Раньше один инженер означал одну единицу нагрузки, — пояснил он. — Теперь один инженер порождает 10 агентов, каждый из которых порождает субагентов. Ваша организация из 1000 человек может практически за ночь создать нагрузку, эквивалентную 100 000 пользователей».
Его решение заключается не в том, чтобы блокировать агентный трафик, а в том, чтобы сделать инфраструктуру «агентно-осведомленной» (agent-aware). Для этого нужны динамические средства контроля, понимающие иерархию агентов, атрибуция затрат, отслеживающая потребление ресурсов вплоть до конкретного сценария использования, который их породил, а также троттлинг, адаптирующийся в зависимости от приоритетов.
Идентификация тоже трещит по швам. Ягур отметил, что агент не вписывается в категории, вокруг которых инфраструктурные команды выстраивали контроль доступа. Он не является человеческим пользователем, у него нет бейджа, и он не является традиционно развернутым сервисом, однако он принимает решения самостоятельно.
Скорость — это третья концепция, находящаяся под угрозой. Ягур привел внутрикорпоративную статистику: GitHub Copilot пишет 46% кода для среднестатистического пользователя, но тут же заметил, что более быстрое написание кода не ускоряет остальной пайплайн разработки.
«Этот код все равно нужно собрать, протестировать, развернуть и отслеживать, — сказал он. — Агент пишет код за считанные секунды, но ваш CI/CD-пайплайн не начинает работать быстрее только потому, что автором выступает машина».
Надежные среды данных удерживают агентов в рамках дозволенного
Данные, по словам Ягура, — это та сфера, где давление со стороны агентов ощущается наиболее остро.
«Данные находятся в центре всего», — заявил он, указав на решения, продукты, рекомендательные системы и модели нового поколения, которые они питают.
Meta также переосмысливает уровень автономии, предоставляемый агентам в собственных системах данных. В феврале компания выпустила то, что Ягур назвал агентными приложениями для работы с данными (agentic data apps). Всего за три месяца 63% информационных панелей (дашбордов), опубликованных в Meta, были созданы с использованием новых инструментов — это часть того самого 30-кратного роста агентных запросов, о котором Ягур упоминал ранее.
Такой рост порождает проблему управления. Традиционно между «сырыми» данными и бизнес-решениями стояли аналитики-люди, которые курировали информацию и служили неофициальным фильтром качества. Ягур отметил, что Meta стремится предоставить агентам больше самостоятельности в решении сложных задач, но прямо говорит о связанных с этим рисках.
«Автономия без управления — это чистый хаос», — подчеркнул он. Именно поэтому компания создала так называемые доверенные среды данных (trusted data environments), призванные сохранить человеческий контроль по мере того, как агенты берут на себя все большую часть этой работы.
«Внутри такой среды агент может свободно исследовать данные, но каждый результат прослеживается до источника и тщательно проверяется. Таким образом, вы всегда уверены, что возвращаемые данные заслуживают доверия и находятся под контролем», — пояснил Ягур.
Конфиденциальные поля маскируются до того, как к ним получит доступ агент, а каждый запрос на доступ оценивается в реальном времени: что именно пытается получить агент, зачем и разрешено ли ему это. Ягур резмировал этот подход следующим образом: исследовать широко, а выдавать результаты точечно.
Модели рассуждения переписывают уровень данных
Модели Meta также предъявляют все более высокие требования к данным по мере перехода от корреляции к рассуждениям (reasoning).
«Рассуждения требуют огромного количества данных», — сказал Ягур.
Сопоставление паттернов работает с редкими, суммарными сигналами. Рассуждения же требуют полной истории поведения — каждого взаимодействия на любой поверхности с течением времени. Ягур указал на два сдвига, которые уже происходят внутри инфраструктуры Meta для поддержания этого темпа.
Потоковая передача в реальном времени приходит на смену пакетной обработке (ETL) для систем ранжирования. Конвейер обработки данных, занимающий 24 часа, нежизнеспособен, когда модель должна рассуждать о текущем намерении пользователя. Ягур отметил, что потоковая передача в реальном времени, а не пакетная обработка ETL (извлечение, преобразование, загрузка), становится основой систем ранжирования и рекомендаций Meta.
Хранилища данных учатся понимать свою структуру, чтобы положить конец «голоданию» графических процессоров (GPU). Раньше Meta хранила пользовательские данные в виде непрозрачных блоков (blob) без понимания того, что именно они содержат, что, по словам Ягура, приводило к избыточной выборке данных и простоям мощностей GPU. Теперь компания создает хранилища, которые понимают свое содержимое, извлекая только те столбцы и временные интервалы, которые необходимы для конкретного запроса. По словам Ягура, Meta движется к показателю в 500 миллионов запросов в секунду и пропускной способности в один петабайт в секунду для чтения тренировочных данных.
Эти данные напрямую влияют на работу рекомендательных систем Meta. Ягур сообщил, что 42% пользователей Instagram заявили компании о желании кардинально изменить алгоритм, а не просто скорректировать одну сессию или настройку. Ответом Meta стали полностью диалоговые рекомендации (fully conversational recommendations), когда пользователь говорит системе, чего он хочет больше, а алгоритм оценивает намерения, а не просто сопоставляет ключевые слова. Ягур отметил, что один и тот же поисковый запрос «футбол» выдаст разные результаты для случайного болельщика, ищущего яркие моменты матчей, и для клубного спортсмена, ищущего тренировочные упражнения, поскольку система поймет контекст и определит, кто именно задает вопрос.
Ягур охарактеризовал три основные темы своего выступления — агенты, данные и рекомендации — как взаимодополняющие элементы, а не изолированные процессы.
«Агенты делают данные более доступными. Лучшие данные порождают рассуждения. Рассуждения создают новые требования, которые продвигают вперед агентов и инфраструктуру, — сказал он. — Это не линейный процесс, это маховик».
В ходе сессии вопросов и ответов один из участников спросил, означает ли стремление Meta к более интеллектуальной инфраструктуре конец традиционных файловых систем в пользу новых нейросетевых подходов к хранению данных, и будут ли агенты продолжать использовать SQL в качестве интерфейса для работы с данными так же, как это делают люди. Ягур ответил, что Meta экспериментирует на всех уровнях, в том числе ставит под сомнение целесообразность использования SQL как интерфейса для агентов в принципе, а объемы хранения данных в компании уже исчисляются десятками эксабайт и требуют дальнейшего расширения.
Ягур завершил свое выступление временными рамками, в которых, по его мнению, приходится работать всей индустрии. «Мы потратили 20 лет на создание инфраструктуры для людей. У нас есть, пожалуй, 20 месяцев на то, чтобы перестроить ее целиком для мира, где люди и агенты совместно творят в массовом масштабе, — резюмировал Ягур. — Окно возможностей открыто, но оно не останется открытым долго».




