


Redis выяснила, что настройка RAG ухудшает качество извлечения данных
Источник: VentureBeat · Sean Michael Kerner


Корпоративные команды, которые выполняют тонкую настройку своих моделей внедрения RAG (генерации с дополненным извлечением) для повышения точности, могут непреднамеренно ухудшать качество извлечения данных, от которого зависят эти конвейеры, согласно новому исследованию компании Redis.
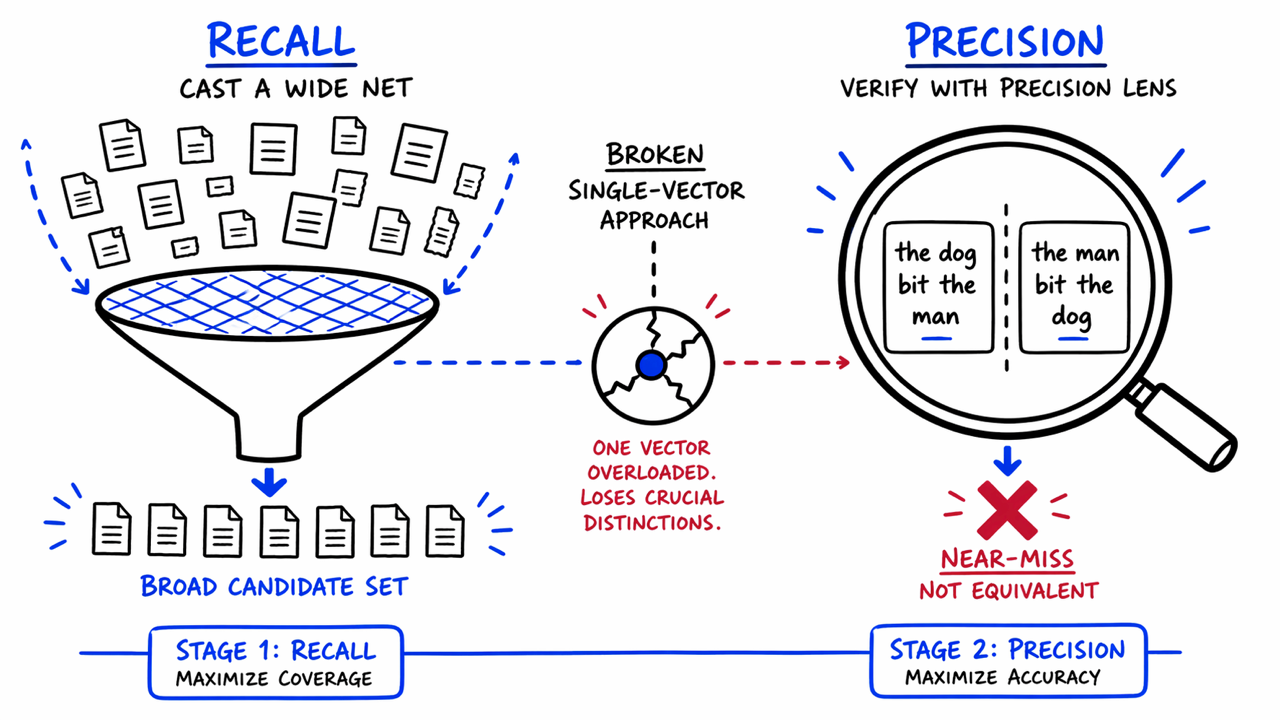
В исследовании «Training for Compositional Sensitivity Reduces Dense Retrieval Generalization» («Обучение на композиционную чувствительность снижает обобщающую способность плотного извлечения») проверялось, что происходит, когда команды обучают модели внедрения на композиционную чувствительность. То есть способность улавливать предложения, которые выглядят практически одинаково, но имеют разный смысл — например, «собака укусила человека» против «человек укусил собаку», или изменение отрицания, которое полностью меняет смысл высказывания. Такое обучение неизменно разрушало обобщающую способность плотного извлечения — то, насколько хорошо модель правильно извлекает данные по широкому кругу тем и доменов, для которых она специально не обучалась. Производительность падала на 8–9% на более мелких моделях и на 40% на актуальной модели внедрения среднего размера, которую команды активно используют в продакшене.
Полученные результаты имеют прямые последствия для корпоративных команд, создающих агентские конвейеры ИИ, где качество извлечения определяет, какой контекст попадает в цепочку рассуждений агента. Ошибка извлечения в одноэтапном конвейере приводит к неверному ответу. Та же ошибка в агентском конвейере может вызвать каскад неверных действий на последующих этапах.
Шриджит Раджамохан (Srijith Rajamohan), руководитель исследований в области ИИ в Redis и один из авторов работы, отметил, что это открытие ставит под сомнение распространенное предположение о том, как на самом деле работает извлечение на основе внедрения.
«Существует общее представление, что при использовании семантического поиска или аналогичного семантического сходства мы получаем правильное намерение. Это не обязательно так», — рассказал Раджамохан изданию VentureBeat. — «Близкое или высокое семантическое сходство на самом деле не означает точное намерение».
Геометрия, лежащая в основе компромисса при извлечении
Модели внедрения работают путем сжатия всего предложения в одну точку в многомерном пространстве с последующим поиском точек, наиболее близких к запросу во время извлечения. Это хорошо работает для широкого тематического сопоставления: документы на схожие темы оказываются рядом друг с другом. Проблема заключается в том, что два предложения с практически одинаковыми словами, но противоположным значением также оказываются близко друг к другу, поскольку модель работает со словарным составом, а не со структурой.
Именно это и было количественно оценено в исследовании. Когда команды дорабатывают модель внедрения, чтобы разнести структурно разные предложения дальше друг от друга (обучая ее тому, что изменение отрицания, меняющее смысл высказывания на противоположное, не то же самое, что оригинал), модель использует репрезентативное пространство, которое раньше использовалось для широкого тематического поиска. Две цели борются за один и тот же вектор.
Исследование также показало, что регрессия неравномерна для разных типов сбоев. Ошибки отрицания и пространственной перестановки заметно улучшились благодаря структурированному обучению. Ошибки привязки (когда модель путает, к какому слову относится какой модификатор, например, на какую сторону ложится обязательство по контракту) практически не сдвинулись с места. Для корпоративных команд это означает, что проблему точности сложнее решить именно в тех случаях, когда ошибки имеют наибольшие последствия.
Причина, по которой большинство команд не замечают этого, заключается в том, что метрики тонкой настройки измеряют задачу, для которой проводится обучение, а не то, что происходит с общим извлечением по несвязанным темам. Модель может демонстрировать значительное улучшение в отклонении ложных срабатываний во время обучения, незаметно деградируя в более широкой задаче извлечения, для которой она была нанята. Регрессия проявляется только в продакшене.
Раджамохан отметил, что интуитивное стремление большинства команд — переход к более крупной модели внедрения — не решает проблему базовой архитектуры.
«Этого нельзя достичь за счет масштабирования», — сказал он. — «Эту проблему нельзя решить с помощью большего числа измерений и параметров».
Почему стандартные альтернативы не работают
Естественная реакция при снижении точности извлечения — наслоение дополнительных подходов. Исследование протестировало несколько из них и обнаружило, что каждый из них дает сбой по-своему.
Гибридный поиск. Сочетание извлечения на основе внедрения с ключевым словом уже стало стандартной практикой для устранения пробелов в точности. Но Раджамохан отметил, что поиск по ключевым словам не может обнаружить тип сбоя, выявляемый данным исследованием, поскольку проблема заключается не в пропущенных словах, а в неправильно истолкованной структуре.
«Если у вас есть предложение вроде „Рим ближе, чем Париж“, а другое говорит „Париж ближе, чем Рим“, и вы выполняете извлечение на основе внедрения с последующим текстовым поиском, вы не сможете заметить разницу», — сказал он. — «В обоих предложениях используются одни и те же слова».
Ранжирование MaxSim. Некоторые команды добавляют второй слой оценки, который сравнивает отдельные слова запроса со словами документа, а не полагается на единый сжатый вектор. Этот подход, известный как MaxSim или позднее взаимодействие (late interaction), используемый в таких системах, как ColBERT, действительно улучшил показатели релевантности в ходе исследования. Однако он полностью не справился с отклонением структурных ложных срабатываний, присваивая им оценки сходства, близкие к тождественным.
Проблема в том, что релевантность и идентичность — это разные цели. MaxSim оптимизирован для первого и слеп ко второму. Команда, которая добавляет MaxSim и видит улучшение показателей, возможно, решает совсем не ту проблему, которая у нее есть.
Кросс-энкодеры. Они работают путем одновременной подачи запроса и документа-кандидата в модель, позволяя ей сравнивать каждое слово с каждым словом перед принятием решения. Именно такое полное сравнение делает их точными — и слишком дорогими для запуска в масштабах продакшена. Раджамохан сообщил, что его команда изучала их. Они работают в лаборатории и ломаются при реальных объемах запросов.
Контекстная память. Эти системы, иногда называемые агентской памятью, все чаще упоминаются как путь развития за рамки RAG, но Раджамохан отметил, что переход на архитектуру такого типа не устраняет проблему структурного извлечения. Эти системы по-прежнему зависят от извлечения во время запроса, что означает применимость тех же режимов сбоев. Главное отличие заключается в более мягких требованиях к задержке, а не в решении проблемы точности.
Двухэтапное решение, подтвержденное исследованием
Общая черта всех неудачных подходов едина: единый механизм оценки пытается одновременно обрабатывать как полноту (recall), так и точность (precision). Исследование подтвердило иную архитектуру: прекратить попытки выполнять обе задачи с помощью одного вектора и закрепить каждую задачу за выделенным этапом.
Этап первый: полнота. Первый этап работает точно так же, как и стандартное плотное извлечение сегодня — модель внедрения сжимает документы в векторы и извлекает наиболее близкие к запросу совпадения. Здесь ничего не меняется. Цель состоит в том, чтобы закинуть широкую сеть и быстро вернуть набор сильных кандидатов. На этом этапе важны скорость и охват, а не идеальная точность.
Этап второй: точность. Второй этап — это место, где кроется решение. Вместо оценки кандидатов с помощью одного числа сходства, небольшая обученная модель Transformer изучает запрос и каждого кандидата на уровне токенов — сравнивая отдельные слова со словами для обнаружения структурных несоответствий, таких как изменение отрицания или перестановка ролей. Это шаг верификации, который одновекторный подход выполнить не может.
Результаты. При сквозном обучении верификатор Transformer превзошел все остальные подходы, протестированные в ходе исследования, по отсеиванию структурных ложных срабатываний. Это был единственный подход, который надежно улавливал режимы сбоев, пропущенные одновекторной системой.
Компромисс. Добавление этапа верификации увеличивает задержку (latency). Затраты времени зависят от того, насколько глубокую верификацию проводит команда. Для рабочих нагрузок, чувствительных к точности, таких как юридические или бухгалтерские приложения, оправдана полная верификация при каждом запросе. Для общего поиска может быть достаточно более легкой верификации.
Исследование выросло из реальной производственной проблемы. Корпоративные клиенты, использующие системы семантического кэширования, получали быстрые, но семантически неверные ответы — система извлечения обрабатывала запросы с похожим звучанием как идентичные, даже когда их смысл различался. Двухэтапная архитектура — это предложенное Redis решение, внедрение которого в продукт LangCache запланировано, но пока еще недоступно клиентам.
Что это значит для корпоративных команд
Исследование не требует от корпоративных команд перестраивать свои конвейеры извлечения с нуля. Но оно призывает их провести стресс-тестирование предположений, которые большинство команд никогда не проверяли — относительно того, что на самом деле делают их модели внедрения, каким метрикам стоит доверять и где в продакшене кроются реальные пробелы в точности.
Осознайте компромисс до настройки. Раджамохан отметил, что первым практическим шагом является понимание существования регрессии. Он оценивает любую систему извлечения на базе LLM по трем критериям: правильность, полнота и полезность. Ошибки правильности каскадно переходят на два других, а это означает, что система извлечения, которая набирает высокие баллы по бенчмаркам релевантности, но дает сбои на структурных ложных срабатываниях, создает ложное чувство готовности к продакшену.
RAG не устарел, но знайте его ограничения. Раджамохан решительно опроверг заявления о том, что RAG устарел. «Это колоссальное упрощение», — сказал он. — «RAG — это очень простой конвейер, который может быть внедрен в продакшен практически кем угодно с минимальными усилиями». Исследование не выступает против RAG как архитектуры. Оно выступает против предположения, что одноэтапный конвейер RAG с тонко настроенной моделью внедрения готов к продакшену для рабочих нагрузок, чувствительных к точности.
Решение реально, но не бесплатно. По словам Раджамохана, для команд, которым действительно требуется более высокая точность, двухэтапная архитектура не является непосильной задачей для реализации, однако добавление этапа верификации влечет за собой издержки по задержке. «Это проблема минимизации последствий», — сказал он. — «А не то, что мы можем реально решить».




