


OCR 4 от Mistral AI повышает уровень интеллектуальной обработки документов
Источник: VentureBeat · Michael Nuñez


Mistral AI во вторник выпустила OCR 4 — модель интеллектуального анализа документов, которая выходит за рамки простого извлечения текста и выдает структурированные представления целых документов, включая ограничивающие рамки (bounding boxes), классификацию типов блоков и оценки достоверности для каждого слова. Этот релиз стал четвертым поколением технологии оптического распознавания символов от Mistral примерно за 15 месяцев и появился в момент, когда идея европейского суверенитета в сфере ИИ важна для коммерции как никогда ранее.
Модель поддерживает 170 языков в составе 10 языковых групп, принимает форматы PDF, DOC, PPT и OpenDocument, а также может развертываться в виде единого контейнера на собственной инфраструктуре организации. Эту возможность Mistral позиционирует как решение для предприятий из регулируемых отраслей, которые не могут передавать конфиденциальные документы через облачные API под юрисдикцией США.
«Mistral OCR 4 извлекает и структурирует контент из самых разных документов, — заявила компания в своем анонсе. — Если предыдущие поколения были сосредоточены на преобразовании страницы в чистый текст и таблицы, то OCR 4 возвращает структурированное представление документа».
Модель доступна незамедлительно через Mistral API, Document AI в Mistral Studio, Amazon SageMaker и Microsoft Foundry, а поддержка Snowflake Parse Document появится в ближайшее время. Цены начинаются с $4 за 1000 страниц и снижаются до $2 за 1000 страниц при использовании скидки для пакетного API.
OCR 4 рассматривает каждый документ как семантическую карту, а не как стену текста
Главный инженерный сдвиг в OCR 4 носит структурный характер. Вместо вывода плоского потока извлеченного текста — парадигмы, которая определяла OCR на протяжении десятилетий, — модель возвращает многоуровневое представление, в котором каждый блок локализован с помощью ограничивающей рамки, классифицирован по типу (заголовок, таблица, уравнение, подпись и другие), а также имеет оценку достоверности как на уровне страниц, так и на уровне слов.
В Mistral говорят, что ограничивающие рамки были самой запрашиваемой функцией. Причина проста: без данных о местоположении нисходящие системы не могут проследить извлеченный факт до его источника на конкретной странице. Этот пробел в отслеживании был постоянной точкой трения для компаний, создающих конвейеры генерации с дополненной выборкой (RAG), рабочие процессы соответствия требованиям (compliance) или любые приложения, где «откуда взялось это число?» является вопросом, требующим аудируемого ответа.
Классификация блоков решает сопутствующую проблему. Абзац, помеченный как «заголовок», может разделить документ на иерархические фрагменты для семантического поиска. Блок, помеченный как «таблица», может быть направлен в конвейер структурированных данных, а не в суммаризатор текста. Блок, помеченный как «подпись», может запустить рабочий процесс редактирования в системе комплаенса.
Сами по себе эти идеи не новы, но их объединение в качестве первоклассных результатов работы самой модели OCR (без необходимости прохождения отдельного этапа анализа макета) устраняет уровень интеграции, который корпоративным командам исторически приходилось строить и поддерживать самостоятельно.
Оценки достоверности служат двойной цели. В больших масштабах они позволяют организациям программно направлять области с низкой достоверностью на проверку людям и автоматически одобрять извлеченные данные с высокой достоверностью, создавая то, что в отрасли называют проверкой с участием человека в контуре (human-in-the-loop), без необходимости проверять каждую страницу каждого документа вручную. В производственных системах OCR редко является конечной целью — это первый шаг в более крупном конвейере.
Разработчики, создающие системы RAG, рабочие процессы агентов или средства автоматизации работы с документами, часто тратят больше времени на реконструкцию макета и структуры, чем на саму логику ИИ нижнего уровня. OCR 4 призвана исключить этот шаг реконструкции, и если она оправдает это обещание, выгода будет заключаться не только в экономии средств на OCR, но и в сокращении рабочего времени инженеров во всем конвейере обработки документов.
Независимые рецензенты отдавали предпочтение выводу Mistral в 72 процентах случаев, но бенчмарки рассказывают сложную историю
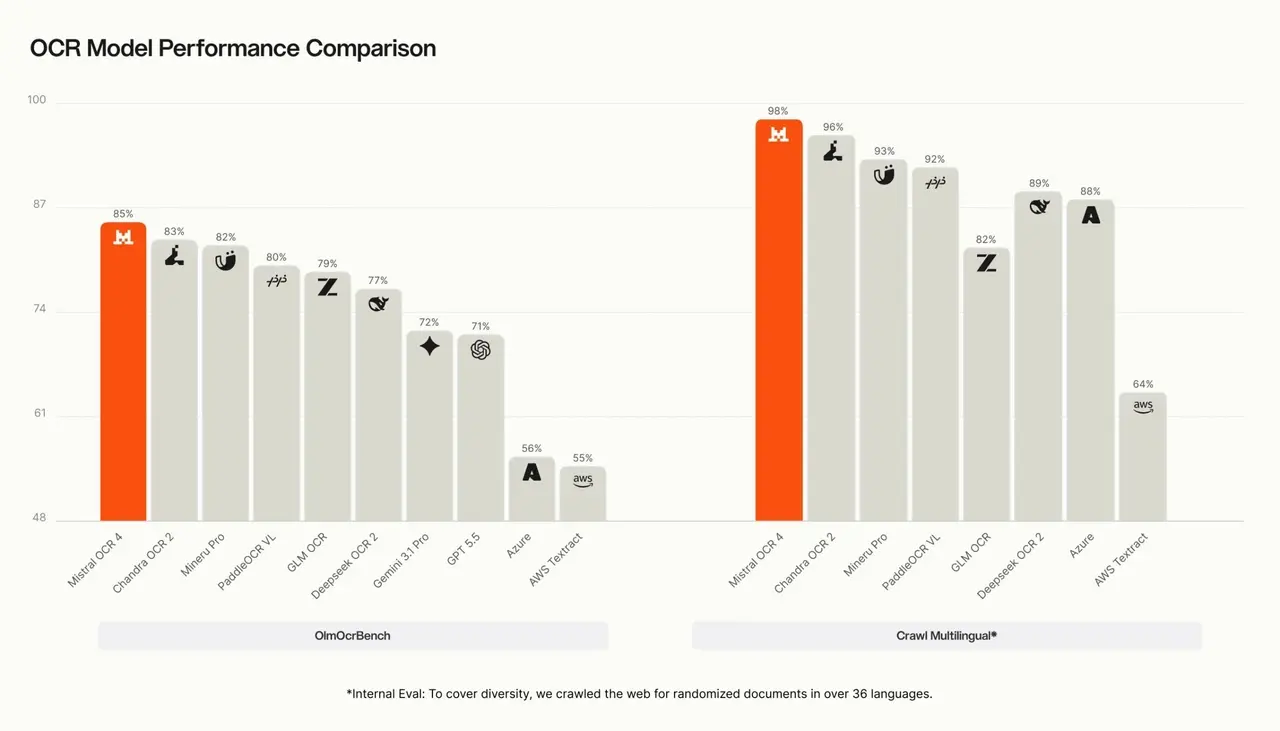
Mistral сообщает, что OCR 4 достигла среднего показателя побед в 72% при прямом сравнении с ведущими конкурентами в ходе оценки людьми, проведенной независимыми аннотаторами на более чем 600 реальных документах на более чем 12 языках. Модель также получила наивысший общий балл на OlmOCRBench (85,20) и набрала 93,07 балла на OmniDocBench.
Но сама компания призывает с осторожностью относиться к интерпретации этих цифр. В своем релизе Mistral предприняла необычный шаг: провела аудит и публично раскрыла конкретные типы артефактов оценки, с которыми столкнулась, включая ошибки «истинной разметки» (ground truth) в справочных аннотациях, эквивалентную нотацию LaTeX, засчитанную как несовпадения, предположения о порядке чтения колонок и проблемы с атрибуцией колонтитулов. «Поэтому мы рассматриваем совокупный балл как ориентировочный, а не окончательный», — заявила компания, что демонстрирует заметно прозрачную позицию для вендора, объявляющего о новом продукте.
Эта прозрачность как нельзя кстати. В публичной таблице лидеров OlmOCRBench некоторые исследователи отметили, что OCR 4 в настоящее время занимает третье место, уступая открытым моделям, таким как Chandra OCR 2. А некоторые модели с открытыми весами сообщают о более высоких совокупных баллах OmniDocBench — PaddleOCR-VL-1.6 заявляет о 96,33 балла, — хотя эти результаты не были независимо воспроизведены в публичной таблице лидеров.
Тем не менее, первые отзывы предприятий оказались благоприятными. Эйдан Донохью (Aidan Donohue), инженер по искусственному интеллекту в финансовой ИИ-фирме Rogo, сообщил, что компания протестировала OCR 4 на фоне ведущих агентских парсеров документов на датасете финансовых вопросов и ответов с плотным расположением графиков и «достигла эквивалентной точности при примерно в 8 раз более низкой стоимости и в 17 раз меньшей задержке». Иван Михайлов, инженер по искусственному интеллекту в компании по управлению интеллектуальной собственностью Anaqua, отметил, что OCR 4 работает «примерно в 4 раза быстрее на страницу, чем наш действующий провайдер».
Тем не менее, корпоративным покупателям следует проводить собственные оценки, а не полагаться на бенчмарки какого-либо вендора. Практический вопрос заключается не в том, какая модель набирает больше всего баллов в таблице лидеров, а в том, какая модель производит меньше всего ошибок на ваших конкретных документах, на ваших конкретных языках, по цене и с задержкой, которые подходят под ваш рабочий процесс.
Собственные бенчмарки Mistral показывают, что OCR 4 лидирует в сфере по двум показателям точности извлечения, хотя независимые таблицы лидеров рисуют более нюансированную картину. (Источник: Mistral AI)
Запрет на экспорт от Anthropic дал питчу Mistral о суверенитете именно то подтверждение, которое было нужно
Релиз Mistral состоялся в геополитическом контексте, который едва ли мог быть более благоприятным для ее стратегического позиционирования.
12 июня компания Anthropic была вынуждена отключить любой доступ к своим новейшим ИИ-моделям Fable 5 и Mythos 5 после того, как Министерство торговли США применило экспортный контроль по соображениям национальной безопасности, запретив компании распространять модели среди любых иностранных граждан. Корпоративные клиенты в сфере финансов, здравоохранения, SaaS и критической инфраструктуры обнаружили, что их ключевые интеллектуальные службы внезапно отключены без предварительного предупреждения и эффективных средств правовой защиты. По состоянию на 24 июня обе модели остаются оффлайн, а рынки прогнозов дают лишь 57% вероятности их восстановления до 1 июля.
Этот эпизод подтвердил предупреждение, которое генеральный директор Mistral Артур Менш (Arthur Mensch) озвучивал уже больше года. Как сообщал Business Insider, Менш предупреждал на лондонской неделе технологий London Tech Week в июне 2025 года об американских ИИ-компаниях, «удерживающих ключи» от своих моделей, назвав это сценарием, при котором европейские компании «отдают рычаги влияния своим провайдерам». Он добавил: «В какой-то момент вам нужно иметь возможность выключить или включить это устройство, и вы не захотите оставлять это на усмотрение другой страны».
Этот аргумент приобрел еще большую актуальность по мере того, как в последние месяцы усиливался более широкий тезис Менша о суверенитете. Как сообщал CNBC в конце мая, Менш заявил изданию: «Европа отстает в плане развития инфраструктуры, и поэтому мы инвестируем средства, чтобы сократить этот разрыв».
В то же время Менш выступил против призыва Папы Римского Льва XIV «разоружить» ИИ, утверждая, что Европа не может позволить себе отстать от технологических гигантов США. «Мы выступаем за мир, но если вы посмотрите на наших соперников и противников в мире, они используют искусственный интеллект… нам действительно нужно иметь собственные возможности», — сказал Менш журналистам.
Модель развертывания OCR 4 в виде единого контейнера и с размещением на собственной инфраструктуре — это продуктовое воплощение данного аргумента. Провайдер со штаб-квартирой в США, предлагающий размещение данных в ЕС, означает, что документы хранятся во Франкфурте, но регулируются законами США. Mistral, зарегистрированная во Франции и работающая под юрисдикцией ЕС, предлагающая контейнеризированное развертывание on-premise, означает, что документы вообще не покидают инфраструктуру клиента. Положения Закона об искусственном интеллекте ЕС (EU AI Act) о штрафах вступают в силу 2 августа, что усиливает регуляторное давление при расчете комплаенса для европейских предприятий, оценивающих поставщиков систем документного ИИ.
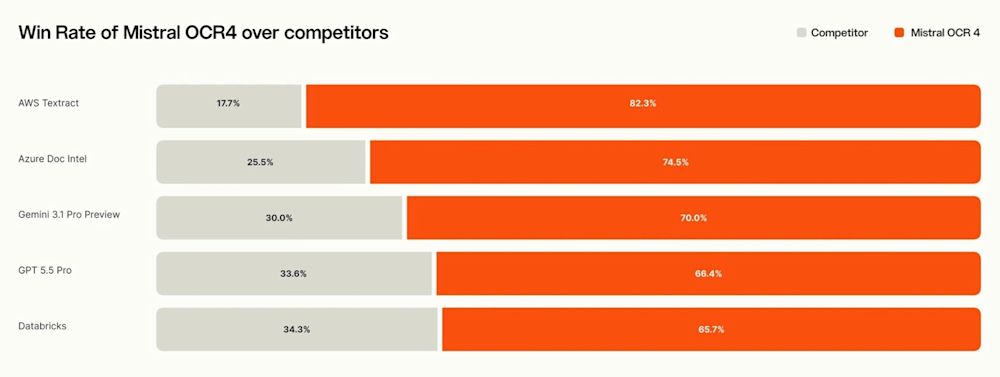
В ходе слепых оценок людьми по более чем 600 документам независимые аннотаторы отдавали предпочтение выводу Mistral примерно в двух третях-четырех пятых случаев. (Источник: Mistral AI)
Бесплатная модель OCR с открытыми весами от Baidu появилась на день раньше — и это контраст весьма показателен
Релиз Mistral не был единичным событием. Всего за день до запуска OCR 4 компания Baidu 22 июня выпустила Unlimited-OCR — модель с 3 миллиардами параметров под лицензией MIT, которая решает одну из самых упорных проблем документного ИИ: синтаксический анализ целых PDF-файлов и многостраничных сканов за один прямой проход (forward pass) без разбиения входных данных на части или последующей сшивки вывода.
Модель Baidu использует технику под названием Reference Sliding Window Attention (R-SWA), которая, как объяснил топ-комментатор на Hacker News, разделяет фокус ИИ на два пути: сохранение полного внимания к оригинальному изображению документа при ограничении памяти сгенерированного текста жестким скользящим окном. Результатом является постоянный размер KV-кэша и возможность транскрибировать более 40 страниц за один прямой проход. Модель набрала 1800 звезд на GitHub за первые 24 часа и получила более 479 голосов (upvotes) на Hacker News, где ветка обсуждения насчитывала 109 комментариев.
Эти два релиза очерчивают то, что некоторые аналитики называют расколом в сфере документного ИИ в июне 2026 года: хостируемый синтаксический анализ на большой протяженности с открытыми весами против структурированного управляемого извлечения с корпоративными функциями.
Модель Baidu бесплатна по лицензии MIT, работает на стандартном оборудовании GPU и не имеет управляемого API или корпоративного SLA. Модель Mistral — это коммерческий продукт с ценообразованием за страницу, ограничивающими рамками, оценками достоверности, классификацией блоков, многоплатформенным распространением и возможностями развертывания на собственных серверах для корпоративных клиентов.
Unlimited-OCR может оказаться лучшим инструментом для исследовательской группы, оцифровывающей сканы диссертаций на одном GPU. OCR 4 создана для процесса закупок в ИТ — мира соглашений об уровне обслуживания (SLA), соглашений об обработке данных и аудитов соответствия.
Помимо Baidu, более широкое конкурентное поле OCR включает Google Document AI, Amazon Textract, Azure Document Intelligence, ABBYY Vantage и растущее число моделей с открытыми весами.
В ветке обсуждения Unlimited-OCR на Hacker News практики дали откровенную оценку текущему состоянию технологий. Joss82, занимающийся синтаксическим анализом документов в течение 10 лет, написал прямо: «OCR в 2026 году по-прежнему отстой». Между тем, пользователь по имени SyneRyder сообщил об успешном опыте использования Claude для OCR сотен страниц рукописных документов, отметив, что модель выдала результаты «без необходимости внесения исправлений» и даже указала на ошибку непрерывности в исходном тексте. Эти отчеты практиков подчеркивают ключевое напряжение на рынке: производительность сильно варьируется в зависимости от конкретного типа документа, языка и качества исходного материала.
Настоящая игра — это не OCR, а корпоративный стек ИИ с интеллектуальным анализом документов в качестве отправной точки
Если отойти на шаг назад, то релиз OCR 4 от Mistral — это на самом деле история не про OCR. Это история о выходе на корпоративный рынок, построенная поверх глобального рынка интеллектуальной обработки документов объемом $4,4 млрд, который, согласно прогнозам Grand View Research, будет расти со среднегодовым темпом роста (CAGR) в 33,1% до 2030 года.
Для Mistral технология OCR служит инструментом проникновения в корпоративные бюджеты на ИИ. Модель напрямую интегрируется в Search Toolkit — разработанный компанией компонуемый фреймворк поиска с открытым исходным кодом, анонсированный на саммите AI Now Summit. В этой архитектуре OCR 4 служит слоем приема (ingestion layer) для генерации с дополненной выборкой (RAG) и корпоративных поисковых конвейеров, превращая исходные документы в готовые к цитированию, структурно классифицированные входные данные. Логика ясна: как только предприятие принимает OCR 4 для извлечения данных из документов, более широкий набор моделей Mistral — включая Medium 3.5 для рассуждений и агентскую платформу Vibe для выполнения задач — становится естественным следующим шагом в стеке.
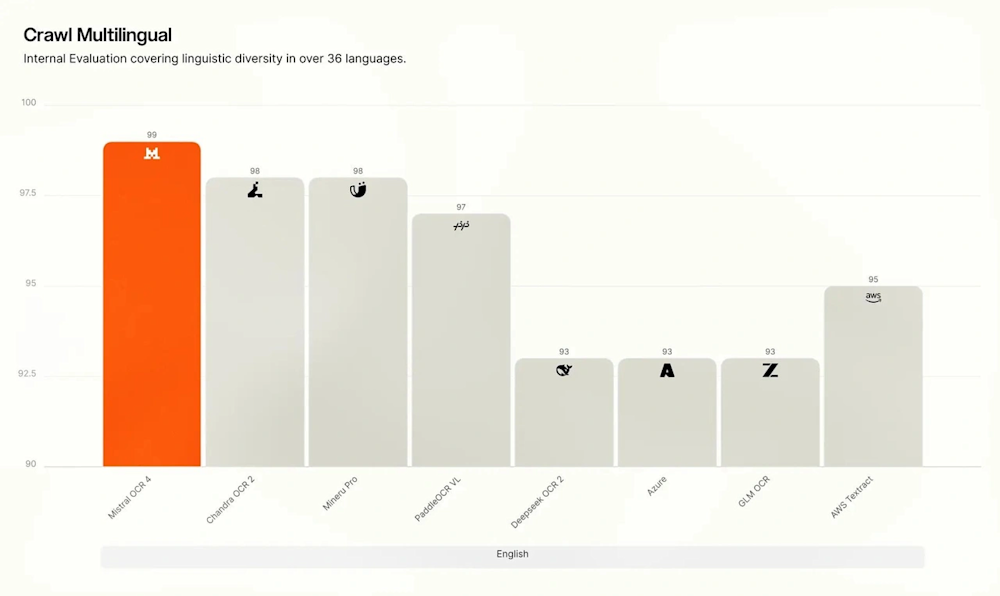
Только на англоязычных документах разрыв в производительности между ведущими моделями OCR сужается до всего лишь нескольких процентных пунктов, что говорит о том, что настоящая конкурентная борьба развернется вокруг многоязычной поддержки, структуры и цены. (Источник: Mistral AI)
Эти амбиции в отношении конвейеров являются критически важным контекстом для понимания текущей траектории привлечения финансирования Mistral. Недавно агентство Bloomberg сообщило, что компания ведет предварительные переговоры о <привлечении около €3 млрд ($3,5 млрд)> при оценке примерно в €20 млрд — что почти вдвое превышает оценку в €11,7 млрд по итогам сентябрьского раунда серии C. На сегодняшний день Mistral привлекла всего около $4 млрд, что составляет лишь малую часть того, что получили ее крупнейшие американские конкуренты. OCR 4 и связанный с ней конвейер корпоративной выручки — это часть плана компании по обоснованию этой более высокой оценки, причем Mistral рассчитывает на €1 млрд выручки в 2026 году по сравнению с €200 млн в 2025 году, согласно изданию Le Monde.
Mistral — это компания с примерно 1 000 сотрудников и амбициями конкурировать с лабораториями, привлекшими в 40 раз больше капитала. Она не может выиграть гонку вооружений моделей общего назначения против OpenAI и Anthropic. Что она может сделать, так это построить дифференцированный корпоративный стек вокруг суверенитета, структурированного интеллекта документов и агентских рабочих процессов — и использовать этот стек для захвата бюджетов европейских предприятий, которые все с большим подозрением относятся к зависимости от американских провайдеров.
Ценовая структура подкрепляет эту стратегию: при цене $2 за 1000 страниц в пакетном режиме стоимость обработки корпоративного архива объемом 100 000 страниц снижается до $200, что делает крупномасштабные проекты по оцифровке экономически целесообразными так, как это не всегда было возможно при ценообразовании моделей «зрение-язык» (VLM) на основе токенов.
Сможет ли Mistral реализовать это видение в масштабе — в противостоянии с Google, Amazon, Microsoft и набирающей обороты экосистемой с открытым исходным кодом — остается открытым вопросом. Но кризис экспортного контроля Anthropic до сих пор не разрешен, европейские правила суверенитета данных ужесточаются, а на горизонте маячит потенциальный раунд финансирования в €20 млрд. Компания проводит вебинар, посвященный продакшену OCR 4, 7 июля в 18:00 по центральноевропейскому времени (CET).
Две недели назад аргументы в пользу создания инфраструктуры ИИ вне досягаемости экспортного контроля США носили теоретический характер. Затем правительство США щелкнуло выключателем, и самые передовые модели Anthropic погасли для каждого неамериканца на планете. Mistral не стала причиной этого кризиса, но она провела последний год, создавая продукт, который делает этот факт столь значимым.




