


Databricks протестировала более мощную модель на гибридных запросах против своего многошагового агента. Более мощная модель все равно проиграла на 21%.
Источник: VentureBeat · Sean Michael Kerner


Команды разработчиков данных, создающие ИИ-агентов, постоянно сталкиваются с одной и той же проблемой. Вопросы, требующие объединения структурированных данных с неструктурированным контентом — например, показателей продаж с отзывами клиентов или количества цитирований с академическими статьями — выводят из строя системы RAG (поисково-дополненной генерации) с одним этапом запроса.
Новое исследование компании Databricks дает количественную оценку этому разрыву в производительности. Согласно исследованию, исследовательская группа компании по искусственному интеллекту проверила многошаговый подход на основе агентов в сравнении с передовыми базовыми моделями одношагового RAG на девяти корпоративных задачах на знание и зафиксировала прирост в 20% и более на бенчмарке STaRK от Стэнфордского университета, а также стабильное улучшение в рамках собственной системы оценки KARLBench от Databricks. Databricks утверждает, что разница в производительности между одношаговым RAG и многошаговыми агентами при работе с гибридными данными является архитектурной проблемой, а не проблемой качества моделей.
Эта работа опирается на предыдущее исследование Databricks, посвященное инструктированному поисковику, которое продемонстрировало улучшение поиска по неструктурированным данным с использованием запросов с учетом метаданных. Последнее исследование добавляет в тот же цикл рассуждений структурированные источники данных, реляционные таблицы и хранилища SQL, решая класс задач, с которыми предприятия чаще всего не справляются при использовании текущих архитектур агентов.
«RAG работает, но он не масштабируется, — рассказал VentureBeat Майкл Бендерский (Michael Bendersky), директор по исследованиям в Databricks. — Если вы хотите сделать своего агента еще лучше и понять, почему у вас падают продажи, теперь вам нужно помочь агенту увидеть таблицы и изучить данные о продажах. Ваш конвейер RAG окажется некомпетентным в этой задаче».
Одношаговый поиск не может кодировать структурные ограничения
Главный вывод заключается в том, что стандартные системы RAG терпят неудачу, когда запрос сочетает точный структурированный фильтр с открытым семантическим поиском.
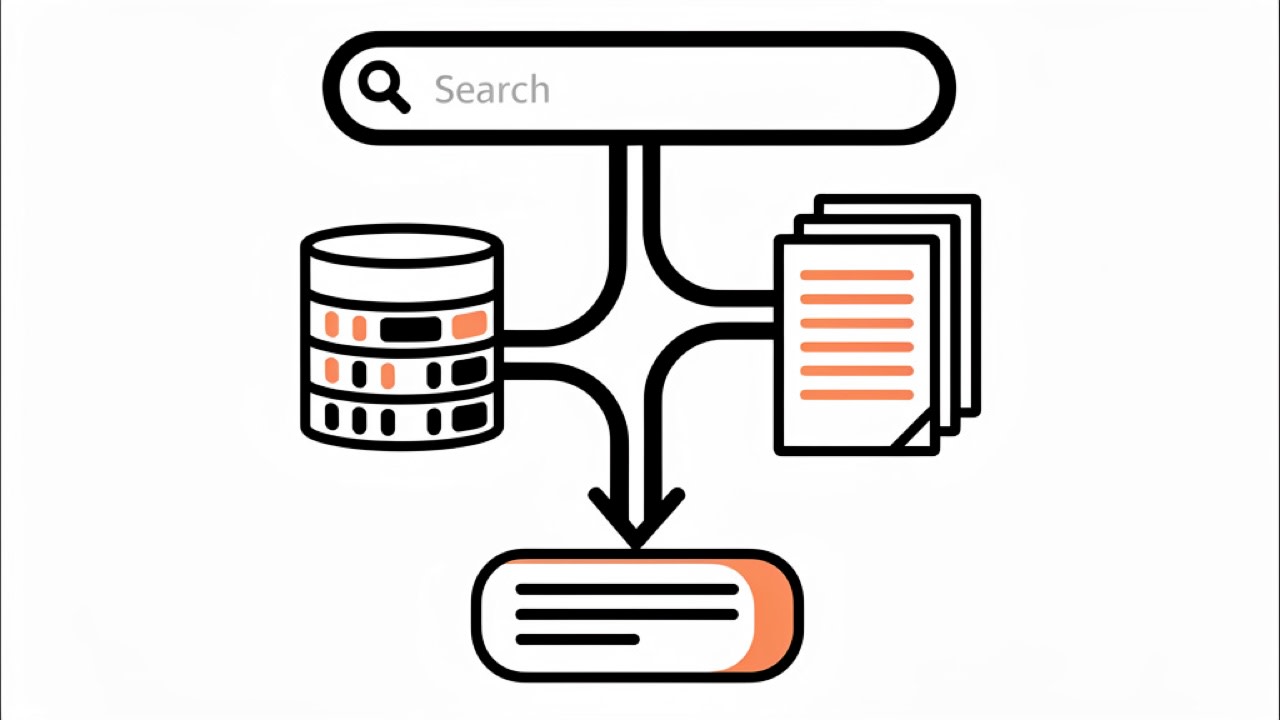
Рассмотрите такой вопрос: «Какие из наших продуктов продемонстрировали падение продаж за последние три месяца и какие потенциально связанные с этим проблемы поднимаются в отзывах клиентов на различных сайтах продавцов?» Данные о продажах хранятся в хранилище. Тональность отзывов содержится в неструктурированных документах на сайтах продавцов. Одношаговая система RAG не может разделить этот запрос, направить каждую половину в нужный источник данных и объединить результаты.
Чтобы подтвердить, что это архитектурная проблема, а не проблема качества моделей, в Databricks повторно зафиксировали опубликованные базовые показатели STaRK с использованием современной передовой базовой модели. Согласно исследованию, более мощная модель все равно проиграла многошаговому агенту на 21% в академическом домене и на 38% в биомедицинском домене.
STaRK — это бенчмарк, опубликованный исследователями из Стэнфорда, который охватывает три полуструктурированных домена поиска: данные о товарах Amazon, граф Microsoft Academic Graph и базу биомедицинских знаний.
Как агент-супервайзер справляется с тем, с чем не справляется RAG
Компания Databricks создала агента-супервайзера в качестве практической реализации этого исследовательского подхода, и его архитектура иллюстрирует, почему показатели прироста стабильны для различных типов задач. Этот подход включает в себя три основных этапа:
Параллельная декомпозиция инструментов. Вместо того чтобы отправлять один общий запрос и надеяться, что результаты покроют как структурированные, так и неструктурированные потребности, агент одновременно запускает вызовы SQL и векторного поиска, а затем анализирует комбинированные результаты, прежде чем решить, что делать дальше. Этот параллельный шаг позволяет ему обрабатывать запросы, выходящие за рамки типов данных, без предварительной нормализации данных.
Самокоррекция. Когда первоначальная попытка поиска заходит в тупик, агент обнаруживает сбой, переформулирует запрос и пробует другой путь. В задаче бенчмарка STaRK, требующей найти статью автора ровно с 115 предыдущими публикациями на определенную тему, агент сначала запрашивает SQL и векторный поиск параллельно. Когда два набора результатов не пересекаются, он адаптируется и выполняет SQL JOIN по обеим ограничениям, а затем вызывает систему векторного поиска для проверки результата перед возвратом ответа.
Декларативная конфигурация. Агент не настроен на какой-либо конкретный набор данных или задачу. Подключение его к новому источнику данных означает написание описания на обычном языке о том, что содержит этот источник и на какие вопросы он должен отвечать. Никакого пользовательского кода не требуется.
«Агент может выполнять такие действия, как декомпозиция вопроса на SQL-запрос и поисковый запрос «из коробки», — отметил Бендерский. — Он может объединять результаты SQL и RAG, рассуждать над этими результатами, делать последующие запросы, а затем рассуждать о том, был ли действительно найден окончательный ответ».
Речь идет не только о гибридном поиске
Различие, проводимое Databricks, заключается не в методе поиска, а в архитектуре.
«Мы практически не рассматриваем это как гибридный поиск, где вы комбинируете эмбеддинги и результаты поиска, или эмбеддинги и таблицы, — сказал он. — Мы рассматриваем это скорее как агента, у которого есть доступ к нескольким инструментам».
Практическое следствие такого подхода заключается в том, что добавление нового источника данных означает его подключение к агенту и написание описания содержимого. Агент осуществляет маршрутизацию и оркестрацию без дополнительного кода.
Пользовательские конвейеры RAG требуют преобразования данных в формат, который поисковая система может прочитать, обычно это текстовые фрагменты с эмбеддингами. SQL-таблицы должны быть «сплющены», JSON — нормализован. Каждый новый источник данных, добавляемый в конвейер, означает больше работы по конвертации. Исследование Databricks утверждает, что по мере роста корпоративных данных и появления новых типов источников это бремя делает пользовательские конвейеры все более непрактичными по сравнению с агентом, который запрашивает каждый источник в его родном формате.
«Просто приведите агента к данным, — сказал Бендерский. — Вы по сути даете агенту больше источников, и он научится использовать их довольно хорошо».
Что это значит для предприятий
Для специалистов по работе с данными, оценивающих целесообразность создания пользовательских конвейеров RAG или внедрения декларативного фреймворка агентов, исследование предлагает четкое направление: если задача включает в себя вопросы, охватывающие структурированные и неструктурированные данные, создание собственного поиска — более трудный путь. Исследование показало, что во всех протестированных задачах единственное, чем отличались развертывания, — это инструкции и описания инструментов. Все остальное агент взял на себя.
Практические ограничения реальны, но ими можно управлять. Подход хорошо работает с пятью-десятью источниками данных. Добавление слишком большого их количества одновременно без отбора взаимодополняющих, а не противоречащих друг другу источников делает агента более медленным и менее надежным. Бендерский рекомендует масштабироваться постепенно и проверять результаты на каждом этапе, а не подключать все доступные данные сразу.
Точность данных является обязательным условием. Агент может выполнять запросы к несоответствующим форматам — например, лентам отзывов JSON наряду с таблицами продаж SQL — без предварительной нормализации. Он не может исправить исходные данные, которые содержат фактические ошибки. Добавление описания каждого источника данных на обычном языке на этапе загрузки помогает агенту правильно направлять запросы с самого начала.
Исследование позиционирует это как первый шаг на более длинном пути. По мере развития корпоративных рабочих нагрузок ИИ от агентов будут ожидать умения оперировать десятками типов источников, включая информационные панели, репозитории кода и внешние каналы данных. Авторы исследования утверждают, что именно декларативный подход делает такое масштабирование управляемым, поскольку добавление нового источника остается задачей конфигурации, а не проектирования.
«Это вроде лестницы, — сказал Бендерский. — Агент будет постепенно получать все больше и больше информации, а затем постепенно улучшать свои общие показатели».




