


Идентичность ИИ-агентов: D&B перестроила свой граф из 642 миллионов компаний
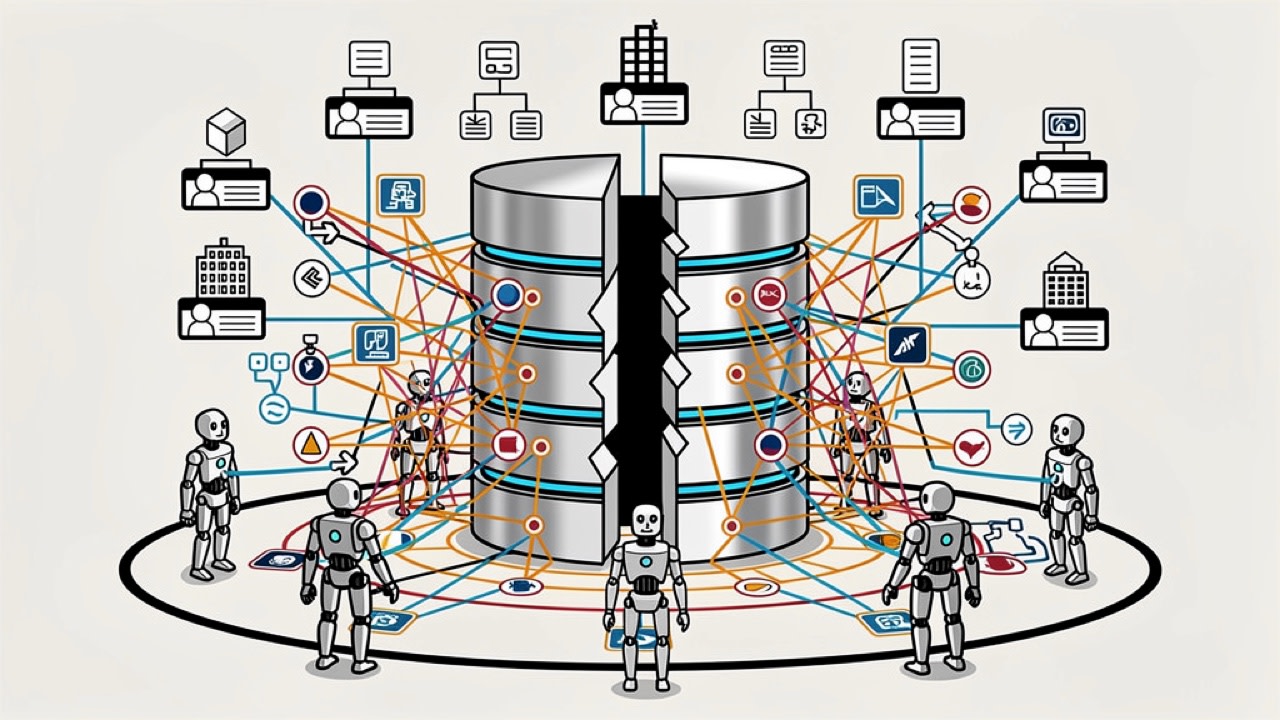
Источник: VentureBeat · Sean Michael Kerner


Компания Dun & Bradstreet потратила более 180 лет на создание исчерпывающей коммерческой базы данных. Ее граф коммерческих связей (Commercial Graph), охватывающий 642 миллиона компаний и их взаимосвязей, корпоративных иерархий и профилей рисков, создавался для людей. Для кредитных аналитиков, менеджеров по рискам и специалистов по продажам, которые могли подождать результатов запроса и разобраться с неоднозначными совпадениями сущностей. ИИ-агенты не способны делать ничего из этого.
Когда клиенты D&B начали внедрять агентов в рабочие процессы кредитования, закуплений и цепочек поставок, граф коммерческих связей, который надежно служил почти 200 000 клиентов по всему миру, превратился в проблему. Системы, созданные для обслуживания аналитиков-людей, обладали неверной архитектурой для машин. И тогда D&B провела полную перестройку.
«Нам нужно рассматривать агентов как нашу новую потребительскую категорию, переходя от стандартных кредитных аналитиков или специалистов по продажам и маркетингу и т. д. к тому, чтобы теперь обслуживать и агентов этих клиентов», — рассказал в интервью VentureBeat Гари Котовец (Gary Kotovets), директор по данным и аналитике в Dun & Bradstreet.
Что сломалось, когда агенты начали отправлять запросы
Граф коммерческих связей не был единой базой данных. Он представлял собой совокупность разрозненных систем, созданных для различных сценариев использования и разных рынков, которые удерживались вместе за счет пользовательских интеграций. Аналитики-люди справлялись с этой фрагментацией с помощью SQL-запросов или готовых интерфейсов. Агенты не могли.
Масштаб базовых данных усугублял проблему. По данным D&B, за пять лет база данных выросла почти вдвое: с более чем 300 миллионов до более чем 642 миллионов коммерческих записей, причем на каждую запись приходится 11 000 полей. В настоящее время компания выполняет примерно 100 миллиардов проверок качества данных в месяц по мере продвижения записей через свои системы. Запрос этих данных с субсекундной задержкой, необходимой агентам, в условиях фрагментированной архитектуры был невозможен.
Взаимосвязи, которые отслеживал граф, также были не того типа. Устаревшие системы фиксировали статические связи между сущностями. Генеральный директор был связан с компанией. На этом всё. Агентам, работающим над оценкой кредитоспособности или сторонних рисков, требуются динамические взаимосвязи: когда этот генеральный директор переходит в новую компанию, за какой организацией следует его послужной список? Когда меняется структура собственности дочерней компании, как это отражается на корпоративной иерархии? Раньше подобные вопросы требовали ручной работы аналитиков. Агенты не могут ждать, пока аналитики выполнят эту работу.
Более широкая проблема уникальна не только для D&B. Котовец отметил, что за последние шесть месяцев общался с сотнями руководителей по работе с данными (CDO) и директоров по информационным технологиям (CIO) и постоянно слышал одно и то же ограничение: они не могут создать то, что хотят в сфере ИИ, поскольку их фундамент данных не стандартизирован, не нормализован и не приспособлен для запросов агентов. У D&B была такая основа, созданная за десятилетия работы для обслуживания аналитиков-людей. И тем не менее им пришлось перестраивать ее для агентов.
Что они создали на самом деле
Перестройка началась с консолидации. D&B перенесла свои фрагментированные базы данных в облачную инфраструктуру, перепроектировала базовую схему и создала уровень структуры данных (data fabric), который нормализует записи на разных рынках, сохраняя при этом требования регионального соответствия нормативным требованиям. Результатом стал единый граф знаний, который отслеживает миллиарды взаимосвязей между 642 миллионами компаний, непрерывно обновляемый и обогащаемый за счет обработки данных на основе искусственного интеллекта.
Поверх этого графа D&B создала структурированный уровень доступа для агентов. Прямой доступ через SQL при объемах запросов агентов и требованиях к задержке не был решением проблемы. Вместо этого D&B создала набор инструментов и возможностей, доступных через MCP (Model Context Protocol), которые упаковывают данные вместе с контекстом и направляют агентов к нужным записям для конкретных запросов. За каждым запросом стоит механизм сопоставления и разрешения сущностей, подтверждающий, что когда агент запрашивает информацию о компании, ответом является проверенная конкретная сущность, а не просто совпадение по имени.
D&B решила проблему идентификации агентов с двух сторон
Перестройка графа и добавление доступа через MCP решили проблему извлечения данных. Но это не решило проблему идентификации. Агенты — не люди, и модель аутентификации, созданная для пользователей-людей, не распространялась на машины.
D&B создала новую модель регистрации для агентов. Они должны сопоставляться с проверенным IP-адресом и регистрировать индивидуальный ключ доступа, который рассматривается как аутентифицированная сущность в том же конвейере, что и пользователь-человек.
«У нас фактически есть концепция «Знай своего агента» (Know Your Agent), аналогичная принципу «Знай своего клиента» (Know Your Customer), которая выполняет эти дополнительные проверки», — сказал Котовец.
Это решает проблему входящего трафика: определение того, какой компании принадлежит агент и к каким данным он имеет право делать запросы. Но D&B также разработала решение для исходящей проблемы: что происходит, когда собственный многоагентный рабочий процесс клиента теряет понимание того, какую именно компанию он анализирует.
В рабочем процессе, объединяющем агента проверки кредитоспособности, агента KYC и агента проверки сторонних рисков, каждый из них обращается к D&B на определенном этапе. Без механизма, подтверждающего, что все они ссылаются на одну и ту же сущность, рабочий процесс может завершиться при работе с расходящимися записями.
«Они должны вернуться к нашему агенту верификации, чтобы убедиться, что они все еще говорят друг с другом об одной и той же сущности, — пояснил Котовец. — В некотором смысле это похоже на цифровое рукопожатие».
Агент проверки бизнеса от D&B может быть встроен в любой рабочий процесс в качестве постоянной точки отсчета и доступен по протоколу Google A2A независимо от того, какой инструмент оркестрации использует клиент.
Четыре вещи, которые предприятия должны сделать правильно перед развертыванием ИИ-агентов
Перестройка выявила требования, которые выходят за рамки собственного технологического стека D&B.
-
Фундамент данных предшествует инфраструктуре агентов. Руководители по работе с данными (CDO) и ИТ-директора (CIO), с которыми Котовец общался за последние шесть месяцев, постоянно сталкивались с одной и той же преградой: они не могут создать то, что хотят в сфере ИИ, пока их данные не станут чистыми, нормализованными и консолидированными. У D&B эта база уже была. У большинства предприятий ее нет, и они это почувствуют.
-
Проектируйте с учетом динамических связей, а не статических. Корпоративные системы данных обычно фиксируют соединения на определенный момент времени: человек принадлежит компании, актив принадлежит дочерней компании. Агентам, работающим над принятием решений по кредитам, рискам или цепочкам поставок, необходимо рассуждать в категориях взаимосвязей, которые меняются со временем. Если исходные данные фиксируют только статичную линию, агент поступит так же.
-
Встраивайте проверки согласованности сущностей в многоагентные рабочие процессы. Когда несколько агентов затрагивают одну и ту же сущность на разных этапах, нет никакой гарантии, что к моменту завершения рабочего процесса все они ссылаются на одну и ту же запись. Этот пробел необходимо учитывать при проектировании явным образом. Верификация сущностей — это требование к дизайну рабочего процесса, а не опциональный предохранитель.
-
Внедряйте происхождение данных с самого начала, а не в качестве доработки. Каждый ответ, полученный от агента, должен содержать прослеживаемый путь к своему источнику. В вопросах кредитования, рисков и цепочек поставок цена ошибки вполне осязаема. Происхождение (lineage) необходимо закладывать до масштабирования, а не добавлять после возникновения проблем.
«Вы всегда можете нажать на элемент, посмотреть, откуда он взялся, и проверить его вплоть до первоисточника, — сказал Котовец. — Для нас это стало ключом к раскрытию множества других возможностей, потому что у нас есть такой уровень уверенности в том, что мы сделали».




