Claude Opus 5.5 использует длинные тире на 99% реже и звучит человечнее, но в его текстах всё ещё встречается 2 548 признаков, характерных для ИИ


На прошлой неделе Anthropic выпустила свою новую флагманскую большую языковую модель (LLM) Claude Opus 5.5, и, согласно новому анализу цифрового маркетингового агентства Graphite, в выборе слов она больше напоминает человека, чем её предшественница.
Но тех, кто надеется, что модель избавилась от узнаваемых привычек, ждёт разочарование: исследователи выявили 2 548 слов, фраз и синтаксических шаблонов, которые в сгенерированных ею статьях встречаются как минимум вдвое чаще, чем в сопоставимых текстах, написанных людьми.
Обновление исследования AI Tells от Graphite, которым компания поделилась с VentureBeat до запланированной на четверг публикации, добавляет последнюю модель Opus от Anthropic к анализу изменений в текстах ИИ от поколения к поколению. Сравнение охватывает статьи десяти моделей и авторов-людей на 9 974 сопоставимых темы.
Главный вывод касается расхождения в распределении слов — показателя того, насколько по-разному два корпуса текстов используют слова в целом. Показатель Opus 5.5 по сравнению с выборкой текстов людей составляет 0,052 — на 19% меньше, чем у Opus 5 (0,064). Новейшая флагманская модель OpenAI GPT-6 Astra, выпущенная в начале этого месяца, демонстрирует противоположную динамику: её показатель составляет 0,109 против 0,101 у GPT-5.6 Sol.
Результаты дают корпоративным командам, работающим с контентом, возможность изучать поведение моделей не только на примере программирования и агентных тестов. Они также показывают, почему для оценки текстов ИИ недостаточно проверить, перестала ли модель использовать несколько привычных выражений.
«Думаю, результаты показывают не то, что модели постоянно становятся лучше или хуже, — сказал генеральный директор Graphite Итан Смит в видеоинтервью VentureBeat. — Они просто разные, и каждая отличается от остальных, что довольно удивительно».
Длинное тире почти исчезает
По подсчётам Graphite, в статьях Opus 5.5 на 1 000 слов приходится всего 0,015 длинного тире — по сравнению с 2,92 у Opus 5. Это снижение примерно на 99%.
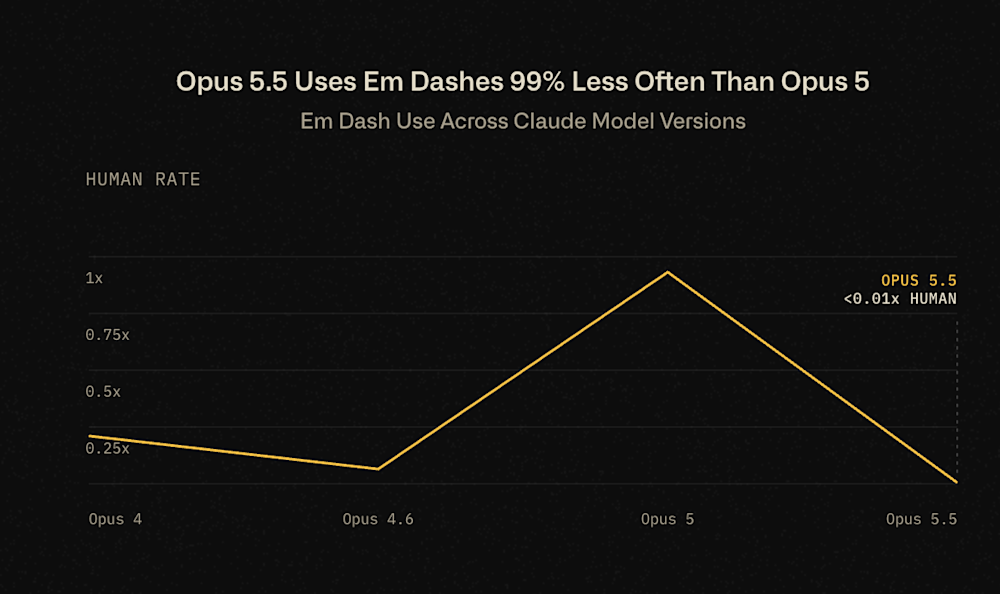
Исследование Graphite.io об использовании длинного тире в Anthropic Claude Opus 5.5. Источник: Graphite
Новая модель использует длинное тире гораздо реже, чем авторы-люди из выборки. Astra тоже ставит его заметно реже, чем люди.
Это усложняет распространённое представление о длинном тире как о признаке текста, сгенерированного машиной. Знак препинания, вызывающий подозрения, может стать редкостью в новых моделях, оставаясь при этом обычной частью письменной речи людей.
Opus 5.5 также набирает меньше баллов по показателю того, что Anthropic называет «вычурной прозой», — языку, в котором метафоры и украшательства преобладают над прямым выражением мысли. Показатель Graphite снизился на 37%: с 16,75 у Opus 5 до 10,57 у Opus 5.5. Тем не менее он остаётся выше, чем у выборки текстов людей (6,65) и Astra (7,91).
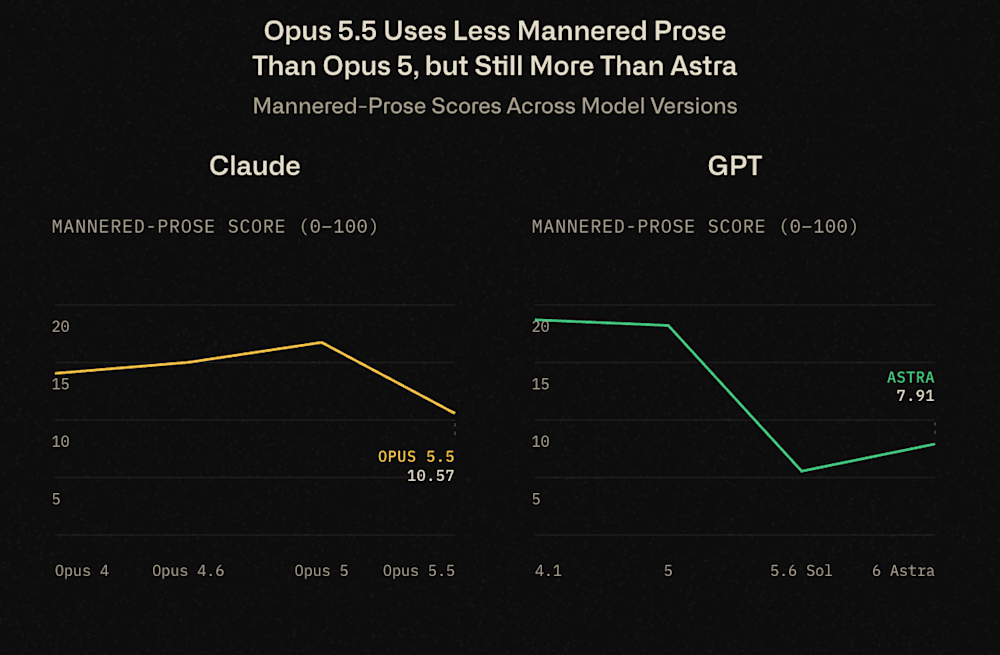
Сравнение вычурности прозы Anthropic Claude Opus 5.5 и OpenAI GPT-6 Astra. Источник: Graphite
Для оценки этого качества на подмножестве из 1 000 сопоставимых тем Graphite использует Claude Opus 5. Поэтому показатель отражает оценку стиля самой моделью, а не механический подсчёт витиеватых предложений.
Грегори Драк, директор по ИИ в Graphite, сказал, что в его собственных экспериментах с письмом оказалось полезно просить модель избегать такого стиля.
«В последнее время я часто прошу её не писать вычурно, — сказал Драк. — Это довольно хорошо работает».
Однако исследование не приравнивает стилистическое сходство к качеству.
«Не думаю, что в этой работе мы обязательно выносим такое суждение», — сказал Драк.
Результат по расхождению тоже имеет конкретный смысл: в целом словоупотребление Opus 5.5 ближе к текстам людей из выбранной Graphite выборки веб-статей. Это не доказывает, что читатели примут отдельную статью за написанную человеком, и не показывает, что модель создаёт более точный, оригинальный или полезный контент.
Старые привычки ослабевают, новые — закрепляются
Одни знакомые признаки становятся менее заметными, зато другие встречаются чаще.
По сравнению с Opus 5 новая модель использует выражение «может помочь вам» в статьях Graphite в восемь раз чаще, а «особенно полезно» — в 12 раз чаще. Opus 5 употребляет выражение «действительно» в 26 раз чаще, чем его преемница.
Сравнение моделей разных семейств выявляет ещё одно различие. Opus 5.5 использует выражение «самый мощный» в 24 раза чаще, чем Astra, тогда как Astra употребляет «не обязательно» в 17 раз чаще, чем Opus 5.5. По описанию исследователей, Claude чаще использует превосходные степени, а Astra — чаще оговаривает свои утверждения.
Общее число выявленных признаков между двумя последними версиями Opus снизилось лишь незначительно: у Opus 5.5 их 2 548 против 2 666 у Opus 5. В более широкой линейке Claude Graphite насчитала 3 746 таких признаков у Opus 4 и 3 059 у Opus 4.6.
В подсчёт входят слова, короткие фразы и повторяющиеся шаблоны с переменными промежутками. Чтобы попасть в список, признак должен встречаться как минимум вдвое чаще, чем в текстах людей, с поправкой на объём текста, а также соответствовать минимальным требованиям к частоте. Его наличие в одном документе не доказывает, что текст написал ИИ.
Кроме того, Graphite отдельно отслеживает 11 привычных особенностей письма, включая шаблонные концовки и слова, обычно ассоциируемые с ИИ. Совокупная выраженность этих признаков, позволяющих отличить Opus 5.5 от выборки текстов людей, на 6% ниже, чем у Opus 5, и на 53% ниже, чем у Opus 4.
Эти два результата не противоречат друг другу: модель может в целом писать больше похоже на человека, сохраняя при этом тысячи выражений, которые использует непропорционально часто.
Люди тоже меняют стиль письма
По словам Драка, всеобщее внимание к особенностям текстов ИИ может влиять и на тех, кто пишет без таких инструментов.
Он рассказал, как один автор из Graphite в шутку предложил намеренно допускать несовершенства, чтобы его не приняли за ИИ. Драк также вспомнил выступающего, который сделал паузу, чтобы объяснить: длинное тире на слайде поставил человек.
«Люди рассказывают, что меняют свои привычки письма, чтобы не звучать как ИИ», — сказал Драк.
Graphite пока не подтверждала это наблюдение систематическим исследованием. Драк сказал, что команда хочет изучить этот вопрос подробнее.
Он также предполагает, что разработчики ИИ намеренно устраняют некоторые широко известные признаки, хотя анализ не позволяет установить, какие именно решения при обучении приводят к наблюдаемым изменениям.
«Думаю, они проводят целевые тесты и пытаются убрать определённые особенности», — сказал он.
Если и люди, и модели меняют свои привычки, выражения, которые читатели считают доказательством авторства ИИ, могут быстро утратить свою ценность. По словам Драка, общественное представление о моделях может отставать от выхода новых версий.
Для компаний, создающих маркетинговые тексты, справочные материалы и другой деловой контент, это означает практическую проблему при оценке: инструкции, учитывающие слабые стороны одной модели, возможно, придётся пересматривать после её обновления.
Базовый тест с важными ограничениями
В основе первоначальной методологии Graphite лежат 10 000 веб-статей, опубликованных до запуска ChatGPT в ноябре 2022 года. Исследователи используют GPT-4.1, чтобы кратко пересказать каждую статью, а затем просят другие модели написать на основе этих пересказов статьи примерно той же длины, что и оригиналы.
Такой подход позволяет сопоставить темы, не прося модели напрямую воспроизводить исходные тексты. После добавления Opus 5.5 общий набор, доступный для сравнения, сократился до 9 974 тем, поэтому некоторые показатели для более ранних моделей немного отличаются от данных первоначального исследования.
Все модели получают один и тот же неизменный запрос. Команда специально не просит их подражать авторам-людям или избегать известных признаков.
Драк сказал, что Graphite планирует продолжить работу и проверить инструкции, призванные сделать сгенерированный текст более похожим на человеческий, а затем изучить, какие различия сохраняются. Это поможет отделить легко меняющиеся особенности словоупотребления от более устойчивых признаков.
Один из возможных таких признаков — разнообразие длины предложений. Драк указал на первоначальный анализ, который показал, что люди варьируют длину предложений сильнее, чем модели.
«Люди пишут и короткие, и очень длинные предложения, — сказал он. — А у языковых моделей предложения обычно более одинаковы по длине».
Сохраняется ли это различие, если прямо попросить модель очеловечить текст, — пока лишь гипотеза, а не вывод текущего обновления исследования.
Важны и другие ограничения. Результаты могут измениться при другом запросе, редактуре человеком или выполнении другой задачи. Тексты для сравнения, написанные людьми, старше сгенерированных, поэтому на различия, приписываемые ИИ, могут влиять изменения в веб-письме с 2022 года. Кроме того, оценка витиеватости прозы с помощью модели может привносить предвзятость оценщика.
Данные для независимого анализа
Смит подчеркнул, что Graphite предоставляет для скачивания статьи и измеренные признаки, позволяя другим изучить сравнения и задать дополнительные вопросы.
«Любой желающий тоже может посмотреть на эти данные, изучить их и обнаружить другие закономерности», — сказал он.
Исследователи хотят и дальше отслеживать выход новых моделей, но не обязуются тестировать каждую из них. Драк предположил, что обновления раз в несколько месяцев могут оказаться более посильным вариантом; Смит выразил заинтересованность в изучении крупных релизов.
Для корпоративных команд нынешнее исследование подтверждает, что тексты следует оценивать с учётом их реальной цели: понятно ли они доносят информацию, содержат ли обоснованные утверждения и соответствуют ли нужному тону.
Снижение числа очевидных признаков ИИ может быть полезно, но результаты Graphite показывают, насколько устойчивыми — или, напротив, изменчивыми — могут оставаться другие особенности модели от версии к версии.