


Оценка работы ИИ-агентов упускает из виду неработающие продукты
Источник: VentureBeat · Sean Michael Kerner


Одиночный диалог с ИИ-агентом может выглядеть безупречно при оценке сам по себе и при этом указывать на неработающий продукт. Этот разрыв заставляет предприятия менять подход к оценке агентов: уходить от оценки отдельных цепочек (трейсов) в пользу сравнения групп пользователей с базовыми показателями.
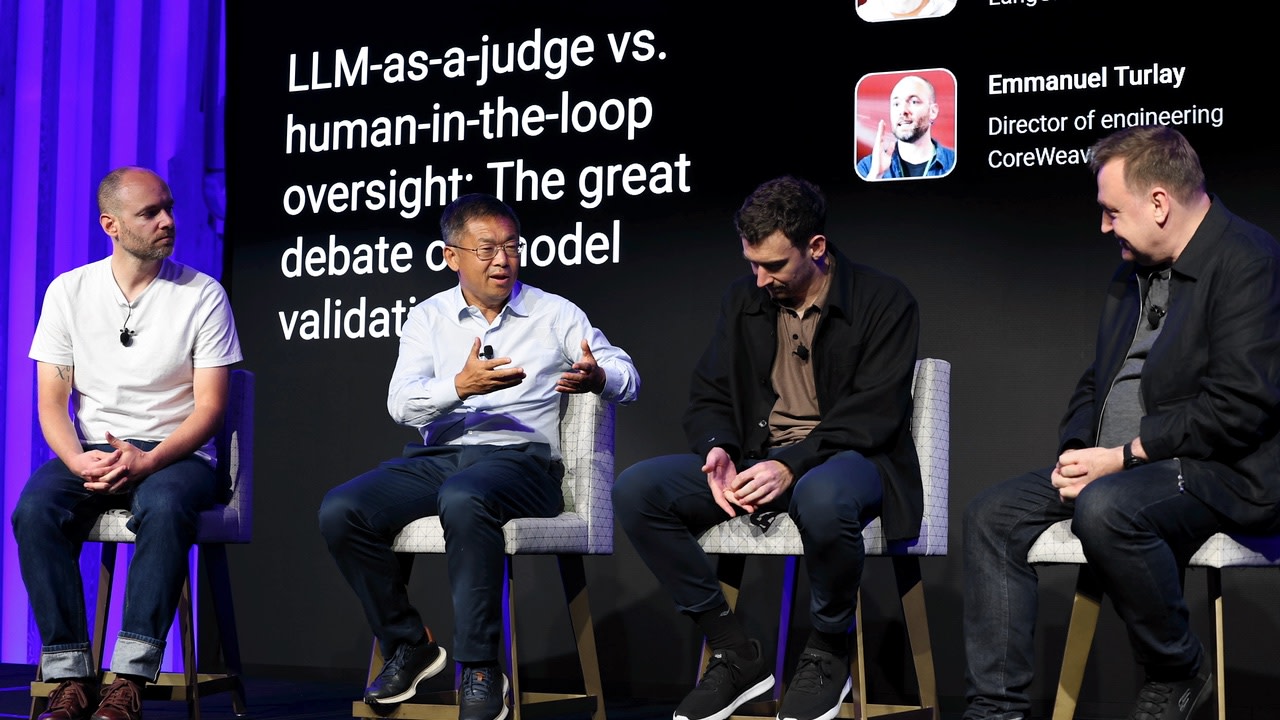
На конференции VB Transform 2026 Харрисон Чейз (Harrison Chase), генеральный директор LangChain; Хуэй Чжан (Hui Zhang), технический директор и сооснователь Conviva; и Эмманюэль Турле (Emmanuel Turlay), директор по инженерным разработкам в CoreWeave, рассказали об этом изменении, а также о параллельном переходе в сторону более дешевых и узкоспециализированных моделей-судей.
Подход «агент в роли судьи» (когда один ИИ-агент оценивает вывод другого) не вытеснил подход «LLM в роли судьи», который, по словам Чейза, остается стандартным по умолчанию. Более серьезное противоречие, как отметил Чжан, заключается между автоматизированной оценкой (будь то с помощью LLM или агента) и проверкой человеком.
«У вас есть масштабируемый, но необоснованный подход — будь то агенты или LLM в роли судьи, вы оцениваете результат, вы оцениваете работу. Ее все еще очень трудно обосновать, а затем вы привлекаете людей, и это просто не масштабируемо», — сказал Чжан. «Вся индустрия сталкивается с этим: какой яд вы хотите выбрать?»
Критерии оценки теперь выполняют роль спецификации продукта
Этот разрыв — когда диалог получает высокие баллы, но при этом сигнализирует о неисправности продукта — команды пытаются устранить, создавая исчерпывающий набор тестов перед выпуском любого релиза. По словам Чейза, это не работает.
«Иногда мы видим команды, у которых наблюдается почти паралич перед тестированием», — говорит Чейз. «Они говорят: это тестовый набор, я не могу это запустить. Лучшие команды запускают продукт, а затем проводят итерации».
Чейз охарактеризовал критерии оценки как живую спецификацию, а не как одноразовый набор тестов: документ с требованиями к продукту — стандартную спецификацию разработки программного обеспечения для того, что должно делать приложение. «Оценки (эвалы) — это новые PRD (документы с требованиями к продукту)», — сказал он. «Они определяют, что ваш агент должен делать, а чего делать не должен».
Турле описал аналогичную проблему, но с другой стороны. «Я пытался достичь 100% покрытия тестами, и у меня все равно были баги в продакшене», — сказал он. Набор тестов выглядел полным, но все равно упускал то, что имело значение, — тот самый разрыв, о котором говорил Чейз применительно к эвалам.
Широкий, постоянно действующий мониторинг, по его словам, выявляет больше реальных сбоев, чем исчерпывающий набор предрелизных тестов. Командам следует сначала настроить широкие онлайн-проверки, использовать их для выявления классов ошибок по мере их возникновения, а затем создать целевой офлайн-набор для оценки выявленных проблем.
Почему оценивать цепочки по одной — это ошибка
Даже хорошо выстроенный процесс оценки все равно может оценивать не то, что нужно. Возражение Чжана касается того, как большинство команд проводят оценку: они берут выборку цепочек (будь то 50 штук или вся совокупность) и оценивают каждую изолированно. Такой подход упускает из виду сигнал, который проявляется только при сравнении групп пользователей с базовым уровнем — метод, который Чжан называет контрастным анализом.
Чжан проиллюстрировал это на примере розничной торговли: покупатель просит агента подобрать кроссовки для бега перед полумарафоном, агент задает уточняющие вопросы, и покупатель покупает обувь. При индивидуальной оценке это взаимодействие выглядит нормально. Но коэффициент уточнений — то, сколько дополнительных вопросов задает агент перед выполнением задачи — для этой категории обуви среди всей пользовательской совокупности оказался в три раза выше базового уровня. Второй показатель — как часто покупатели завершали покупку за пределами диалога — был в пять раз выше базового уровня для той же категории.
Ни одно из этих чисел не видно по одной отдельно взятой цепочке. Оба они указывают на проблему, которую можно отладить и которая специфична для конкретной категории. Чжан отметил, что в индустрии также не хватает второго источника данных: информации о том, что происходит до, между и после разговора, а не только самой цепочки.
Масштабирование судьи под конкретную задачу
Как только контрастный анализ показывает, какая категория на самом деле сломана, следующей проблемой становится то, что будет отслеживать это в дальнейшем — и по какой цене. Правило Турле заключалось в том, чтобы начинать с самой мощной из доступных моделей, чтобы доказать решаемость задачи, а затем двигаться вниз. Если задачу нельзя решить с помощью модели высшего уровня, сказал он, она не сработает и с меньшей. Как только паттерн доказывает свою жизнеспособность, команды могут производить выборку лишь части трафика вместо оценки каждого взаимодействия, а более простые задачи, такие как бинарная классификация, перекладывать на меньшие открытые модели.
LangChain пошла дальше, дообучив собственную модель для определения моментов, когда пользователь считает, что агент совершил ошибку, — сигнал, который Чейз называет «воспринимаемой ошибкой» (perceived error). «Модель, которую мы дообучили, была моделью Qwen», — сказал он, имея в виду семейство моделей с открытым исходным кодом от Alibaba. Сочетание ручной разметки с дистилляцией дало отличные результаты. «Аналогично [Claude] Sonnet, но — в зависимости от того, как мы ее развертывали — с сокращением затрат в 10–100 раз», — отметил Чейз.
Не каждый защитный барьер (guardrail) требует использования модели. Чейз указал на собственные защитные механизмы Claude Code в качестве доказательства: регулярные выражения (regex), распространенный метод программирования для поиска и проверки паттернов в коде. «Многие из имевшихся у них барьеров представляли собой просто регулярные выражения», — сказал он. «Это были не маленькие LLM, а просто регулярные выражения».
LLM в роли судьи не означает исчезновение человека в цепочке принятия решений
Более масштабный вопрос заключается в том, избавляет ли использование LLM в качестве судьи от необходимости участия человека в контуре.
Турле указал на вопрос ответственности, опираясь на свой прошлый опыт работы в компании по производству самоуправляемых автомобилей. Его команда сократила сбор данных и переобучение до двухнедельного цикла для выпуска новой модели в автомобиль. Но даже в этом случае кто-то все равно должен был дать окончательное одобрение.
«Я был уверен от лица компании в том, что эту модель можно устанавливать в машину», — сказал он. Эта же логика применима к сферам юриспруденции, финансов и здравоохранения. «Прежде чем мы сможем исключить человека, который скажет: «Я одобряю это и несу за это юридическую ответственность», пройдет еще немало времени, прежде чем агенты смогут делать это самостоятельно».
Чжан согласился с тем, что человек должен оставаться гарантом в нестандартных ситуациях, даже если автоматизация в конечном итоге достигнет масштаба, превосходящего точность отдельного человека — машины способны замечать больше на уровне закономерностей.
Чейз пошел дальше: такая проверка человеком — это не просто страховочная сетка. «Человек в контуре действительно важен для формирования доверия к тому, как работают эти агентные системы, а также крайне важен для памяти и обучения систем», — сказал он. «Для того чтобы система училась, необходимы взаимодействия».




