


Liquid AI представляет модели Liquid Nanos


Liquid AI, стартап, разрабатывающий альтернативы популярным ИИ-моделям на базе «трансформеров», которые определили эпоху генеративного ИИ, анонсирует не одну, не две, а целое семейство из шести различных типов ИИ-моделей под названием Liquid Nanos. По заявлению компании, они гораздо лучше приспособлены к «реалиям большинства развертываний ИИ» на предприятиях и в организациях, чем более крупные базовые модели таких конкурентов, как OpenAI, Google и Anthropic.
Liquid Nanos — это специализированные базовые модели с количеством параметров от 350 миллионов до 2,6 миллиардов, ориентированные на корпоративное внедрение. Их можно развернуть и использовать на периферийных устройствах корпоративного класса: от ноутбуков и смартфонов до массивов датчиков и небольших роботов.
По словам компании, Liquid Nanos обеспечивают производительность, соперничающую с гораздо более крупными моделями в специализированных агентных рабочих процессах, таких как извлечение многоязычных данных, перевод, вопросно-ответные системы с дополненной генерацией (RAG), низколатентный вызов инструментов и функций, математические рассуждения и многое другое.
Это альтернативный подход к волне «агентного ИИ», оседлать которую в последнее время стремились многие компании. Обычно организация использует крупную базовую модель вроде тех, что предлагают Google (Gemini), OpenAI (GPT-5 и серия o), Anthropic (Claude) или другие, и пытается узко нацелить ее на задачу или набор задач с помощью промптинга, кэширования и памяти.
Разумеется, это по-прежнему требует поддержки (и оплаты доступа) более мощных централизованных моделей на облачных серверах. Из-за этого такие агенты страдают в регионах с плохим интернет-соединением или в приложениях, ориентированных на конфиденциальность и безопасность, а возможности изменения или кастомизации базовых моделей оказываются сильнее ограничены.
Перенося вычисления на сами устройства вместо опоры на облачную инфраструктуру, Liquid Nanos стремятся повысить скорость, снизить затраты, улучшить конфиденциальность и задействовать приложения в корпоративных и исследовательских средах, где ограничены подключение к сети или энергопотребление.
Компания прямо говорит об этом в своем блоге, заявляя:
«В нашем обществе люди не будут использовать одного общего ассистента. Вместо этого они будут полагаться на множество мелких специализированных агентов, которые работают на их устройствах (телефонах, ноутбуках, автомобилях, часах, домашних хабах), в приложениях (почте, календаре, документах, браузере, покупках, путешествиях, финансах) и используемых ими сервисах (каждый банк, оператор связи, ритейлер или поставщик медицинских услуг часто запускает персональных агентов для персонализации, поддержки, оценки рисков и комплаенса). Добавьте сюда эфемерных микроагентов, создаваемых во время рабочих процессов (RAG-извлекатели, парсеры, переводчики, инструменты вызова функций), а также фоновых агентов безопасности и автоматизации, — и вы быстро дойдете до примерно 100 агентов на человека».
Специализированные решения
Первый набор моделей в линейке Liquid Nanos разработан для конкретных сценариев использования:
-
LFM2-Extract: многоязычные модели (350 млн и 1,2 млрд параметров), оптимизированные для извлечения структурированных данных из неструктурированного текста (например, конвертации писем или отчетов в JSON или XML).
-
LFM2-350M-ENJP-MT: модель с 350 млн параметров для двунаправленного англо-японского перевода, обученная на широком спектре типов текста.
-
LFM2-1.2B-RAG: модель с 1,2 млрд параметров, настроенная для конвейеров дополненной генерации (RAG), обеспечивающая точные ответы на вопросы по большим наборам документов.
-
LFM2-1.2B-Tool: модель, специализированная для точного вызова инструментов и функций, разработанная для работы с низкой задержкой на периферийных устройствах без опоры на длинные цепочки рассуждений.
-
LFM2-350M-Math: модель, ориентированная на логические рассуждения и нацеленная на эффективное решение сложных математических задач, с использованием методов обучения с подкреплением для контроля многословности.
-
Серия Luth-LFM2: дообученные разработчиками из сообщества Синуэ Гадом (Sinoué Gad) и Максенсом Ласбордом (Maxence Lasbordes) модели со специализацией на французском языке при сохранении возможностей работы с английским.
Эти модели нацелены на конкретные задачи, где небольшие дообученные архитектуры могут соответствовать или даже превосходить универсальные системы размером более 100 миллиардов параметров.
Результаты оценки
Liquid AI сообщает, что ее модели для извлечения данных превосходят гораздо более крупные системы в бенчмарках, измеряющих синтаксическую валидность, точность и достоверность.
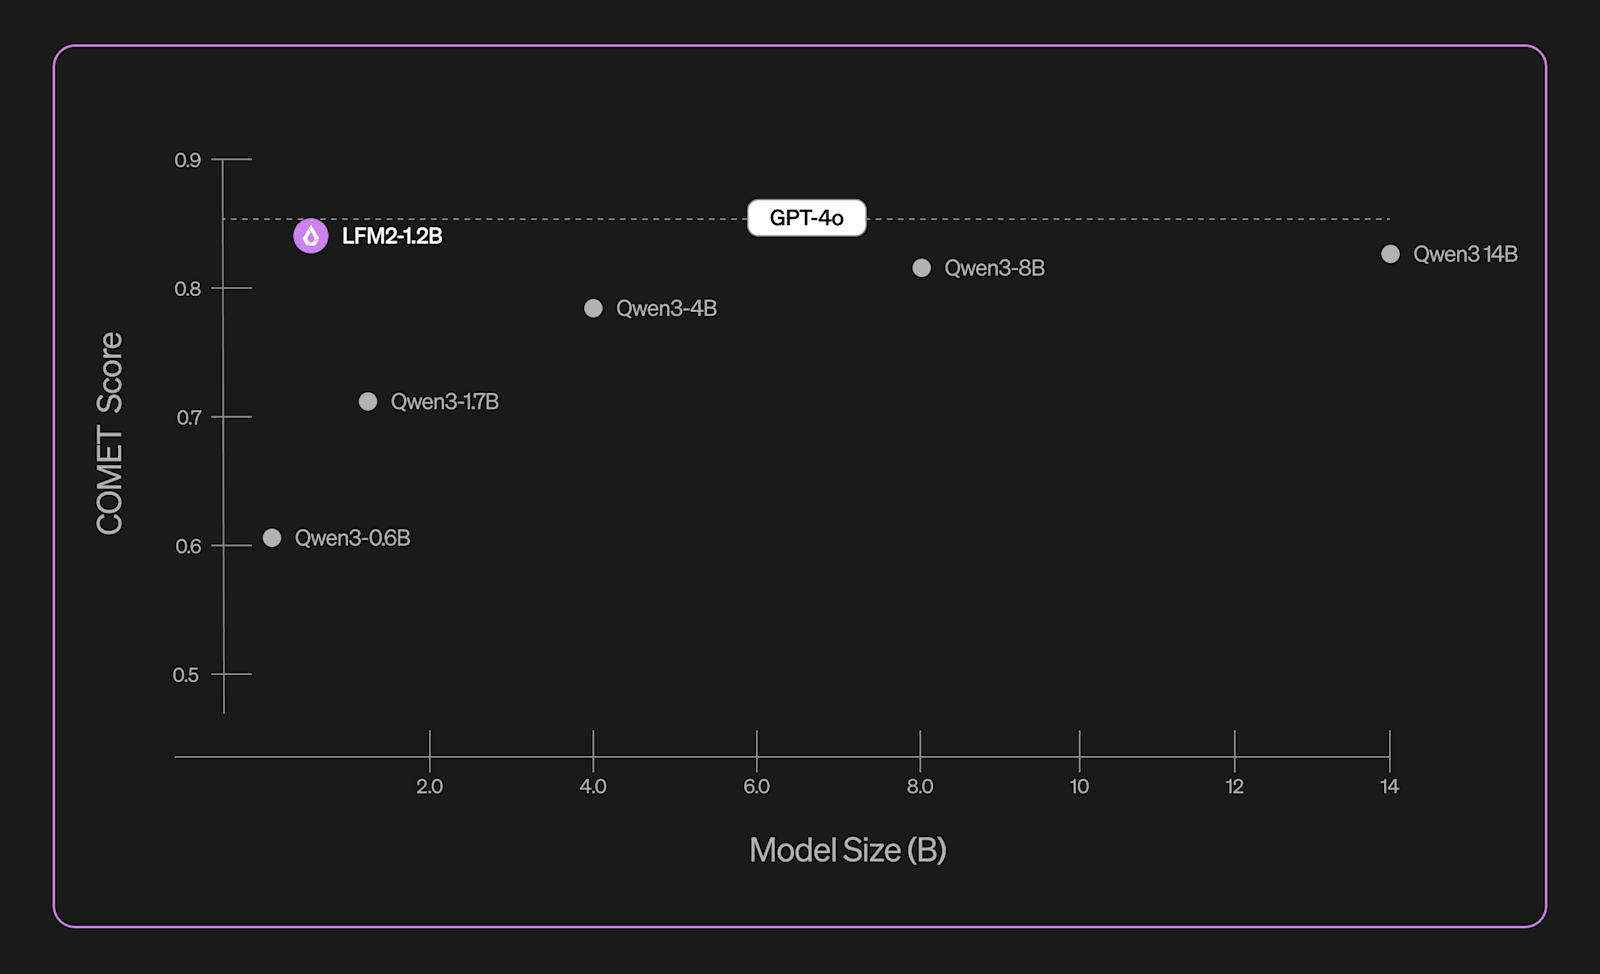
Бенчмарки базовой модели Liquid AI LFM2-1.2B. Источник: Liquid AI
Например, модель LFM2-1.2B-Extract выдает структурированные результаты на нескольких языках на уровне, превосходящем Gemma 3 27B — модель, которая более чем в 20 раз превосходит ее по размеру.
Для перевода модель LFM2-350M-ENJP-MT оценивалась с использованием бенчмарка llm-jp-eval и показала конкурентоспособную производительность по сравнению с GPT-4o. Аналогичным образом, ориентированная на RAG модель на 1,2 млрд параметров тестировалась наряду с аналогами сопоставимого размера и продемонстрировала конкурентоспособность в отношении обоснованности, релевантности и полезности.
Вклад сообщества также демонстрирует измеримые улучшения. Серия Luth-LFM2 улучшает показатели во французских бенчмарках, одновременно повышая производительность в англоязычных задачах, доказывая, что целевая специализация может улучшать межъязыковые результаты.
Доступность и лицензирование
Liquid Nanos доступны немедленно. Разработчики могут загрузить и развернуть их через платформу Liquid Edge AI Platform (LEAP) на iOS, Android и ноутбуках, а также через Hugging Face.
Варианты интеграции включают SDK и модульную компоновку в многоагентные системы.
Все они предоставляются под пользовательской лицензией Liquid AI LFM Open License v1.0. Она не является полностью открытым исходным кодом и покажется знакомой тем, кто знаком с условиями лицензирования Meta для своих моделей ИИ Llama.
Лицензия LFM Open License v1.0 дает разработчикам широкие права на использование, изменение и распространение моделей Liquid AI, причем ключевое условие привязано к выручке. Частные лица, исследователи, некоммерческие организации и компании с годовым доходом менее 10 миллионов долларов могут использовать модели как в исследовательских, так и в коммерческих целях бесплатно. Перераспределение и производные работы разрешены при условии сохранения авторства, документирования изменений и включения условий лицензии. Лицензия также включает патентные права от участников, хотя они аннулируются, если пользователь инициирует патентное судебное разбирательство.
Для предприятий с годовым доходом выше порога в 10 миллионов долларов лицензия не предоставляет прав на коммерческое использование. Крупным организациям необходимо согласовывать с Liquid AI отдельные коммерческие соглашения, если они хотят развернуть модели в продуктах или сервисах.
На практике это означает, что стартапы, ученые и небольшие компании могут внедрять модели Liquid и экспериментировать с ними без преград, в то время как более крупные предприятия сталкиваются с лицензионными расходами или ограничениями до масштабирования развертывания.
Liquid AI также сотрудничает с партнерами из списка Fortune 500 в таких отраслях, как бытовая электроника, автомобилестроение, электронная коммерция и финансы, для обеспечения индивидуальных развертываний.
Кроме того, бесплатное мобильное приложение Apollo в Apple App Store позволяет пользователям экспериментировать с моделями прямо на устройстве.
Почему маленькие модели имеют значение
За последние несколько лет достижения в области ИИ в основном обеспечивались за счет все более крупных моделей, размещаемых в дата-центрах. Это позволило добиться общего прогресса в понимании языка и рассуждениях, но повлекло за собой компромиссы в отношении стоимости, задержки и конфиденциальности. Для многих сценариев использования передача каждого запроса в облако непрактична.
Liquid AI позиционирует Nanos как поворот этой модели вспять: вместо отправки данных в передовые масштабные системы интеллект отправляется на устройство. Модели занимают от 100 МБ до 2 ГБ памяти, что делает их пригодными для развертывания на современном мобильном железе.
Рамин Хасани (Ramin Hasani), сооснователь и генеральный директор Liquid AI, бывший научный сотрудник Лаборатории искусственного интеллекта и компьютерных наук Массачусетского технологического института (MIT CSAIL), поместил этот запуск в более широкий контекст роста инфраструктурных затрат.
Он отметил, что к 2027 году в дата-центры планируется инвестировать более триллиона долларов, однако экономика таких расходов неопределенна, если эффективность не будет постоянно расти.
По его мнению, более устойчивый подход является гибридным, когда легкий инференс обрабатывается на устройствах, а в облако передаются только самые сложные задачи.
«Поскольку Nanos обеспечивают результаты фронтирного уровня в специализированных задачах и работают локально на устройствах, это наш первый шаг к планетарному ИИ «устройство-облако», который одновременно доступен и экономически разумен, — написал он в X. — Давайте переместим медианный токен на периферию!»
Истоки компании и ранние релизы
Компания Liquid AI была основана бывшими исследователями из MIT CSAIL для разработки базовых моделей, выходящих за рамки архитектуры на базе трансформеров, которая лежит в основе большинства больших языковых моделей.
С самого начала компания позиционировала себя как альтернативу доминированию трансформеров, создавая модели на принципах динамических систем, обработки сигналов и численной линейной алгебры.
Первый публичный релиз компании состоялся в сентябре 2024 года с выходом Liquid Foundation Models (LFMs). Эти нетрансформерные модели были предложены в трех размерах параметров — 1,3B, 3B и в виде варианта Mixture-of-Experts на 40B — и быстро привлекли внимание тем, что превосходили сопоставимые по размеру трансформерные системы.
В апреле 2025 года Liquid AI расширила свои архитектурные эксперименты с помощью Hyena Edge — гибридной модели на основе сверток, разработанной для смартфонов и периферийных систем.
Июль 2025 года ознаменовался запуском LFM2, архитектуры второго поколения компании. Созданная для обеспечения самого быстрого на устройствах инференса в своем классе, LFM2 достигла скорости декодирования и префиллинга на ЦП, которая в 2 раза выше по сравнению с Qwen3, и обеспечила трехкратную эффективность обучения по сравнению с предыдущим поколением.
Для поддержки внедрения Liquid AI одновременно представила Liquid Edge AI Platform (LEAP) — кроссплатформенный SDK для iOS и Android, упрощающий локальное развертывание небольших моделей. LEAP позволяет разработчикам интегрировать компактные модели с минимальными познаниями в машинном обучении, а сопутствующее приложение для iOS Apollo дает возможность автономного тестирования. В совокупности эти инструменты отражают стремление компании к децентрализации выполнения ИИ вне зависимости от облака.
Во всех этих релизах Liquid AI последовательно продвигала подход, основанный на эффективности и адаптируемости. От своих первых нетрансформерных LFM до специализированных моделей для периферии компания стремилась продемонстрировать, что маленькие и быстрые модели могут соперничать с гораздо более крупными системами, делая ИИ более доступным на различных устройствах и в разных отраслях.
Взгляд в будущее
Запуск Liquid Nanos подчеркивает сдвиг в стратегии развертывания ИИ в сторону более мелких, специализированных систем, способных работать независимо от облака.
В то время как гонка индустрии за масштабированием размеров моделей продолжается, Liquid AI делает ставку на то, что компактные, ориентированные на задачи модели обеспечат более широкое внедрение и новые классы приложений, особенно в условиях, где конфиденциальность, задержка или стоимость представляют собой серьезные препятствия.




