


Kimi K2 Thinking с открытым исходным кодом от Moonshot превосходит GPT-5 и Claude Sonnet 4.5


Несмотря на растущую озабоченность и скептицизм по поводу стратегии развития и масштабных расходов американского ИИ-стартапа OpenAI, китайские поставщики ИИ с открытым исходным кодом усиливают конкуренцию: одна из компаний с помощью новой бесплатной модели даже сравнялась с флагманской платной проприетарной моделью OpenAI GPT-5 в ключевых сторонних бенчмарках производительности.
Новая модель Kimi K2 Thinking от китайского ИИ-стартапа Moonshot AI, выпущенная сегодня, обошла как проприетарных, так и открытых конкурентов, заняв лидирующие позиции в тестах на логические рассуждения, написание кода и использование агентских инструментов.
Несмотря на полностью открытый исходный код, эта модель теперь превосходит GPT-5 от OpenAI, Claude Sonnet 4.5 (в режиме рассуждений) от Anthropic и Grok-4 от xAI в ряде стандартных оценок — это поворотный момент для конкурентоспособности открытых ИИ-систем.
Разработчики могут получить доступ к модели через platform.moonshot.ai и kimi.com; веса и код размещены на Hugging Face. Открытый релиз включает API для чата, рассуждений и работы с несколькими инструментами.
Пользователи могут опробовать Kimi K2 Thinking напрямую через ее собственный сайт-конкурент, похожий на ChatGPT, а также в пространстве на Hugging Face.
Модифицированная стандартная лицензия с открытым исходным кодом
Moonshot AI официально выпустила Kimi K2 Thinking под модифицированной лицензией MIT на платформе Hugging Face.
Лицензия предоставляет полные коммерческие и производные права — это означает, что индивидуальные исследователи и разработчики, работающие в интересах корпоративных клиентов, могут свободно получать к ней доступ и использовать ее в коммерческих приложениях, — но добавляет одно ограничение:
«Если программное устройство или любой производный продукт обслуживает более 100 миллионов активных пользователей в месяц или генерирует более 20 миллионов долларов США выручки в месяц, развертывающий обязан разместить заметное упоминание «Kimi K2» в пользовательском интерфейсе продукта».
Для большинства исследовательских и корпоративных приложений этот пункт функционирует как мягкое требование об указании авторства, сохраняя при этом свободы стандартной лицензии MIT.
Благодаря этому K2 Thinking становится одной из моделей передового уровня (frontier-class) с самыми мягкими лицензионными условиями из доступных в настоящее время.
Новый лидер бенчмарков
Kimi K2 Thinking представляет собой модель типа «мощная смесь экспертов» (Mixture-of-Experts, MoE) с общим числом параметров в один триллион, из которых 32 миллиарда активируются при одном инференсе.
Она объединяет долгосрочные рассуждения со структурированным использованием инструментов, выполняя до 200–300 последовательных вызовов инструментов без участия человека.
Согласно опубликованным результатам тестов Moonshot, модель K2 Thinking достигла следующих показателей:
-
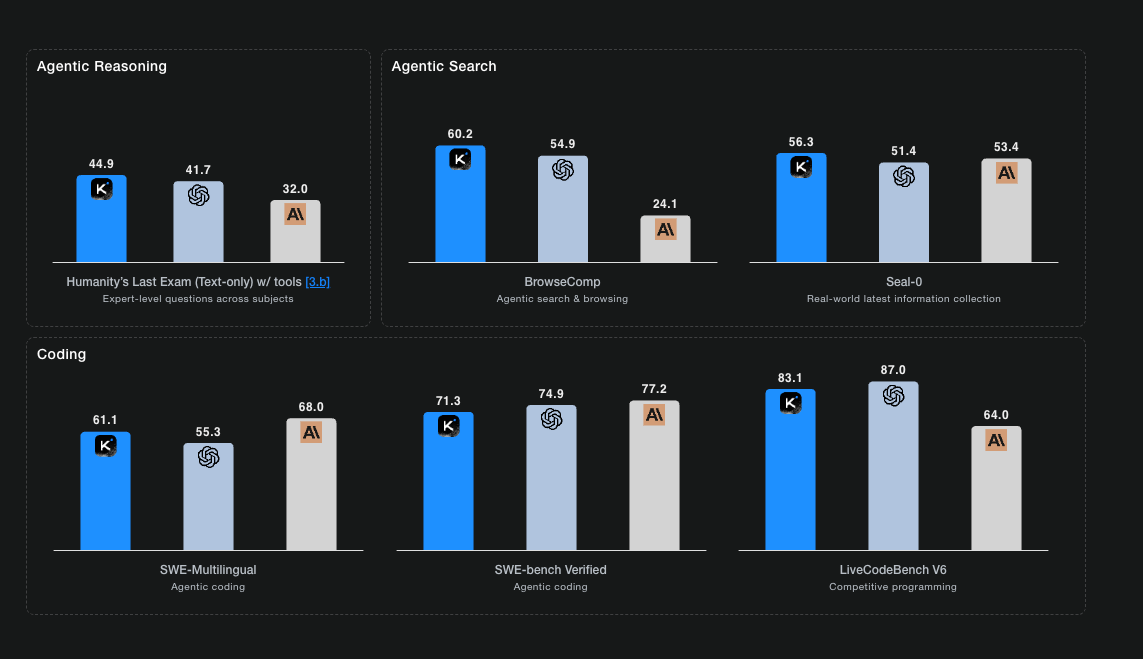
44,9 % в Humanity’s Last Exam (HLE) — результат современного уровня (state-of-the-art);
-
60,2 % в BrowseComp — тесте на агентский веб-поиск и логические рассуждения;
-
71,3 % в SWE-Bench Verified и 83,1 % в LiveCodeBench v6 — ключевых тестах по программированию;
-
56,3 % в Seal-0 — бенчмарке для поиска информации в реальных условиях.
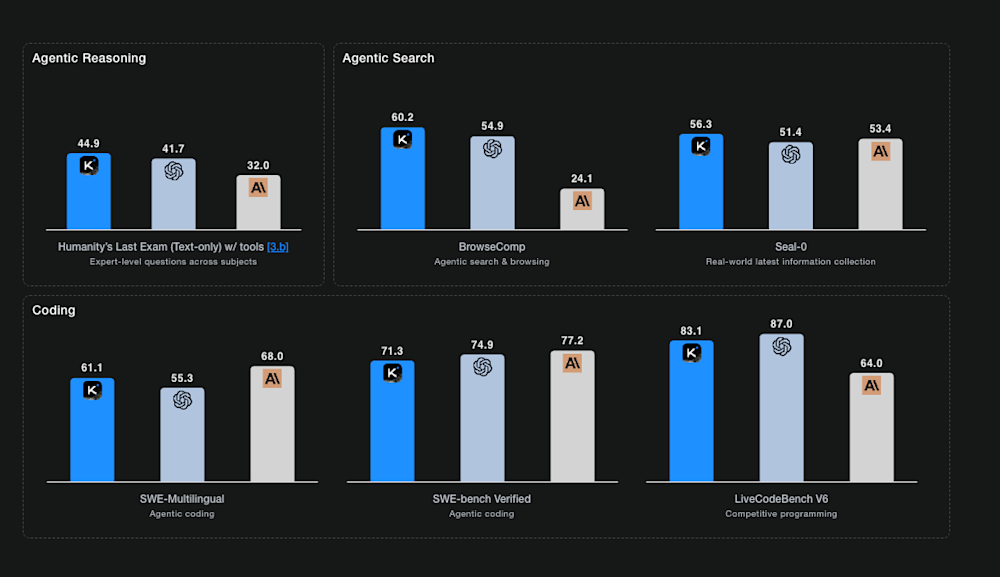
Скриншот результатов тестирования Kimi K2 Thinking в бенчмарках. Источник: Moonshot AI
В этих задачах K2 Thinking стабильно превосходит соответствующие показатели GPT-5 и опережает предыдущего лидера среди моделей с открытыми весами MiniMax-M2, выпущенного всего несколькими неделями ранее китайским конкурентом MiniMax AI.
Открытая модель превосходит проприетарные системы
GPT-5 и Claude Sonnet 4.5 Thinking остаются ведущими проприетарными моделями с функцией «рассуждения».
Тем не менее, в том же наборе бенчмарков показатели агентских рассуждений K2 Thinking превосходят обе системы: например, в BrowseComp результат открытой модели в 60,2 % решительно опережает показатели GPT-5 (54,9 %) и Claude 4.5 (24,1 %).
K2 Thinking также незначительно превосходит GPT-5 в GPQA Diamond (85,7 % против 84,5 %) и сравнивается с ней в задачах математических рассуждений, таких как AIME 2025 и HMMT 2025.
Только в определенных конфигурациях с максимальной нагрузкой (heavy-mode), где GPT-5 агрегирует множество траекторий, проприетарная модель возвращает паритет.
Тот факт, что полностью открытая версия от Moonshot может достигать или превосходить результаты GPT-5, знаменует собой переломный момент. Разрыв между закрытыми передовыми системами и общедоступными моделями фактически стерт в области сложных рассуждений и программирования.
Опережение MiniMax-M2: предыдущего лидера среди открытых исходных кодов
Когда VentureBeat опубликовал материал о MiniMax-M2 всего полторы недели назад, ее приветствовали как «нового короля больших языковых моделей с открытым исходным кодом», добившегося наивысших баллов среди систем с открытыми весами.
Эти результаты приблизили MiniMax-M2 к уровню возможностей GPT-5 в использовании агентских инструментов. Тем не менее, Kimi K2 Thinking теперь затмевает их с большим отрывом.
Ее результат в тесте BrowseComp, равный 60,2 %, превышает показатель M2 в 44,0 %, а оценка SWE-Bench Verified в 71,3 % превосходит 69,4 % у M2. Даже в задачах финансового анализа, таких как FinSearchComp-T3 (47,4 %), K2 Thinking демонстрирует сопоставимую производительность, сохраняя при этом превосходящие возможности общего назначения.
Технически обе модели используют разреженную архитектуру Mixture-of-Experts для повышения эффективности вычислений, но сеть Moonshot активирует больше экспертов и задействует передовое обучение с учетом квантования (INT4 QAT).
Такая конструкция удваивает скорость инференса по сравнению со стандартной точностью без потери точности — это критически важно для сеансов с длинными «токенами размышления» (thinking-tokens), достигающих контекстного окна в 256 тыс. токенов.
Агентские рассуждения и использование инструментов
Определяющей способностью K2 Thinking является ее явный след рассуждений. Модель выводит вспомогательное поле reasoning_content, раскрывающее промежуточную логику перед каждым финальным ответом. Такая прозрачность сохраняет согласованность в длинных многошаговых задачах и при многоэтапных вызовах инструментов.
Эталонная реализация, опубликованная Moonshot, демонстрирует, как модель автономно выполняет рабочий процесс «ежедневного отчета о новостях»: вызывает инструменты даты и веб-поиска, анализирует полученный контент и составляет структурированный результат — и все это с поддержанием внутреннего состояния рассуждений.
Такая сквозная автономность позволяет модели планировать, искать, выполнять и синтезировать данные на протяжении сотен шагов, отражая новый класс систем «агентного ИИ», работающих с минимальным надзором.
Эффективность и доступность
Несмотря на триллионный масштаб параметров, стоимость работы K2 Thinking остается умеренной. Moonshot приводит следующие расценки на использование:
-
$0,15 / 1 млн токенов (попадание в кэш)
-
$0,60 / 1 млн токенов (промах кэша)
-
$2,50 / 1 млн токенов на вывод
Эти тарифы конкурентоспособны даже по сравнению с ценами MiniMax-M2 ($0,30 за вход / $1,20 за выход) и на порядок ниже цен GPT-5 ($1,25 за вход / $10 за выход).
Сравнительный контекст: ускорение моделей с открытыми весами
Быстрая смена лидеров в лице M2 и K2 Thinking иллюстрирует, как стремительно исследования в области открытого кода догоняют передовые системы. MiniMax-M2 продемонстрировала, что открытые модели могут приближаться к возможностям агентного уровня GPT-5 при лишь небольшой доле затрат на вычисления. Компания Moonshot продвинула эту границу еще дальше, выведя открытые веса за рамки паритета в сторону безусловного лидерства.
Обе модели полагаются на разреженную активацию ради эффективности, но большее число активных параметров у K2 Thinking (32 млрд против 10 млрд активных параметров) обеспечивает более высокую точность рассуждений в различных областях. Масштабирование во время инференса (test-time scaling) — увеличение «токенов размышления» и числа обращений к инструментам — обеспечивает измеримый прирост производительности без переобучения, что пока не наблюдалось у MiniMax-M2.
Технические перспективы
Moonshot сообщает, что K2 Thinking поддерживает нативный инференс в формате INT4 и контекст на 256 тыс. токенов с минимальным снижением производительности. Ее архитектура объединяет квантование, параллельную агрегацию траекторий («тяжелый режим») и маршрутизацию Mixture-of-Experts, оптимизированную для задач на рассуждения.
На практике эти оптимизации позволяют K2 Thinking поддерживать сложные циклы планирования (компиляция кода – тест – исправление, поиск – анализ – обобщение) на протяжении сотен вызовов инструментов. Эта способность лежит в основе ее превосходных результатов в тесты BrowseComp и SWE-Bench, где непрерывность рассуждений имеет решающее значение.
Огромные последствия для экосистемы ИИ
Конвергенция открытых и закрытых моделей в премиальном сегменте сигнализирует о структурном сдвиге в ландшафте ИИ. Предприятия, которые раньше полагались исключительно на проприетарные API, теперь могут развертывать открытые альтернативы, соответствующие по уровню рассуждений GPT-5, сохраняя при этом полный контроль над весами, данными и комплаенсом.
Стратегия открытых публикаций Moonshot продолжает прецедент, заданный DeepSeek R1, Qwen3, GLM-4.6 и MiniMax-M2, но распространяет его на полноценные агентские рассуждения.
Для академических и корпоративных разработчиков K2 Thinking обеспечивает как прозрачность, так и интероперабельность — возможность изучать цепочки рассуждений и настраивать производительность под специализированные доменные агенты.
Появление K2 Thinking сигнализирует о том, что Moonshot — молодой стартап, основанный в 2023 году при поддержке крупнейших китайских приложений и технологических компаний — готов соревноваться в условиях усиливающейся конкуренции. Это происходит на фоне растущего внимания к финансовой устойчивости крупнейших игроков рынка ИИ.
Всего день назад финансовый директор OpenAI Сара Фриар вызвала споры после того, как предположила на мероприятии WSJ Tech Live, что правительству США в конечном итоге может потребоваться предоставить «страховку» (backstop) для обязательств компании на сумму более 1,4 триллиона долларов, направленных на вычисления и дата-центры — этот комментарий многие истолковали как призыв к гарантированию кредитов за счет налогоплательщиков.
Хотя Фриар позже уточнила, что OpenAI не добивается прямой федеральной поддержки, этот эпизод возобновил дебаты о масштабах и концентрации капиталовложений в сфере искусственного интеллекта.
На фоне гонки OpenAI, Microsoft, Meta и Google за долгосрочные поставки чипов критические голоса предупреждают о неустойчивом инвестиционном пузыре и «гонке вооружений в сфере ИИ», движимой скорее стратегическим страхом, чем коммерческой отдачей. Этот пузырь может «лопнуть» и утянуть за собой всю глобальную экономику, если возникнут колебания или рыночная неопределенность, учитывая, сколько сделок и оценок было совершено в ожидании непрекращающихся крупных инвестиций в ИИ и колоссальной окупаемости.
На этом фоне релизы открытых весов от Moonshot AI и MiniMax усиливают давление на американские проприетарные ИИ-компании и их спонсоров, вынуждая их оправдывать размеры инвестиций и пути достижения прибыльности.
Если корпоративный клиент может с тем же успехом получить сопоставимую или лучшую производительность от бесплатной китайской ИИ-модели с открытым исходным кодом, чем от платных проприетарных ИИ-решений вроде GPT-5 от OpenAI, Claude Sonnet 4.5 от Anthropic или Gemini 2.5 Pro от Google — зачем продолжать платить за доступ к проприетарным моделям? Тяжеловесы Кремниевой долины, такие как Airbnb, уже вызвали удивление, признавшись, что активно используют китайские альтернативы с открытым исходным кодом, например Qwen от Alibaba, вместо проприетарных предложений OpenAI.
Для инвесторов и предприятий эти события означают, что передовые возможности ИИ больше не являются синонимичным понятием для огромных капитальных затрат. Самые продвинутые системы рассуждений теперь могут создаваться не компаниями, строящими дата-центры гигаваттного масштаба, а исследовательскими группами, оптимизирующими архитектуры и квантование ради эффективности.
В этом смысле доминирование K2 Thinking в бенчмарках — это не просто техническая веха, а стратегическая победа, пришедшая в момент, когда главный вопрос рынка ИИ сместился с того, насколько мощными могут стать модели, на то, кто может позволить себе их содержать.
Что это значит для бизнеса в будущем
Всего через несколько недель после взлета MiniMax-M2 модель Kimi K2 Thinking обошла ее — наряду с GPT-5 и Claude 4.5 — практически во всех бенчмарках рассуждений и агентских тестов.
Модель демонстрирует, что системы с открытыми весами теперь способны соответствовать проприетарным передовым моделям или превосходить их как по возможностям, так и по эффективности.
Для сообщества исследователей ИИ K2 Thinking представляет собой нечто большее, чем просто еще одна открытая модель: это свидетельство того, что рубеж передовых технологий стал пространством для сотрудничества.
Лучшая из доступных сегодня моделей для логических рассуждений — это не закрытый коммерческий продукт, а система с открытым исходным кодом, доступная каждому.




