


Модели Magistral 1.2 от Mistral расширяют возможности ИИ-задач


В последние месяцы в сфере релизов больших языковых моделей (LLM) доминировали два тренда: модели меньшего размера и модели рассуждения.
Первые имеют преимущество, поскольку могут работать на самом разном оборудовании и не требуют подключения к интернету, что полезно для тех, кто заботится о конфиденциальности, безопасности и высоких затратах на запуск. Кроме того, их можно проще и быстрее настраивать под конкретные задачи предприятий.
В то же время модели рассуждения пользуются бешеным успехом с тех пор, как в прошлом году дебютировала серия «o» от OpenAI, и по-настоящему выстрелили благодаря DeepSeek R1 в январе. Тем не менее, базовый принцип для всех этих типов LLM заключается в том, что они анализируют свои результаты и пытаются выполнить самокоррекцию перед тем, как ответить пользователю, стремясь повысить точность и производительность, особенно при решении более сложных и многоэтапных задач, таких как составление отчета в рамках «глубокого исследования».
Теперь французский ИИ-стартап Mistral выпустил новую пару моделей, которые используют оба этих тренда.
В своем заявлении в X компания сообщила, что новые LLM Magistral Small 1.2 и Magistral Medium 1.2 являются «незначительными» обновлениями ее серии Magistral 1.1.
Но эти обновления могут оказаться более значительными, чем этот хорошо финансируемый европейский любимец в сфере ИИ афиширует: обе модели оснащены визуальным кодировщиком, позволяющим им анализировать изображения, предоставленные пользователями. Кроме того, обе они предлагают улучшение производительности в ключевых бенчмарках, а также расширенные функции удобства использования.
Возможно, самое впечатляющее то, на что указал руководитель направления роста ML в Hugging Face Ахсен Халик (@_akhaliq в X): версия Magistral Small 1.2 с 24 миллиардами параметров — при квантовании (когда ее внутренние настройки представляются меньшим количеством битов для экономии пространства и снижения энергопотребления ценой некоторого снижения точности) — может даже «развертываться локально, помещаясь в одну [видеокарту Nvidia] RTX 4090 или в MacBook [Apple] с 32 ГБ оперативной памяти…»
Халик также обновил свое веб-приложение для вайб-кодинга на Hugging Face, AnyCoder, сделав Magistral Medium 1.2 моделью LLM по умолчанию для этого приложения.
Код уже доступен для скачивания через Hugging Face, а общаться с моделями напрямую в Интернете можно на сайте чат-бота Mistral и конкурента ChatGPT — Le Chat.
Для разработчиков модели доступны через API Mistral под именами «magistral-small-2509» и «magistral-medium-2509» соответственно.
В конечном счете, если вы разработчик на крупном предприятии, независимый разработчик или исследователь, эти модели заслуживают внимания в качестве вариантов для решения задач, связанных с обработкой текста, математикой, программированием, рассуждениями и анализом изображений — например, для написания описаний и подписей к изображениям (alt-text) при публикации контента.
Сравнение цен на API
Стоимость API Mistral составляет $2 за миллион входных токенов и $5 за миллион выходных токенов для Magistral Medium, а для Magistral Small — $0.50 за входные и $1.50 за выходные токены на миллион. Вот как это выглядит в сравнении с другими решениями.
-
Magistral Small ($0.50 за вход / $1.50 за выход) стоит дешевле многих предложений среднего уровня (например, Anthropic Sonnet), но дороже, чем самый легкий «чатовый» режим DeepSeek для входных токенов. Что касается вывода, модель конкурентоспособна, но DeepSeek по-прежнему сохраняет более низкую стоимость для базового вывода в некоторых режимах.
-
Magistral Medium ($2 / $5) занимает промежуточное положение между средне-легким и средне-тяжелым уровнями у большинства провайдеров. Она значительно дешевле моделей высшего уровня (Opus, полномасштабная GPT-5 от OpenAI и др.), но заметно дороже сверхлегких вариантов.
-
DeepSeek выглядит самым экономичным по многим параметрам, особенно для входных токенов, где помогает кэширование. Если у вас большой объем входящих данных (промпты, контекст документов), но вывод относительно небольшой, «чатовый» режим DeepSeek может обойтись значительно дешевле.
-
Anthropic в сегменте высокой производительности (Opus и т. д.) обходится довольно дорого, особенно со стороны генерации текста (вывода).
-
Ценовая политика Alibaba / Qwen более вариативна; для некоторых моделей Qwen затраты на ввод относительно низкие, но стоимость вывода может масштабироваться в зависимости от используемого варианта.
Продолжение летнего релиза
Mistral представила семейство моделей Magistral в июне 2025 года в качестве своего первого шага в область ИИ, ориентированного на рассуждения. Первоначальная линейка включала проприетарную Magistral Medium для корпоративных клиентов и полностью открытую Magistral Small с лицензией Apache 2.0.
Эта стратегия двойного релиза была направлена на то, чтобы сбалансировать коммерческую жизнеспособность с доступностью для сообщества. Magistral Small стала прямым сигналом о том, что Mistral подтверждает свою приверженность идеям открытого исходного кода, особенно после критики в адрес более ранних закрытых релизов, таких как Medium 3.
Бенчмарки периода запуска показали, что модели Magistral конкурентоспособны в задачах программирования и математики, причем Magistral Medium набрала более 90% в AIME-24 при использовании метода мажоритарного голосования.
Ее архитектура делала упор на прослеживаемые цепочки рассуждений, многоязычную беглость и высокую пропускную способность токенов — функции, ориентированные на отрасли, где важны проверяемость и производительность.
Измеримый прирост производительности, подтвержденный бенчмарками
С выпуском обновлений версии 1.2 компания Mistral AI предлагает не просто прирост производительности — она достигает высших баллов в различных публичных бенчмарках, как это наглядно показано в последних сравнительных диаграммах.
В математическом бенчмарке AIME24 модель Magistral Medium 1.2 набирает 91.82%, лишь ненамного опережая Deepseek-R1 (91.40%) и с большим отрывом превосходя Magistral Medium 1.0 (73.59%).
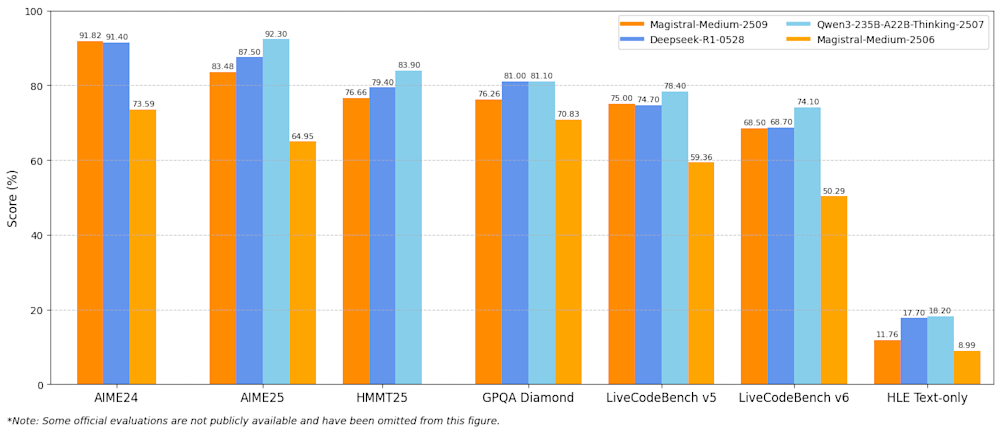
Диаграмма бенчмарков Magistral Medium-1.2. Источник: Mistral
Аналогичные улучшения наблюдаются и в других задачах:
-
AIME25: 83.48% для Magistral Medium 1.2, что превосходит Deepseek (79.4%) и Medium 1.0 (64.95%)
-
HMMT25: 76.66% по сравнению с 64.95% ранее
-
GPQA Diamond: 76.26% против 70.83% в версии v1.0 и немного отстает от Deepseek (81%)
-
LiveCodeBench v5: 75.00%, скачок с 59.36% в версии v1.0
-
LiveCodeBench v6: 68.50%, что значительно выше 50.29% у Medium 1.0
-
HLE Text-only (оценка высокого уровня): 11.76%, почти на 3 пункта выше версии 1.0 (8.99%)
Хотя Qwen3-235B-A22B-Thinking с небольшим отрывом лидирует в HMMT25, GPQA Diamond и LiveCodeBench v6, модель Magistral Medium 1.2 уверенно держит позиции и стабильно превосходит свои предыдущие версии, а также большинство конкурентов в тестах AIME и LiveCode.
Magistral Small 1.2 также демонстрирует явный прирост по сравнению с версиями 1.0 и 1.1 и успешно конкурирует со значительно более крупными моделями.
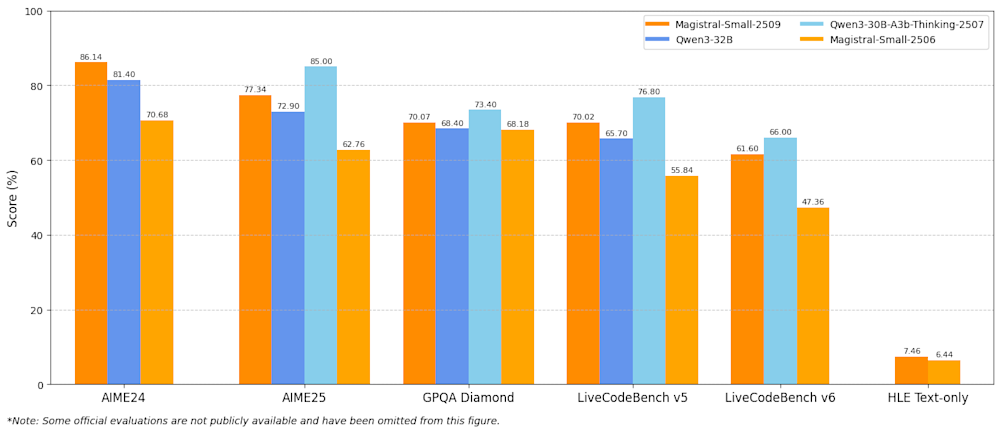
Бенчмарки производительности Magistral Small-1.2. Источник: Mistral
Основные сравнения в бенчмарках:
-
AIME24: 86.14% по сравнению с 81.40% у Qwen3-32B и 70.68% у Small 1.0
-
AIME25: 77.34% по сравнению с 72.90% у Qwen3-32B и 62.76% у Small 1.0
-
GPQA Diamond: 70.07%, что немного опережает Qwen3-32B (68.40%) и Small 1.0 (68.18%)
-
LiveCodeBench v5: 70.02%, рост с 55.84%
-
LiveCodeBench v6: 61.60%, рост с 47.36%
-
HLE Text-only: 7.46% по сравнению с 6.44% в предыдущей версии
Хотя модель Qwen3-30B-A3b-Thinking лидирует в некоторых задачах, таких как AIME25 и GPQA, Magistral Small 1.2 неизменно превосходит своего предшественника и конкурентов вроде Qwen3-32B, особенно в бенчмарках, связанных с программированием, таких как LiveCodeBench.
Мультимодальные входы и визуальные рассуждения
Главной особенностью обновлений 1.2 стала поддержка мультимодальных входов.
Обе модели теперь оснащены визуальным кодировщиком, который позволяет им интерпретировать и анализировать информацию в виде текста и изображений.
Это нововведение расширяет спектр задач, с которыми могут справляться модели, включая визуальные ответы на вопросы, интерпретацию схем кода и анализ макетов.
Улучшенные рассуждения, форматирование и использование инструментов
В версии 1.2 компания Mistral делает акцент на улучшении структуры рассуждений и форматирования вывода. Ответы стали более естественными и лаконичными, особенно для простых запросов. Улучшена поддержка LaTeX и Markdown, что снижает трудности для разработчиков, работающих над техническими задачами.
Модели также лучше справляются с использованием внешних инструментов, таких как поиск в интернете, интерпретаторы кода и генераторы изображений, демонстрируя более продуманную логику относительно того, когда и как эти инструменты применять.
В обеих моделях появились специальные токены [THINK] и [/THINK], обрамляющие цепочки рассуждений для удобства проверки разработчиками. Такое проектное решение структурирует ответы модели, разделяя их на внутренние рассуждения и финальный ответ, что полезно для отслеживаемости и отладки.
Лицензирование, развертывание и интеграция
Для обеих моделей сохраняется лицензия Apache 2.0, позволяющая использовать их в любых коммерческих и некоммерческих целях без ограничений. Это делает их полезным вариантом для предприятий, особенно для тех, у кого есть соображения безопасности или сомнения по поводу использования множества новых китайских моделей с открытым исходным кодом, появившихся за последнее лето.
Mistral также обеспечивает совместимость с несколькими фреймворками и инструментами, включая:
Рекомендуемые параметры для оптимального использования включают в себя:
Многоязычная поддержка
Модели Magistral 1.2 поддерживают более двух десятков языков, включая французский, немецкий, арабский, японский и китайский, и спроектированы так, чтобы сохранять высокое качество ответов в рамках контекстного окна до 128 тыс. токенов. Тем не менее, Mistral отмечает, что оптимальная производительность достигается при объеме менее 40 тыс. токенов.
Это открывает возможности для таких сценариев использования, как анализ документов, проверка больших объемов кода и генерация многоязычных диалогов, что еще больше расширяет потенциальные сферы применения модели.
Выпустив Magistral 1.2, Mistral продолжает свою стратегию двойного направления: предоставление открытых, эффективных моделей для разработчиков при одновременном масштабировании готовых для бизнеса инструментов с измеримыми преимуществами в рассуждениях, производительности и гибкости. Результаты бенчмарков говорят о стабильном прогрессе и более прочных конкурентных позициях в меняющемся ландшафте LLM.
Дайте знать, если вам потребуется адаптировать этот материал для другого канала (например, для внутренней рассылки, текста на лендинге или краткой справки для инвесторов) или извлечь конкретные таблицы и диаграммы для включения в публикацию.




