


ARE и Gaia2 от Meta переосмысляют тестирование агентов


Постоянная проблема при оценке агентов заключается в том, как измерить их производительность в сценариях реального мира.
Несмотря на то, что другие бенчмарки пытаются решить эту проблему, исследователи из Meta считают, что для агентов необходим более реалистичный метод оценки, который проверяет их адаптивность в жизненных сценариях.
Представляем новую платформу оценки от Meta — Agents Research Environment (ARE), а также новую модель бенчмарка в ее составе под названием Gaia2. ARE «поддерживает запуск оркестраций, создание сред и подключение синтетических или реальных приложений для разработки и оценки агентов».
Тем временем Gaia2, являющаяся обновлением более раннего бенчмарка агентов Gaia от Meta, измеряет производительность агентов в среде ARE.
Идея Meta заключается в том, что существующим средам тестирования для агентов часто приходится догонять прогресс, поэтому оценщикам постоянно нужно подстраивать бенчмарки.
«Мы исходим из того, что улучшение моделей посредством опыта и развертывания в рабочей среде ограничено управляемостью, разнообразием и реалистичностью доступных сред. Во-первых, хотя веб является отличной средой для поддержки таких задач агентов, как поиск, он постоянно развивается, что затрудняет воспроизводимость для оценки и изучения сложного поведения, в особенности того, которое связано с операциями записи», — говорится в документе Meta.
Исследовательские среды
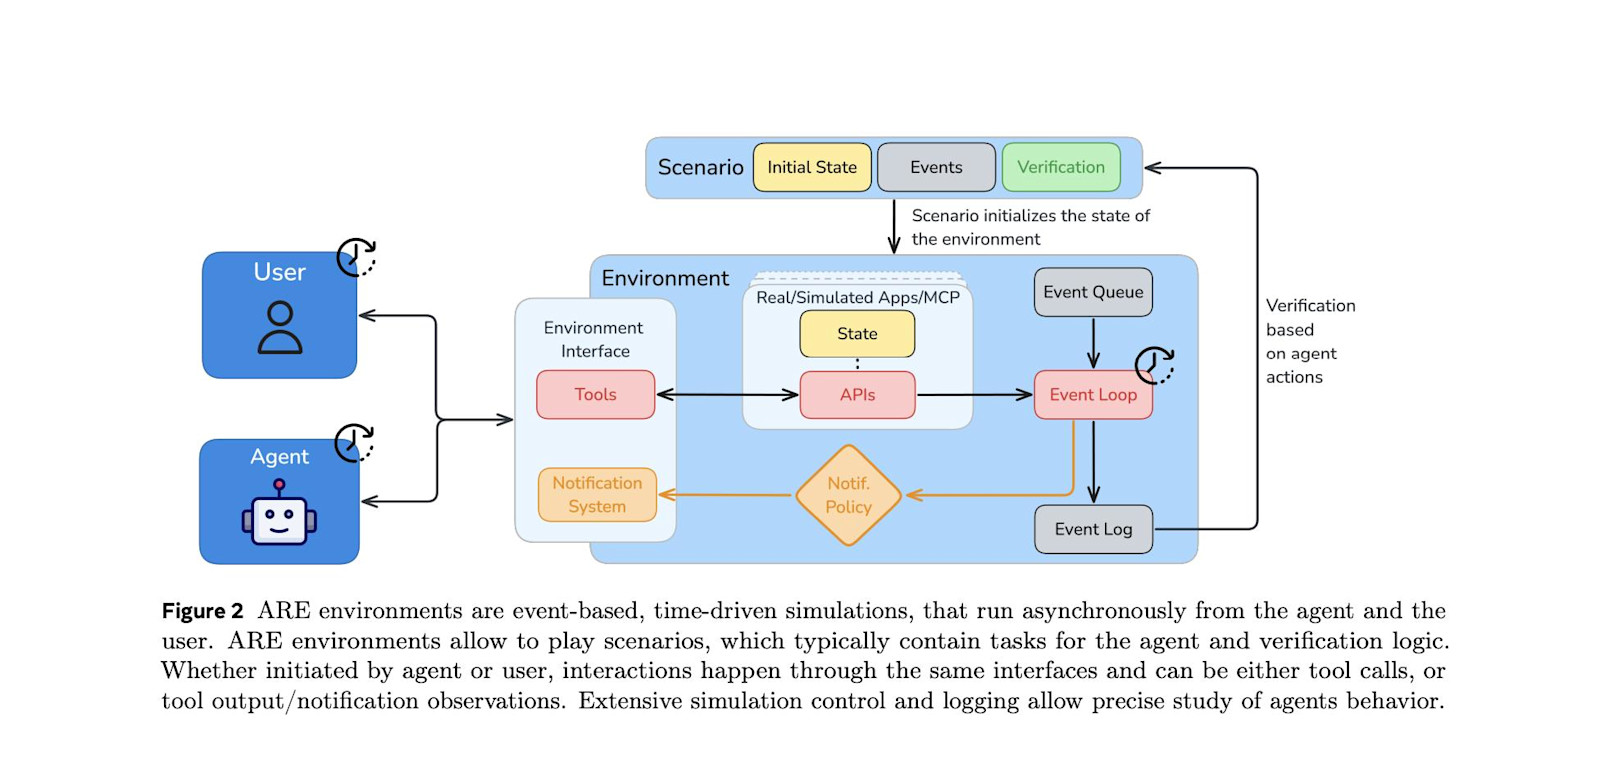
Идея, лежащая в основе ARE, заключается в том, что это среда, устроенная подобно реальному миру, с которым агенту придется взаимодействовать. Задачи в ARE будут асинхронными, реальное время будет идти, и агенты, развернутые в этой среде, должны будут адаптироваться и работать с учетом этих ограничений.
Она имеет пять ключевых основ:
-
Приложения, представляющие собой интерфейсы API с сохранением состояния, которые обращаются к источникам данных (например, почтовые приложения, имеющие такие инструменты, как send_email)
-
Среды, или совокупность приложений, данных и правил
-
События — это все, что происходит в среде
-
Уведомления, или сообщения, которые информируют агента о событиях, и
-
Сценарии, которые выступают в качестве начального состояния и событий в среде и могут включать механизм верификации
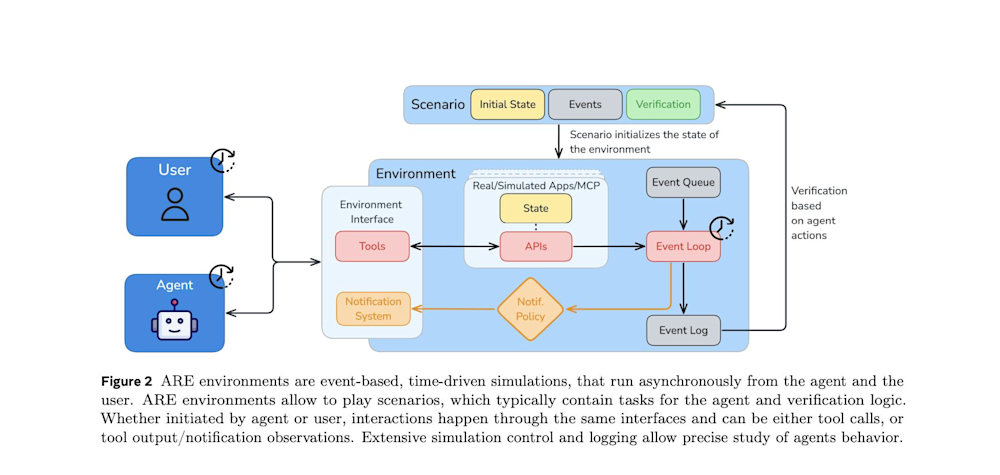
Предприятие, желающее оценить агента, может построить такой тестовый сценарий на базе ARE — фреймворка с открытым исходным кодом, который Meta предлагает на GitHub и который включает ядро симуляции, примеры сред и оркестрацию по умолчанию. Они могут либо создать собственную среду, либо использовать уже предзагруженную, предварительно определив приложения, с которыми будут взаимодействовать агенты. Затем предприятия настраивают сценарии для агента перед подключением тестируемых агентов. После этого они запускают свою логику оркестрации и настраивают верификатор.
Бенчмарки Gaia2
Важнейшим элементом полезности ARE является бенчмарк Gaia2. Gaia2 создан на базе ARE и измеряет возможности агентов, в отличие от Gaia1, которая тестировала способность агента находить ответы.
Он исследует, как агенты ведут себя в среде ARE, и сравнивает то, как они справляются с меняющимися условиями, соблюдают дедлайны, обрабатывают сбои API и уточняют задачи, когда инструкции неясны. Gaia2 поддерживает несколько протоколов, таких как Agent2Agent, чтобы также оценивать способность агента к сотрудничеству. В нем используется фреймворк LLM-as-a-judge («большая языковая модель в качестве судьи»).
Поскольку оценки в ARE выполняются асинхронно, а время продолжает идти, даже когда агент не активен, Gaia2 может измерять, реагирует ли простаивающий агент при отправке нового события.
Тестирование агентов проводилось в мобильной среде на примере 1 120 задач.
Судя по текущим тестам и публикации генерального директора Hugging Face Клема Деланга (Clem Delangue), модель GPT-5 от OpenAI в настоящее время лидирует в бенчмарке Gaia2.
Бенчмарк Gaia2 уже завоевывает популярность.
Агенты и жизненные сценарии
Предприятия хотят быть уверены, что их агенты действительно работают, но в рамках статических тестов, которые на самом деле не отражают реальную деятельность агентов, это может оказаться сложной задачей.
Недавно было выпущено несколько бенчмарков и средств оценки, призванных предоставить смоделированные среды из реальной жизни. Платформа Hugging Face под названием Yourbench позволяет предприятиям создавать собственные среды тестирования на основе реальных данных. В то же время MCPEval от Salesforce выпускает агентов в реальные MCP-серверы, которые не зависят от статических заранее определенных сценариев. Платформа Inclusion Arena от компании Inclusion AI также измеряет производительность агентов в сценариях реального мира.
Тем не менее, Gaia2 отличается тем, что проверяет адаптивность и устойчивость к «шуму». Например, Inclusion Arena оценивает человеческие предпочтения и то, насколько точно агент следует инструкциям. MCPEval, с другой стороны, измеряет способность агентов вызывать инструменты.
ARE и Gaia2 предлагают предприятиям еще один способ оценки производительности агентов, позволяя увидеть, насколько надежен агент при возникновении непредвиденного события.




