


LongCat-Flash от Meituan бросает вызов GPT-5


Сегодня у предприятий по всему миру нет недостатка в мощных китайских открытых больших языковых моделях (LLM), которые можно брать, скачивать, модифицировать/настраивать и развертывать в коммерческих целях.
И вот появляется еще одно семейство открытых моделей, заслуживающее внимания: Meituan, китайское приложение для доставки еды и электронной коммерции, привлекло внимание экспертов по искусственному интеллекту по всему миру в конце августа 2025 года, выпустив свою первую открытую LLM LongCat-Flash (также известную как LongCat-Flash-Chat), базовую модель на основе смеси экспертов (MoE) с 560 миллиардами параметров.
Затем, на этой неделе, компания выпустила LongCat-Flash-Thinking — крупномасштабную открытую модель рассуждения, призванную раздвинуть границы решения сложных задач в области ИИ; она создана на базе фундаментальной модели LongCat-Flash и включает в себя пайплайн обучения, специально настроенный для продвинутого логического вывода.
Meituan также предоставила свободный доступ к LongCat-Flash-Thinking через свой API (до 500 000 токенов в день с возможностью расширения до 5 миллионов, также бесплатно!). Тем не менее, западным и американским компаниям с точки зрения безопасности и геополитики может быть выгоднее скачать модели с сайта совместного использования кода ИИ Hugging Face или Github, где они также находятся в свободном доступе, и запускать их локально на собственном оборудовании либо в виртуальных частных облаках/на мощностях американских облачных провайдеров.
Один из обозревателей уже заявляет, что она составляет конкуренцию флагманской проприетарной модели OpenAI — GPT-5, и при этом распространяется абсолютно бесплатно.
В совокупности эти релизы образуют единую экосистему, охватывающую исследовательские инновации, эффективность развертывания и широкую доступность. Все они доступны по мягкой и дружественной к бизнесу лицензии MIT, которая разрешает модификацию и коммерческое использование (при условии, что предприятие/пользователь также включает копию лицензии).
Для компаний в Китае, США и по всему миру это предоставляет еще одну мощную связку открытых LLM, которую стоит рассмотреть для развертывания в рамках собственной операционной деятельности.
Что такое Meituan и почему компания переходит от доставки еды к LLM?
Компания Meituan, основанная в марте 2010 года серийным предпринимателем Ван Сином, превратилась из сайта скидок в стиле Groupon в одно из доминирующих в Китае «суперприложений», объединяющих локальные услуги, розничную торговлю и логистику.
В 2015 году компания объединилась с Dianping, чтобы укрепить свои позиции в сфере потребительских отзывов и локальных услуг, а в 2020 году вернулась к бренду «Meituan». Штаб-квартира Meituan находится в Пекине; акции компании котируются на Гонконгской фондовой бирже под тикером 3690.HK и входят в состав индекса Hang Seng.
Сегодня бизнес Meituan охватывает доставку еды, услуги внутри торговых точек, мгновенную розничную торговлю (продукты питания и товары народного потребления), бронирование отелей и путешествий и многое другое. Компания заявляет, что ее клиентская база насчитывает более 770 миллионов активных пользователей в год, а на ее платформе работает более 14,5 миллионов продавцов.
Ее масштаб и логистическая инфраструктура обеспечивают ей почти монопольное положение во многих городских зонах доставки. С финансовой точки зрения Meituan столкнулась с серьезным сужением маржи и резким падением прибыли на фоне жесткой внутренней конкуренции. Компания также публично пообещала инвестировать «миллиарды» в искусственный интеллект и разработку чипов по мере перехода к более технологичным продуктам.
Первоначальный релиз: LongCat-Flash
Упомянутые инвестиции в ИИ и соответствующий фокус уже приносят плоды: 30 августа компания Meituan выпустила LongCat-Flash — большую язычную модель с открытым исходным кодом, построенную на архитектуре «смеси экспертов» (MoE).
Несмотря на номинальное количество параметров в 560 миллиардов, архитектура LongCat динамически задействует лишь от 18,6 до 31,3 миллиарда параметров на один токен (в среднем около 27 миллиардов), что позволяет соблюсти баланс между масштабом и эффективностью.
В ней также используются такие инновации, как «эксперты с нулевыми вычислениями» и структура MoE с пропускными соединениями (ScMoE) для управления издержками на коммуникацию и оптимизации масштабного обучения. Подробнее о них ниже:
-
Эксперты с нулевыми вычислениями в блоках MoE, которые позволяют системе выделять вычислительный бюджет только там, где это необходимо.
-
MoE с пропускными соединениями (ScMoE): совмещение вычислений и коммуникации для устранения узких мест масштабирования.
-
Экспертное смещение с ПИД-регулированием (PID-controlled expert bias): поддержание стабильной средней активации между токенами.
-
Механизмы эффективности обучения: включая перенос гиперпараметров из прокси-моделей, детерминированные вычисления для защиты от скрытого повреждения данных и усовершенствованную стратегию инициализации.
По результатам бенчмарков LongCat-Flash-Chat демонстрирует конкурентоспособные или превосходящие показатели в выполнении инструкций, рассуждении, генерации кода и агентских задачах.
Flash-Chat показала результаты, сопоставимые с признанными проприетарными системами. Модель набрала 89,7% в MMLU, 96,4% в MATH500 и 73,2% в GPQA-diamond, при этом продемонстрировав выдающиеся результаты в использовании агентских инструментов, например 73,7% в τ²-Bench Telecom, опередив несколько более крупных закрытых моделей. Важно отметить, что скорость инференса превышала 100 токенов в секунду, что обеспечило баланс между производительностью и практичностью развертывания.
Для Meituan модель LongCat знаменует собой стремление внедрить передовые возможности ИИ в свои основные направления коммерции, логистики и платформенных услуг, а также позиционировать себя не просто как гиганта доставки, но как передового технологического игрока в гонке ИИ в Китае.
Отчет о развертывании: оптимизация масштабируемости
Два дня спустя, 1 сентября 2025 года, Meituan опубликовала подробный технический отчет, посвященный развертыванию LongCat-Flash в больших масштабах с использованием SGLang. В отчете рассматривались две проблемы: пропускная способность и задержка в крупных MoE-моделях. Отмечалось, что традиционные стратегии часто заставляли идти на компромисс между этими двумя параметрами.
Ключевые инновации при развертывании:
-
PD-разделение (PD Disaggregation): отделение фазы префиллинга от фазы декодирования, что сокращает время до получения первого токена при интерактивных рабочих нагрузках.
-
Перекрытие одиночных батчей (Single Batch Overlap, SBO): четырехэтапный конвейер выполнения, который накладывает ресурсоемкие коммуникационные операции (диспетчеризацию all-to-all и объединение) на плотные вычисления, маскируя задержки в пределах одного батча.
-
Широкий параллелизм экспертов (Wide Expert Parallelism): увеличение параллелизма и размеров батчей при использовании перекрытия для компенсации накладных расходов на коммуникацию.
-
Многошаговое планирование с перекрытием: повышение коэффициента использования графического процессора путем объединения нескольких прямых проходов в один цикл планирования.
-
Прогнозирование нескольких токенов (Multi-Token Prediction, MTP): использование легковесной плотной «головы» и объединение ядер верификации для оптимизации спекулятивного декодирования.
В результате получилась система, способная работать со скоростью более 100 токенов в секунду на кластерах NVIDIA H800, причем стоимость одного токена составила менее половины от стоимости некоторых более мелких аналогов. Объединив высокую пропускную способность и низкую задержку, компания Meituan сделала LongCat-Flash пригодной для развертывания в средах, где критически важны как эффективность, так и скорость отклика.
Представлена модель LongCat-Flash-Thinking с продвинутыми возможностями логического вывода
Самый значительный прорыв произошел 23 сентября 2025 года с представлением LongCat-Flash-Thinking — варианта семейства моделей Flash, адаптированного для решения сложных задач на рассуждение.
Согласно техническому отчету Meituan о новой модели, если Flash-Chat создавалась как мощная универсальная базовая система, то Flash-Thinking была специализирована с помощью двухэтапного процесса обучения:
-
Обучение рассуждению с «холодного старта» (Cold-Start Reasoning Training):
Команда использовала методическое обучение (curriculum learning) для формирования способности к пошаговым рассуждениям (chain-of-thought), подкрепленное контролируемой тонкой настройкой на датасетах, насыщенных задачами по логике, математике и агентскими кейсами. -
Масштабное обучение с подкреплением (Large-Scale Reinforcement Learning):
Используя фреймворк DORA (динамическая оркестрация для асинхронного развертывания), Flash-Thinking внедрила доменно-параллельную схему обучения. Отдельные модели оптимизировались по направлениям STEM (естественные науки, технологии, инженерия, математика), программирования и агентских задач, прежде чем быть объединенными в единую систему, близкую к оптимальной по Парето. Затем последовала общая доработка с помощью обучения с подкреплением для повышения надежности и согласованности (alignment).
Бенчмарки и производительность
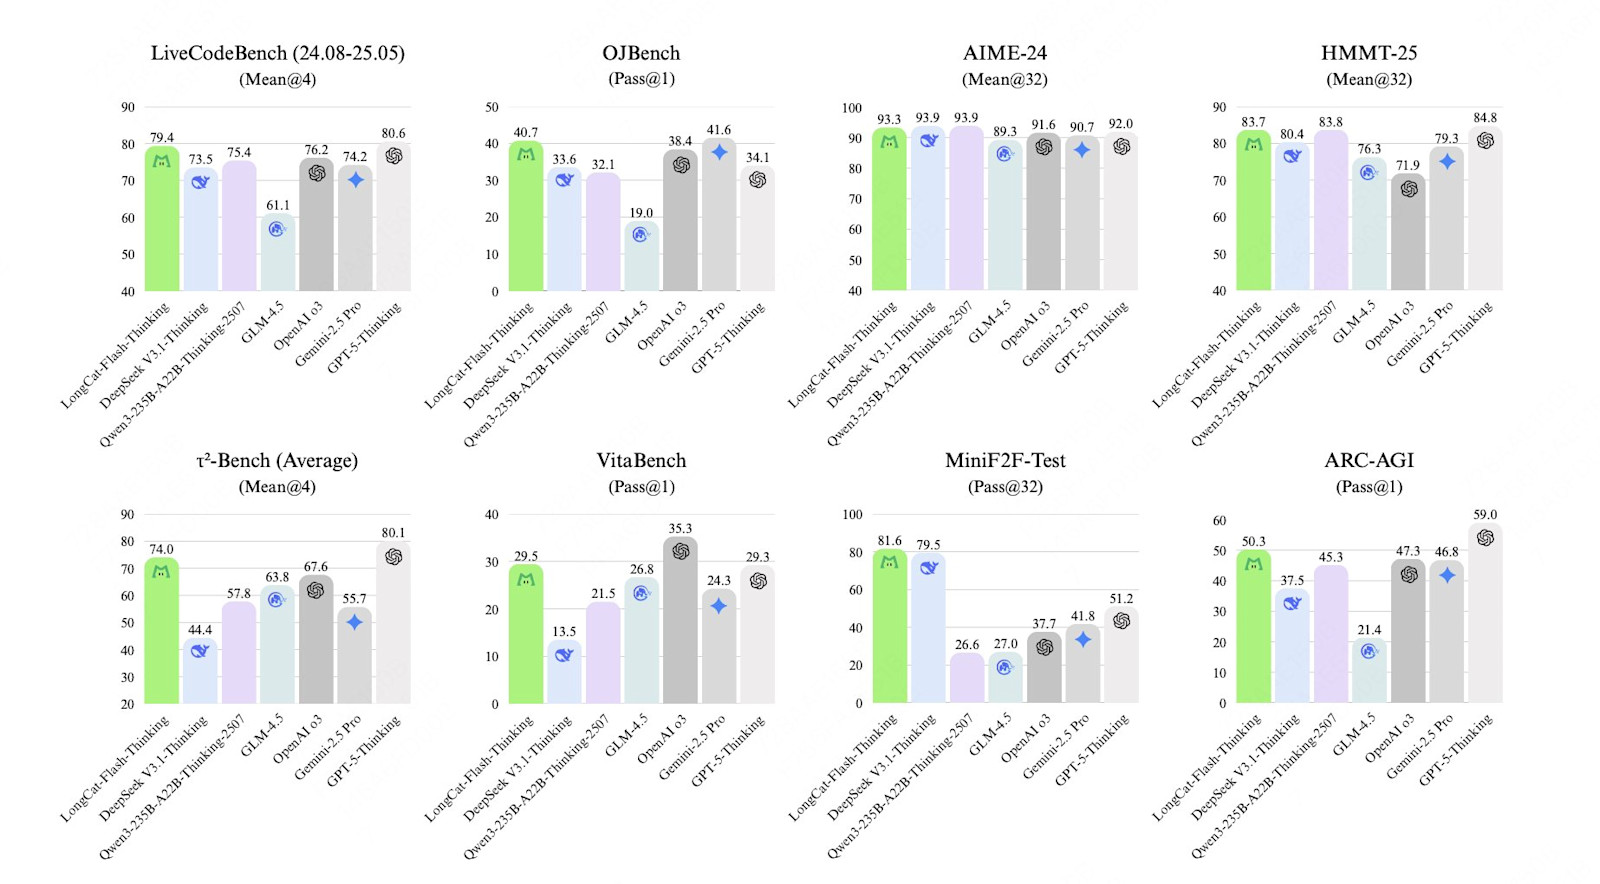
Оценки ставят LongCat-Flash-Thinking в один ряд с самыми сильными моделями рассуждения с открытым исходным кодом на сегодняшний день, которые зачастую приближаются к производительности проприетарных систем, таких как GPT-5-Thinking, OpenAI-o3 и Gemini 2.5-Pro, или даже превосходят их.
В математических рассуждениях Flash-Thinking демонстрирует выдающиеся результаты. Она достигает 99,2% на MATH500, фактически находясь на одном уровне с GPT-5 и опережая как OpenAI-o3, так и Gemini 2.5-Pro.
В бенчмарке VitaBench, оценивающем логическое мышление в области биомедицины и наук о жизни, Flash-Thinking набирает 29,5 балла, незначительно опережая GPT-5 с ее 29,3 балла.
В бенчмарках конкурсного уровня, таких как AIME25 и HMMT25, она немного отстает от GPT-5, но все же опережает большинство других аналогов, что подчеркивает ее способность эффективно справляться со сложными количественными задачами.
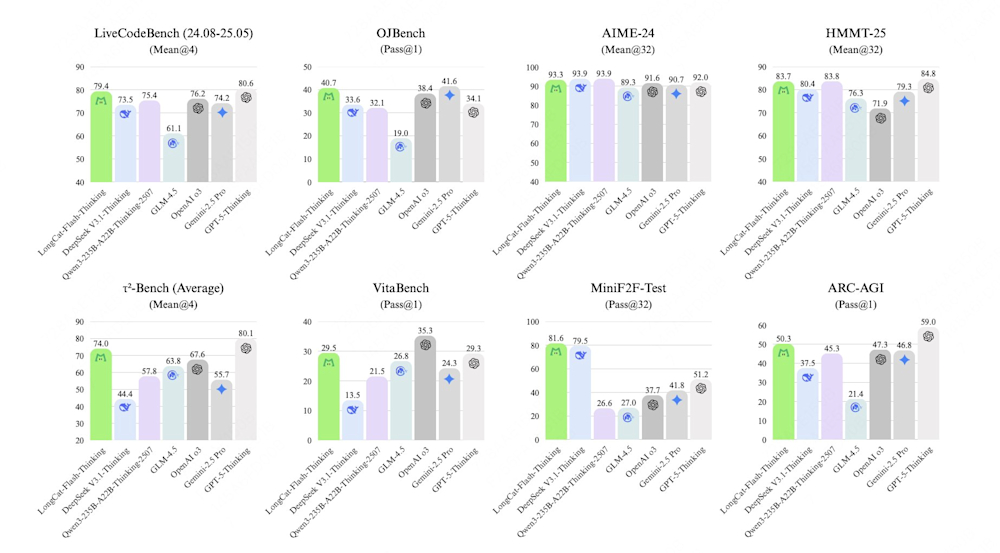
Результаты тестирования Meituan LongCat-Flash-Thinking в бенчмарках. Источник: Meituan
Модель также демонстрирует высокие результаты в общих рассуждениях. В бенчмарке GPQA-Diamond она располагается близко к GPT-5 и OpenAI-o3, а в тесте ARC-AGI обходит как OpenAI, так и Gemini, пусть пока и не дотягивая до более высокого балла GPT-5.
Задачи программирования демонстрируют аналогичную картину: Flash-Thinking набирает 79,4% в LiveCodeBench, отставая от GPT-5 всего на один процент и опережая другие ведущие модели, а результаты OJBench также подтверждают ее конкурентоспособность в высшей лиге.
Производительность в использовании агентских инструментов выглядит более неоднородно. Flash-Thinking показывает высокие результаты в серии тестов τ²-Bench, включая 83,1% в Telecom (лучший результат среди систем с открытым весом), хотя GPT-5 сохраняет явное лидерство в этой категории. Тем не менее, эти результаты свидетельствуют о серьезном прогрессе в рассуждениях с использованием инструментов и адаптации к реальным агентским задачам.
В чем Flash-Thinking действительно выделяется, так это в формальном доказательстве теорем. На платформе MiniF2F она достигает 81,6% при показателе pass@32, значительно превосходя 51,2% у GPT-5 и устанавливая новый стандарт среди открытых моделей. Даже при более строгих критериях оценки модель сохраняет уверенное лидерство, доказывая, что стратегия доменно-параллельного обучения с подкреплением дает осязаемые преимущества в задачах, требующих интенсивной логики.
Показатели безопасности дополнительно подчеркивают возможности модели. Flash-Thinking достигает 93,7% в фильтрации вредоносного контента и 93,0% в обнаружении дезинформации — оба показателя значительно выше, чем у GPT-5 и ее аналогов, при сохранении сопоставимого уровня защиты конфиденциальности. Эти результаты позволяют предположить, что модель не только не уступает проприетарным системам в ключевых областях рассуждения, но и демонстрирует более надежную защиту от нецелевого использования.
В совокупности эти бенчмарки рисуют картину модели, которая на равных конкурирует с GPT-5 в математике и программировании, превосходит ее в доказательстве теорем и безопасности, а также сокращает разрыв в более широких рассуждениях и использовании агентских инструментов.
Важный показатель эффективности заключается в том, что Flash-Thinking снизила потребление токенов на 64,5% в тесте AIME-25 по сравнению с базовыми моделями рассуждения, сократив среднее количество токенов с 19 653 до 6 965 без потери точности.
Расширение доступа: API и квоты для разработчиков
Наряду с техническим релизом, Meituan объявила о расширении доступа к API для модели Flash-Thinking, сделав ее пригодной не только для исследовательских скачиваний. Теперь разработчики могут:
-
Получить доступ к модели с дневной бесплатной квотой в 500 000 токенов (ранее лимит составлял 100 000).
-
Подать заявку на получение 5 миллионов токенов в день для работы с большими объемами (требует одобрения).
-
Интегрировать модель с конфигурациями Claude Code, расширяя совместимость с устоявшимися средами разработки.
-
Использовать обновленную документацию, включая руководство по быстрому старту, список изменений и раздел часто задаваемых вопросов (FAQ).
Платформа API дополняет дистрибуцию весов моделей на Hugging Face и репозитории GitHub как для Flash, так и для Flash-Thinking, создавая различные точки входа для разработчиков разного масштаба.
Создание экосистемы LongCat
В совокупности августовские и сентябрьские релизы иллюстрируют системный подход компании Meituan:
-
Фундамент: LongCat-Flash-Chat, создание производительной и эффективной базовой модели, обученной на огромных массивах данных.
-
Инженерия: оптимизация развертывания с помощью SGLang, делающая крупномасштабные MoE-модели пригодными для интерактивных и пакетных рабочих нагрузок.
-
Специализация на рассуждениях: LongCat-Flash-Thinking, продвижение передовых технологий в области открытых рассуждений, доказательства теорем и использования агентских инструментов.
-
Доступность: запуск API со щедрыми бесплатными квотами, стимулирующий эксперименты и внедрение среди разработчиков.
Каждый этап опирался на предыдущий, переходя от исследовательского релиза к стратегии развертывания, затем к специализированному обучению и, наконец, к открытому доступу.
Что это значит для лиц, принимающих технические решения на уровне предприятия?
Meituan позиционирует LongCat как открытую экосистему под лицензией MIT, одновременно предупреждая, что эти модели не настроены под абсолютно любое прикладное применение.
Разработчикам настоятельно рекомендуется оценивать безопасность, беспристрастность и соответствие предметной области перед развертыванием в чувствительных средах.
Тем не менее, благодаря открытым весам, технической прозрачности, стратегиям развертывания на уровне систем и широкой доступности API, модель LongCat представляет собой одну из самых комплексных инициатив с открытым исходным кодом на передовом рубеже крупномасштабных моделей рассуждения.
Для инженеров по искусственному интеллекту, отвечающих за управление жизненным циклом больших языковых моделей, специализированные на рассуждениях системы, такие как Flash-Thinking, оказывают непосредственное влияние на повседневные рабочие процессы, сокращая расход токенов более чем вдвое без ущерба для точности. Это означает меньшие затраты ресурсов на инференс, более быстрые итерации при прототипировании и возможность удовлетворять бизнес-потребности без резкого масштабирования инфраструктурных затрат. На практике это ведет к сокращению времени на устранение узких мест в вычислениях и увеличению времени на адаптацию моделей под конкретные задачи продукта.
Для специалистов, работающих над оркестрацией ИИ и операционными пайплайнами, эти модели могут легче встраиваться в существующие мультимодельные среды, сохраняя при этом способность к логическому выводу высшего уровня. Их ценность заключается в стабильности и масштабируемости. Стратегия доменно-параллельного обучения с подкреплением, использованная в Flash-Thinking, указывает на более предсказуемое поведение модели при решении специализированных задач, что позволяет снизить сложность валидации и мониторинга пайплайнов. В сочетании с оптимизациями развертывания семейства Flash (такими как перекрытие одиночных батчей и широкий параллелизм экспертов) эти достижения соответствуют приоритетам специалистов по оркестрации: надежная пропускная способность, минимизация задержек и бюджетируемое масштабирование.
Между тем, дата-инженеры и руководители ИТ-безопасности видят в этом иные, но взаимодополняющие преимущества. Для специалистов по работе с данными эффективность в обработке логических рассуждений и структурированных задач упрощает интеграцию языковых моделей в конвейеры, зависящие от точных трансформаций или обеспечения качества.
Что касается функций безопасности, высокие показатели безопасности Flash-Thinking (особенно в части фильтрации вредоносного контента и обнаружения дезинформации) дают уверенность в том, что интеграция таких моделей в корпоративные системы не повышает организационные риски.
Объединяя архитектурную эффективность, масштабное обучение с подкреплением и доступные инструменты для разработчиков, компания Meituan позиционирует семейство LongCat как исследовательский вклад и в то же время как практическую платформу, которая объединяет передовые рассуждения с практичностью в реальных условиях.




