


Qwen3-Omni от Alibaba дебютирует как ИИ с открытым исходным кодом


Американские технологические гиганты сталкиваются с серьезным вызовом с Востока.
В то время как Nvidia сегодня пообещала инвестировать колоссальные 100 миллиардов долларов в дата-центры своего собственного клиента OpenAI — шаг, который вызвал удивление в технологических и бизнес-кругах, — исследовательская группа Qwen китайского гиганта интернет-поиска Alibaba представила, пожалуй, свою самую впечатляющую модель на сегодняшний день: Qwen3-Omni. Это большая языковая модель (LLM) с открытым исходным кодом, которую компания позиционирует как первую «нативно сквозную омниканальную мультимодальную ИИ-модель, объединяющую текст, изображения, аудио и видео в единой структуре».
Если говорить точнее: Qwen3-Omni может принимать и анализировать пользовательский ввод в виде текста, изображений, аудио и видео, но на выходе выдает только текст и аудио — тем не менее, это все равно впечатляющее достижение.
Конечно, GPT-4o от OpenAI положила начало тренду на «омниканальные» модели, когда дебютировала еще в 2024 году, однако та модель объединяла только текст, изображения и аудио.
Модель Gemini 2.5 Pro от Google, вышедшая в марте 2025 года, также способна анализировать видео, однако, подобно GPT-4o от OpenAI, она является проприетарной («закрытый исходный код»). Это означает, что за ее использование нужно платить, в отличие от Qwen3-Omni, которую можно скачать, модифицировать и развернуть бесплатно по дружественной для бизнеса лицензии Apache 2.0 — даже для коммерческих приложений.
Выпущенная в мае 2025 года модель Gemma 3n от Google с открытым исходным кодом и лицензией Apache 2.0 является, пожалуй, ближайшим конкурентом — она также принимает на вход видео, аудио, текст и изображения, но на выходе выдает исключительно текст.
В отличие от более ранних систем, в которых функции распознавания речи или зрения привязывались к текстовым моделям постфактум, Qwen3-Omni интегрирует все модальности с самого начала, что позволяет ей обрабатывать входящие данные и генерировать ответы, сохраняя при этом реактивность в реальном времени.
Alibaba Cloud представила три различные версии Qwen3-Omni-30B-A3B, каждая из которых служит своим целям.
-
Модель Instruct является наиболее полной. Она объединяет компоненты Thinker («Мыслитель») и Talker («Говорящий») для обработки аудио-, видео- и текстовых входов, а также для генерации как текстовых, так и речевых ответов.
-
Модель Thinking сфокусирована на задачах рассуждения и обработке длинных цепочек мыслей (chain-of-thought); она принимает те же мультимодальные входные данные, но ограничивает вывод текстом, что делает ее более подходящей для приложений, где требуются подробные письменные ответы.
-
Модель Captioner представляет собой дообученный вариант, созданный специально для создания описаний аудио (audio captioning), выдающий точные текстовые описания аудиовходов с минимальным уровнем галлюцинаций.
В совокупности эти три версии позволяют разработчикам выбирать между широким спектром мультимодального взаимодействия, глубокими рассуждениями или специализированным пониманием аудио в зависимости от их потребностей.
Qwen3-Omni уже доступна на Hugging Face, Github, а также через API компании Alibaba в виде более быстрого варианта «Flash».
Архитектура и дизайн
В основе Qwen3-Omni лежит архитектура Thinker–Talker («Мыслитель — Говорящий»), где компонент «Thinker» отвечает за рассуждения и мультимодальное понимание, а «Talker» генерирует естественную речь в аудиоформате. Оба компонента опираются на архитектуру «Смеси экспертов» (Mixture-of-Experts, MoE) для поддержки высокой степени параллелизма и быстрого инференса .
Компонент Talker отделен от текстовых представлений Thinker и вместо этого напрямую зависит от аудио- и визуальных признаков. Это обеспечивает более естественную координацию речи с аудио и видео, такую как сохранение просодии и тембра во время перевода .
Это также означает, что внешние модули, такие как поиск (retrieval) или фильтры безопасности, могут вмешиваться в выходные данные Thinker до того, как Talker преобразует их в речь.
Генерация речи поддерживается авторегрессионной схемой с несколькими кодебуками и легковесной сверточной нейросетью Code2Wav ConvNet, которые в совокупности снижают задержку при сохранении вокальных деталей . Производственные показатели стриминга имеют ключевое значение: Qwen3-Omni достигает теоретической сквозной задержки первого пакета в 234 миллисекунды для аудио (0,234 секунды) и 547 миллисекунд для видео (0,547 секунды), оставаясь ниже коэффициента реального времени (RTF) даже при множественных одновременных запросах .
Модель поддерживает 119 языков в текстовом формате, 19 для ввода речи и 10 для вывода речи, охватывая основные языки мира, а также такие диалекты, как кантонский.
Контекст и ограничения
-
Длина контекста: 65 536 токенов в режиме мышления (Thinking Mode); 49 152 токена в режиме без мышления (Non-Thinking Mode)
-
Максимальный ввод: 16 384 токена
-
Максимальный вывод: 16 384 токена
-
Самая длинная цепочка рассуждений: 32 768 токенов
-
Бесплатная квота: 1 миллион токенов (по всем модальностям), действительна в течение 90 дней после активации
Цены при использовании API
Через API Alibaba тарификация рассчитывается за 1 000 токенов. Режимы Thinking Mode и Non-Thinking Mode имеют одинаковые расценки, однако вывод аудио доступен только в режиме Non-Thinking Mode.
Затраты на входные данные (Input Costs):
-
Текстовый ввод: $0,00025 за 1 тыс. токенов (≈ $0,25 за 1 млн токенов)
-
Аудиоввод: $0,00221 за 1 тыс. токенов (≈ $2,21 за 1 млн токенов)
-
Ввод изображений/видео: $0,00046 за 1 тыс. токенов (≈ $0,46 за 1 млн токенов)
Затраты на выходные данные (Output Costs):
-
Текстовый вывод:
-
Вывод текста и аудио:
Как создавалась Qwen3-Omni
Обучение Qwen3-Omni включало как крупномасштабное предварительное обучение (pretraining), так и масштабное пост-обучение.
Аудио-трансформер (AuT) служит аудиоэнкодером. Созданный с нуля, AuT обучался на 20 миллионах часов контролируемых аудиоданных, включая 80% данных распознавания речи (ASR) на китайском и английском языках, 10% ASR на других языках и 10% задач по пониманию аудио . Результатом стал энкодер с 0,6 млрд параметров, оптимизированный как для кэширования в реальном времени, так и для автономных задач.
Предварительное обучение проходило в три этапа:
-
Выравнивание энкодера (S1): Энкодеры зрения и аудио обучались отдельно, в то время как языковая модель была заморожена, что предотвратило деградацию восприятия.
-
Общее обучение (S2): Использовался датасет размером около 2 триллионов токенов, охватывающий 0,57 трлн текстовых, 0,77 трлн аудио-, 0,82 трлн визуальных токенов, а также меньшие доли видео- и аудиовизуальных данных .
-
Длинный контекст (S3): Максимальная длина токенов была увеличена с 8 192 до 32 768 с включением большего объема длинных аудио- и видеоматериалов, что укрепило способность модели обрабатывать протяженные последовательности .
Пост-обучение также включало несколько этапов. Для компонента Thinker оно включало контролируемое дообучение (supervised fine-tuning), дистилляцию от сильной модели к слабой (strong-to-weak distillation) и оптимизацию GSPO с использованием обратной связи как на основе правил, так и с применением LLM в качестве судьи (LLM-as-a-judge) . Компонент Talker прошел четырехэтапный процесс обучения, который объединил сотни миллионов мультимодальных речевых примеров с непрерывным предварительным обучением на отборных данных, нацеленным на сокращение галлюцинаций и повышение качества речи .
Результаты бенчмарков
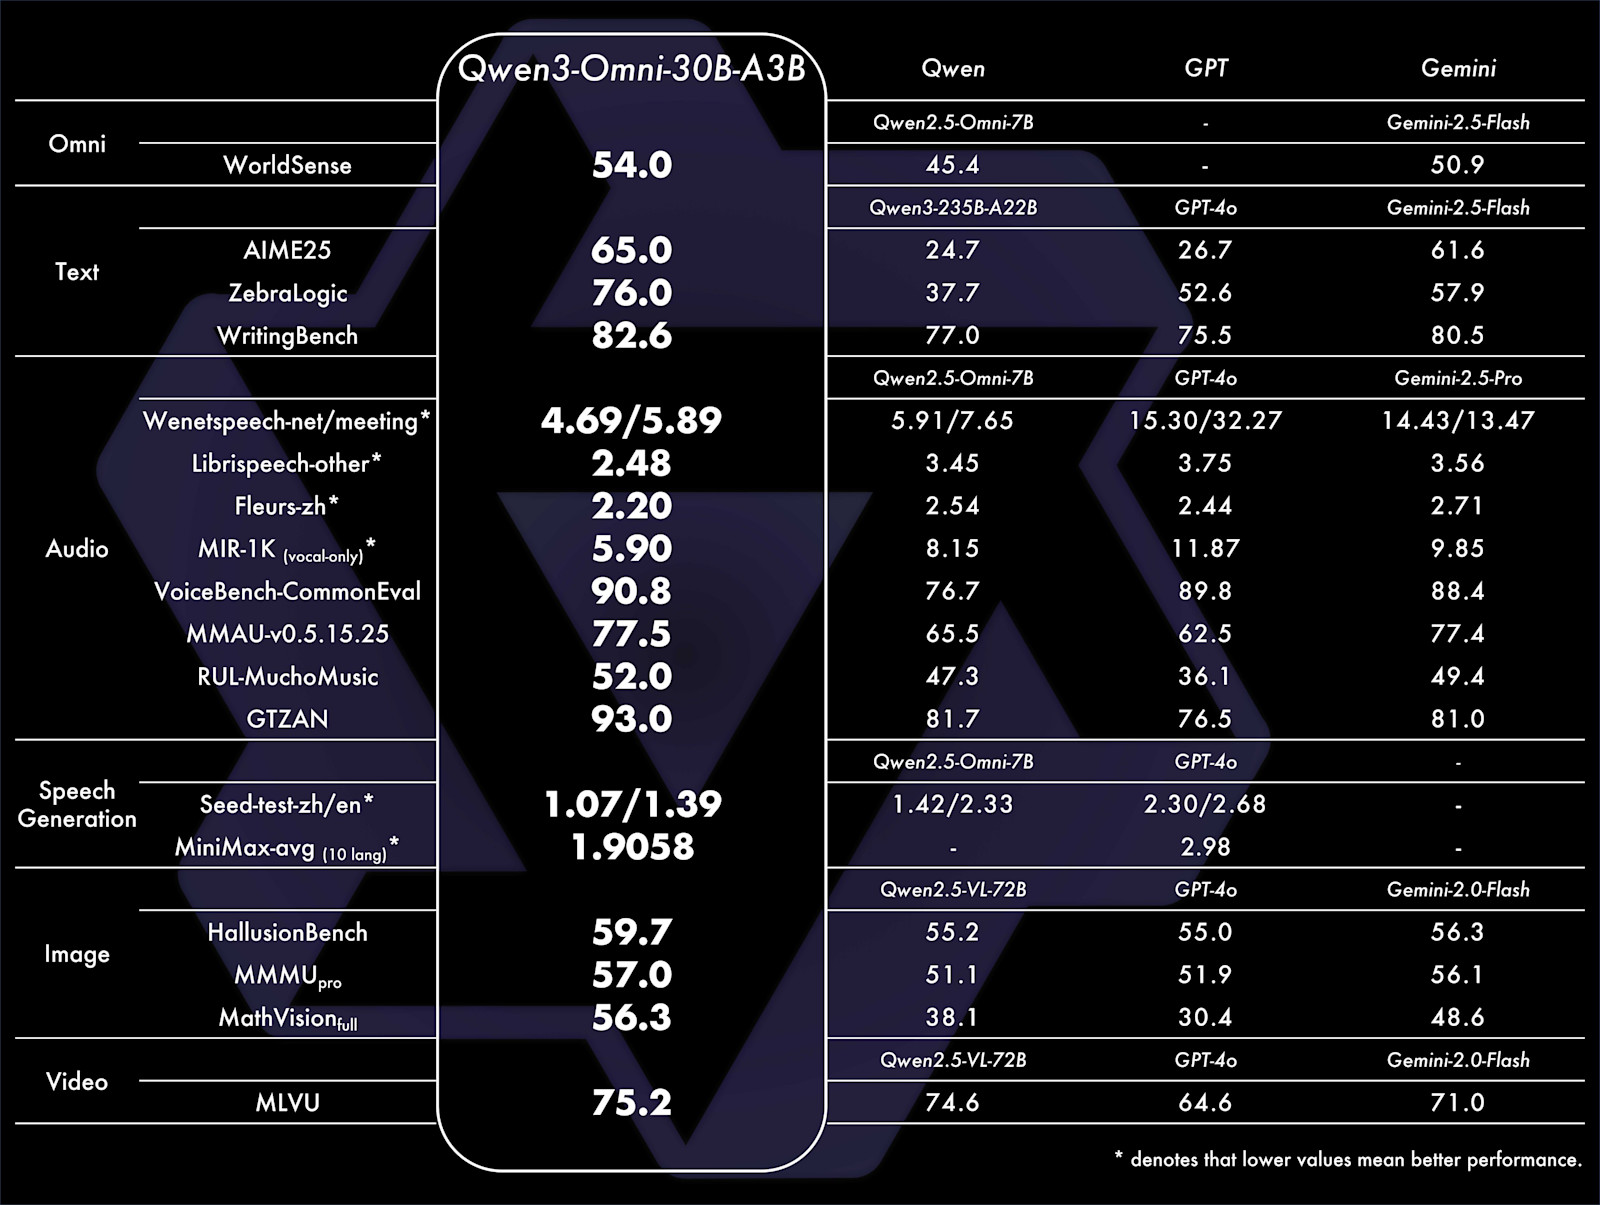
По результатам тестов на 36 бенчмарках Qwen3-Omni демонстрирует лучшие в отрасли результаты в 22 из них и лидирует среди моделей с открытым исходным кодом в 32.
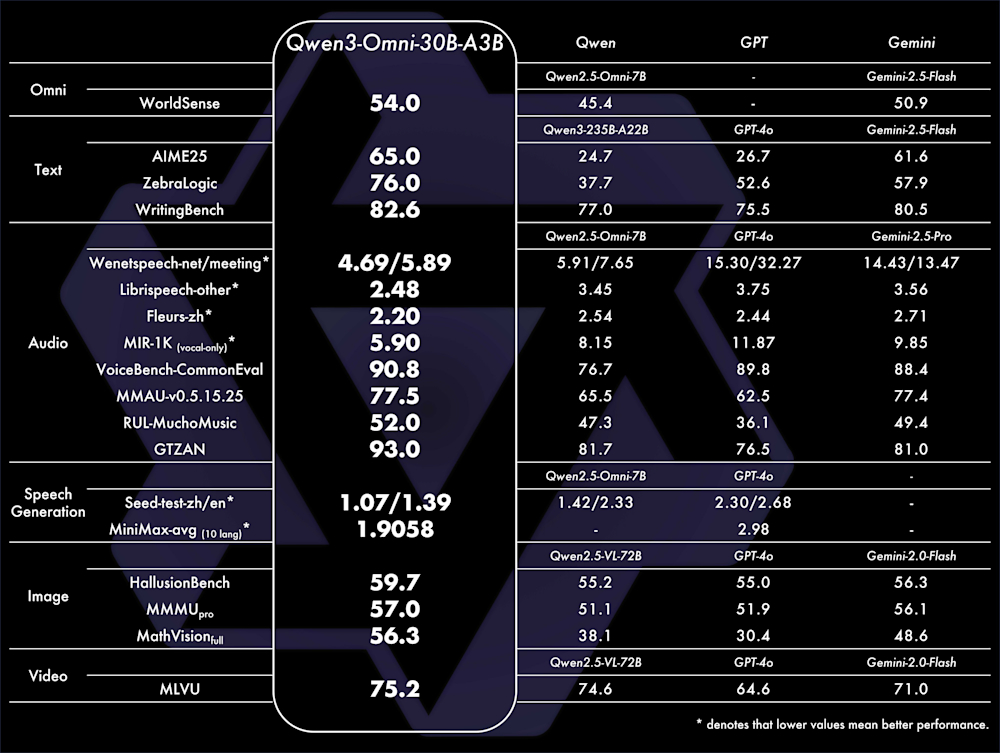
Бенчмарки Qwen3-Omni. Источник: Alibaba Qwen Team
-
Текст и рассуждения: Модель набирает 65,0 балла в AIME25, значительно опережая GPT-4o (26,7), и 76,0 в ZebraLogic, превосходя Gemini 2.5 Flash (57,9). Результаты WritingBench показывают 82,6 балла, что выше показателей GPT-4o (75,5).
-
Речь и аудио: В тесте Wenetspeech показатели WER (ошибки распознавания речи) для Qwen3-Omni составляют 4,69 и 5,89, что намного лучше 15,30 и 32,27 у GPT-4o. На бенчмарке Librispeech-other показатель падает до 2,48 WER, что является самым низким значением среди аналогов. Аудиобенчмарки также подчеркивают ее силу: GTZAN на уровне 93,0 и RUL-MuchoMusic на уровне 52,0 — оба результата выше, чем у GPT-4o.
-
Изображения и зрение: Оценки в HallusionBench достигают 59,7, в MMMU_pro — 57,0, а в MathVision_full — 56,3, и все они выше, чем у GPT-4o.
-
Видео: В MLVU Qwen3-Omni достигает 75,2 балла, превосходя Gemini 2.0 Flash с ее 71,0 балла и GPT-4o с 64,6 балла.
В совокупности эти результаты подчеркивают способность Qwen3-Omni сохранять высокое качество работы с текстом и визуальными данными при одновременном превосходстве в речевых и мультимодальных задачах.
Приложения и варианты использования
Alibaba Cloud выделяет широкий спектр сценариев применения Qwen3-Omni. Они варьируются от многоязычной транскрипции и перевода до создания описаний аудио (audio captioning), распознавания текста (OCR), тегирования музыки и понимания видео.
Представьте себе ИИ-агента технической поддержки, который может практически в реальном времени просматривать живое видео, транслируемое с веб-камеры или телефона клиента, а затем предоставлять автоматизированные инструкции по устранению неполадок с их устройством (например, принтером, холодильником, посудомоечной машиной и т. д.) или приложением («как отменить мою подписку?»).
К числу более интерактивных возможностей относятся видеонавигация и аудиовизуальный диалог, в рамках которого модель задействует как звук, так и изображения для взаимодействия в реальном времени .
С помощью системных промптов (инструкций) разработчики могут точно настраивать поведение Qwen3-Omni: от стиля беседы до формирования определенной роли (персоны). Такая гибкость поддерживает развертывание в потребительских ассистентах, корпоративных системах транскрипции и специализированных инструментах анализа.
Лицензирование и влияние на корпоративный сектор
Qwen3-Omni выпускается под лицензией Apache 2.0 — гибкой структурой, которая позволяет предприятиям свободно внедрять и адаптировать технологию. Лицензия Apache 2.0 предоставляет права на коммерческое использование, модификацию и повторное распространение без требования открывать исходный код производных работ.
Она также включает в себя патентную лицензию, что снижает юридические риски при интеграции модели в проприетарные системы.
Для бизнеса это означает, что Qwen3-Omni можно встраивать в продукты или рабочие процессы без лицензионных сборов и проблем с соблюдением нормативных требований. Предприятия могут дообучать модели под конкретные отрасли или местные стандарты регулирования, одновременно извлекая выгоду из непрерывного вклада сообщества разработчиков.
Что ждет Qwen в будущем?
Qwen3-Omni представляет собой стремление Alibaba Cloud расширить сферу применения мультимодального ИИ за пределы академических исследований, переведя его в плоскость готовых к внедрению корпоративных решений.
Благодаря архитектуре Thinker–Talker, обширному пайплайну обучения и лицензии Apache 2.0 эта система предлагает как высокую техническую производительность, так и практическую доступность.
Как выразился Лин, «Это может внести некоторые изменения в ландшафт омниканальных моделей с открытым исходным кодом! Надеюсь, вам понравится!» Сочетая взаимодействие в реальном времени с открытой доступностью, Qwen3-Omni знаменует собой новый этап внедрения мультимодального ИИ, на котором предприятия и разработчики могут без каких-либо барьеров интегрировать мощные мультимодальные системы в свои рабочие процессы.




