


Детерминированное выполнение переосмысляет вычисления для ИИ
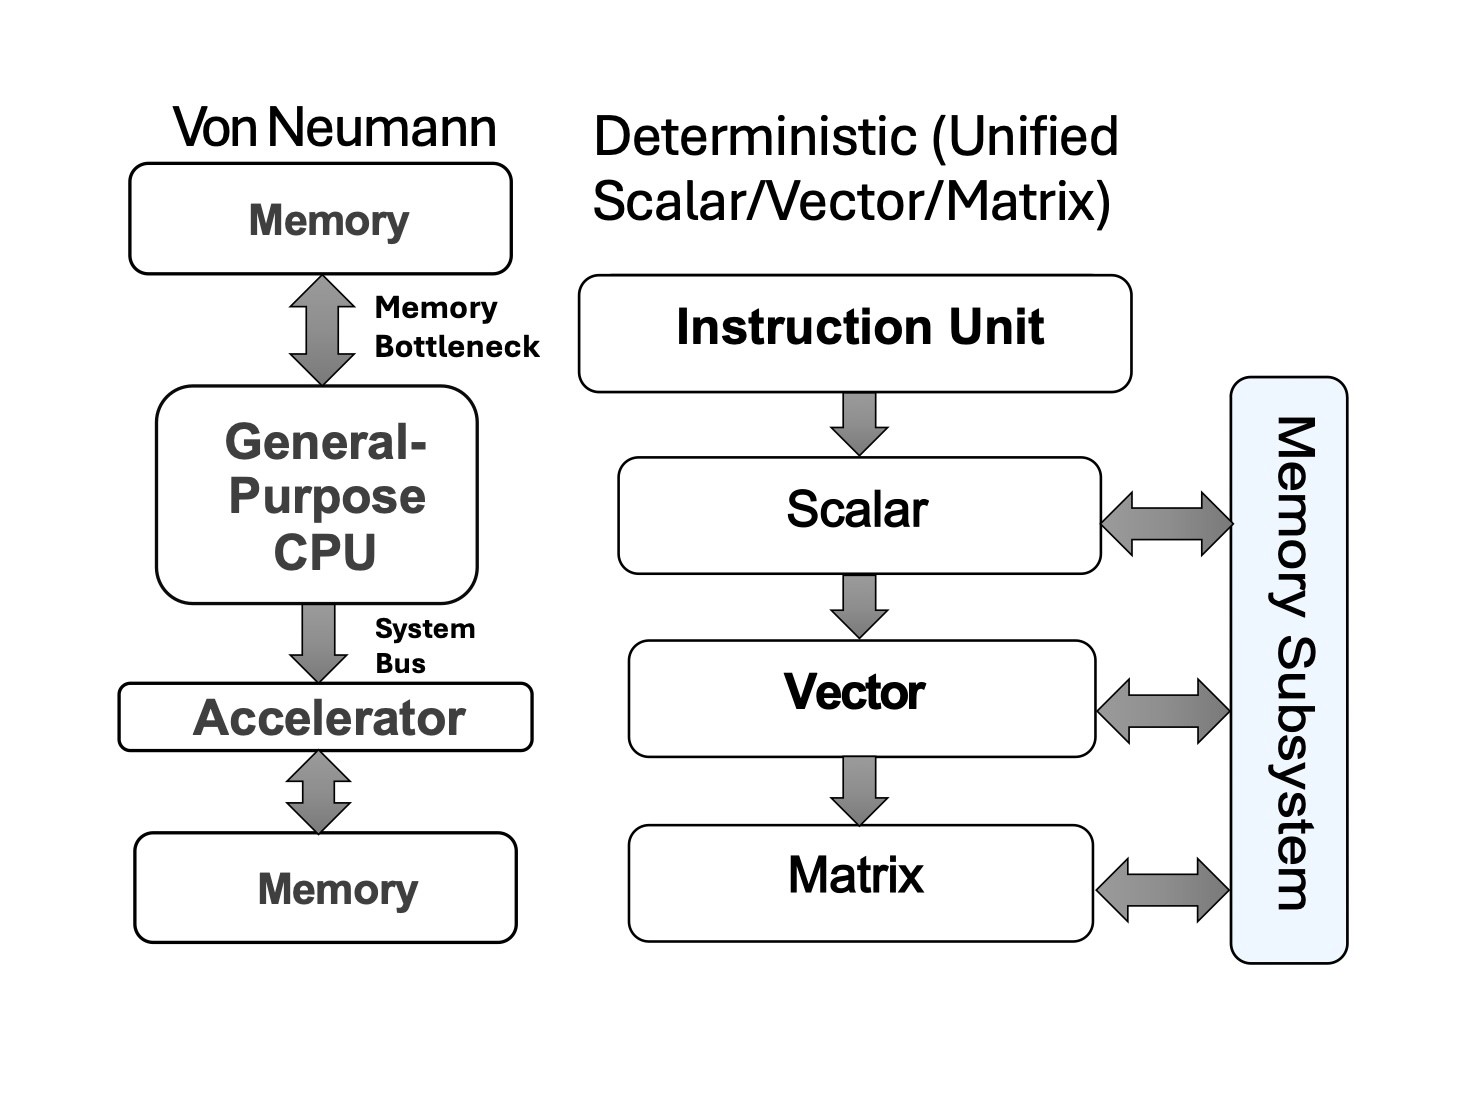


Точная по тактам альтернатива спекулятивным вычислениям — объединение скалярных, векторных и матричных вычислений
Более полувека вычислительная техника опирается на модель фон Неймана или Гарвардскую архитектуру. Почти каждый современный чип — центральные процессоры (CPU), графические процессоры (GPU) и даже множество специализированных ускорителей — происходит от этого проекта. Со временем внедрялись новые архитектуры, такие как Very Long Instruction Word (VLIW), процессоры потоков данных и GPU, чтобы устранить конкретные узкие места в производительности, но ни одна из них не предложила комплексной альтернативы самой парадигме.
Новый подход под названием детерминированное выполнение бросает вызов этому устоявшемуся положению вещей. Вместо динамического угадывания того, какие инструкции выполнять дальше, оно планирует каждую операцию с точностью до такта, создавая предсказуемый график выполнения. Это позволяет одному процессору объединить скалярные, векторные и матричные вычисления, справляясь как с универсальными нагрузками, так и с задачами ИИ без использования отдельных ускорителей.
Конец догадкам
При динамическом выполнении процессоры строят предположения о будущих инструкциях, выполняют работу вне очереди и осуществляют откат, когда прогнозы оказываются неверными. Это добавляет сложности, тратит энергию и может обнажать уязвимости в системе безопасности. Детерминированное выполнение полностью исключает спекулятивные вычисления. Каждая инструкция имеет фиксированный временной слот и выделенные ресурсы, что гарантирует ее выдачу ровно в нужный такт.
Механизм, лежащий в основе этого — матрица «время-ресурс»: среда планирования, которая координирует вычислительные, ресурсные и управляющие ресурсы во времени. Подобно расписанию поездов, скалярные, векторные и матричные операции перемещаются по синхронизированной вычислительной среде без остановок конвейера или конфликтов за ресурсы.
Почему это важно для корпоративного ИИ
Нагрузки корпоративного ИИ доводят существующие архитектуры до предела. GPU обеспечивают огромную пропускную способность, но потребляют колоссальное количество энергии и сталкиваются с проблемами узких мест памяти. CPU предлагают гибкость, но им не хватает параллелизма, необходимого для современного инференса и обучения. Решения на базе нескольких чипов часто приводят к задержкам, проблемам с синхронизацией и фрагментации программного обеспечения.
В крупных рабочих нагрузках ИИ наборы данных часто не помещаются в кэш-память, и процессору приходится извлекать их напрямую из DRAM или HBM. Обращения могут занимать сотни тактов, оставляя функциональные блоки простаивающими и расходуя энергию. Традиционные конвейеры останавливаются при любой зависимости, увеличивая разрыв в производительности между теоретической и реальной пропускной способностью.
Детерминированное выполнение решает эти проблемы тремя важными способами. Во-первых, оно предоставляет единую архитектуру, в которой универсальная обработка и ускорение ИИ сосуществуют на одном кристалле, устраняя накладные расходы на переключение между модулями. Во-вторых, оно обеспечивает предсказуемую производительность за счет точного выполнения по тактам, что делает его идеальным для приложений, чувствительных к задержкам, таких как инференс больших языковых моделей (LLM), обнаружение мошенничества и промышленная автоматизация. Наконец, оно снижает энергопотребление и физическую площадь за счет упрощения логики управления, что, в свою очередь, приводит к уменьшению площади кристалла и снижению энергопотребления.
Предсказывая точно момент поступления данных — будь то через 10 тактов или через 200, — детерминированное выполнение может встраивать зависимые инструкции в нужный будущий такт. Это превращает задержку из проблемы в планируемое событие, сохраняя вычислительные блоки полностью загруженными и избегая огромных накладных расходов на потоки и буферы, которые используют графические процессоры или заказные чипы VLIW. В смоделированных нагрузках этот унифицированный дизайн обеспечивает стабильную пропускную способность на уровне оборудования для ускорения при выполнении общего кода, позволяя одному чипу выполнять роли, обычно разделяемые между CPU и GPU.
Для команд развертывания LLM это означает, что серверы инференса можно настраивать с точными гарантиями производительности. Для менеджеров инфраструктуры данных это предлагает единую цель вычислений, масштабируемую от периферийных устройств до облачных стоек без масштабного переписывания ПО.
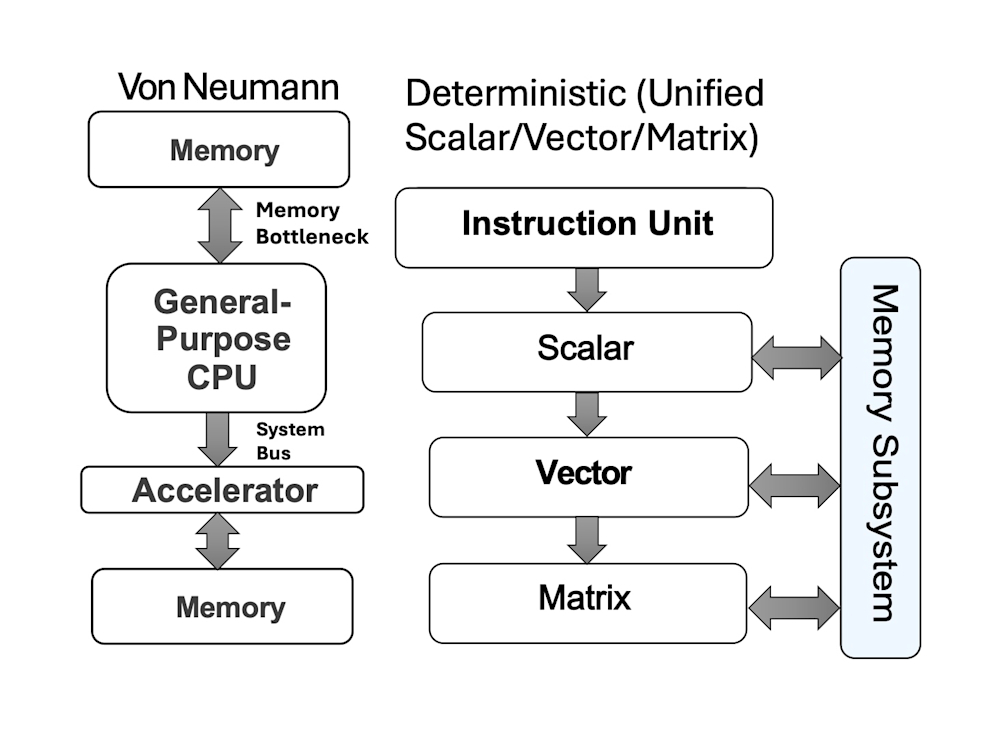
Сравнение традиционной архитектуры фон Неймана и унифицированного детерминированного выполнения. Изображение создано автором.
Ключевые архитектурные инновации
Детерминированное выполнение опирается на несколько вспомогательных методов. Матрица «время-ресурс» координирует вычислительные ресурсы и память в фиксированных временных интервалах. Фантомные регистры позволяют конвейеризировать работу за пределами ограничений физического файла регистров. Буферы векторных данных и расширенные наборы векторных регистров дают возможность масштабировать параллельную обработку для операций ИИ. Буферы повтора инструкций предсказуемо управляют событиями с переменной задержкой, не полагаясь на спекуляции.
Двухбанковый файл регистров архитектуры удваивает емкость чтения/записи без ущерба в виде дополнительных портов. Прямая передача данных из DRAM во векторный буфер загрузки/сохранения сокращает количество обращений к памяти вдвое и устраняет необходимость в многомегабайтных буферах SRAM, сокращая площадь кремния, стоимость и энергопотребление.
В смоделированных ядрах ИИ и DSP традиционные конструкции выдают запрос на чтение, ждут его возврата и только затем продолжают работу, из-за чего весь конвейер простаивает. Детерминированное выполнение организует загрузку и зависимые вычисления в конвейер параллельно, позволяя одному и тому же циклу выполняться без перерывов, сокращая как время выполнения, так и затраты энергии на операцию.
В совокупности эти инновации создают вычислительный механизм, который сочетает гибкость процессора со стабильной пропускной способностью ускорителя, не требуя двух отдельных чипов.
Последствия за пределами ИИ
Хотя рабочие нагрузки ИИ являются очевидным бенефициаром, детерминированное выполнение имеет далеко идущие последствия и для других областей. Критически важные для безопасности системы — такие как системы в автомобильной, аэрокосмической и медицинской технике — могут получить преимущества от гарантий детерминированного времени. Системы аналитики реального времени в финансах и операционной деятельности приобретают способность работать без джиттера. Платформы периферийных вычислений (Edge computing), где важен каждый ватт энергии, могут работать эффективнее.
Устранение догадок и обеспечение предсказуемого времени выполнения делают системы, созданные на основе этого подхода, более простыми для верификации, более безопасными и энергоэффективными.
Влияние на бизнес
Для предприятий, развертывающих ИИ в больших масштабах, архитектурная эффективность напрямую трансформируется в конкурентное преимущество. Предсказуемое выполнение без задержек упрощает планирование емкости для кластеров инференса LLM, обеспечивая стабильное время отклика даже при пиковых нагрузках. Более низкое энергопотребление и меньшая площадь кремния сокращают операционные расходы, особенно в крупных дата-центрах, где затраты на охлаждение и электроэнергию доминируют в бюджетах. В периферийных средах способность выполнять разнообразные рабочие нагрузки на одном чипе сокращает номенклатуру оборудования, сужает сроки развертывания и сводит к минимуму сложность обслуживания.
Путь вперед для корпоративных вычислений
Переход к детерминированному выполнению — это не просто погоня за чистой производительностью; он представляет собой возврат к архитектурной простоте, где один чип может выполнять несколько ролей без компромиссов. Поскольку ИИ проникает в каждый сектор, от производства до кибербезопасности, возможность предсказуемо выполнять разнообразные рабочие нагрузки на единой архитектуре станет стратегическим преимуществом.
Предприятиям, оценивающим инфраструктуру на следующие 5–10 лет, следует внимательно следить за этим развитием событий. Детерминированное выполнение обладает потенциалом снизить сложность оборудования, сократить затраты на электроэнергию и упростить развертывание программного обеспечения, обеспечивая при этом стабильную производительность в самом широком спектре приложений.
Тханг Минь Чан (Thang Minh Tran) — архитектор микропроцессоров и автор более 180 патентов в области проектирования процессоров и ускорителей.
Добро пожаловать в сообщество VentureBeat!
Наша программа гостевых публикаций — это площадка, где технические эксперты делятся идеями и публикуют независимые, непредвзятые глубокие аналитические материалы об ИИ, инфраструктуре данных, кибербезопасности и других передовых технологиях, формирующих будущее корпоративного сектора.
Читайте далее в рамках нашей программы гостевых постов — и ознакомьтесь с нашими рекомендациями, если вы хотите предложить свою собственную статью!




