Открытая языковая модель CLM-8B от Стэнфорда и Nvidia кэширует повторяющиеся действия агентов и в тестах работает до 9 раз быстрее Jev


Агенты ИИ часто используют языковые модели (LLM) для выбора из фиксированного набора инструментов или ранжирования возможных вариантов вывода. В каждом случае модель обрабатывает промпт и генерирует токены, хотя для приложения требуется лишь принятие ограниченного решения.
Исследователи из Стэнфорда и Nvidia представили Contrastive Language Models (CLM) — новый подход, разработанный специально для подобных задач. Вместо генерации последовательностей токенов их модель CLM-8B создает представления текущего состояния и доступных действий, после чего выбирает действие, наилучшим образом соответствующее состоянию.
Такое решение может оказаться особенно полезным в приложениях, где агенты часто повторяют одни и те же типы решений на протяжении всего рабочего процесса. CLM способна кэшировать повторно используемые представления действий и избегать их повторного вычисления для каждого запроса.
В ходе тестов исследователей в режиме zero-shot (без предварительного обучения на задачах) в сфере использования компьютеров, игр и вызова инструментов модель CLM-8B работала до 9 раз быстрее, чем Jev от TypeSafe, и сравнялась с ней по уровню успешности в двух игровых задачах. В двух других задачах она уступила в точности: 95,2% против 99,2% у Jev на бенчмарке вызова инструментов BFCL v4, а также успешное выполнение 26 задач WikiRacing из 30 против 30 у Jev. Наибольший прирост скорости наблюдался в случаях, когда модель могла повторно использовать действия для множества состояний или выбирать из большого набора кандидатов.
Появление CLM происходит на фоне растущего интереса к моделям, которые TypeSafe называет «Системой один» (System One), — категории, представленной ими совместно с Jev в начале этого месяца. CLM добавляет контрастный подход к этому формирующемуся стеку.
Как CLM превращает принятие решений в задачу на сопоставление
CLM состоит из компонентов состояния и действия. Состояние отражает то, что модель в данный момент знает о задаче. Действия представляют собой доступные варианты выбора. CLM формирует общее пространство встраиваний (embedding space) для этих состояний и действий. В процессе обучения модель сближает правильные пары и разводит неправильные дальше друг от друга.
На этапе инференса модели не нужно генерировать название действия по одному токену за раз. Она кодирует текущее состояние, сравнивает это представление с представлениями возможных действий и выбирает наиболее близкое соответствие.
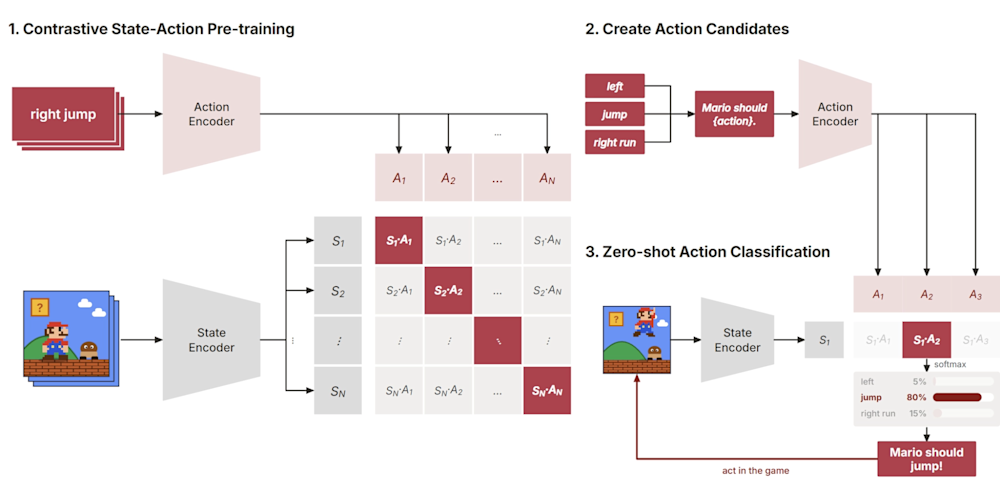
Архитектура CLM (источник: команда CLM)
Исследователи реализуют этот метод с помощью контрастного обучения под названием InfoNCE. InfoNCE обучает модель, предлагая ей одну правильную пару «состояние-действие» наряду с несколькими неправильными, и вознаграждает её за присвоение наибольшей степени сходства именно верному варианту.
Исследователи обучали CLM в три этапа. Сначала они используют около 60 миллионов пар «вопрос-ответ» для обучения широкому семантическому сопоставлению. Затем они добавляют примерно 30 миллионов синтетических «сложных негативов» — например, вопросов с множественным выбором, где ответы семантически похожи, но верным является только один. Наконец, они проводят посттренировку примерно на одном миллионе траекторий агентов, чтобы адаптировать модель к принятию решений агентами.
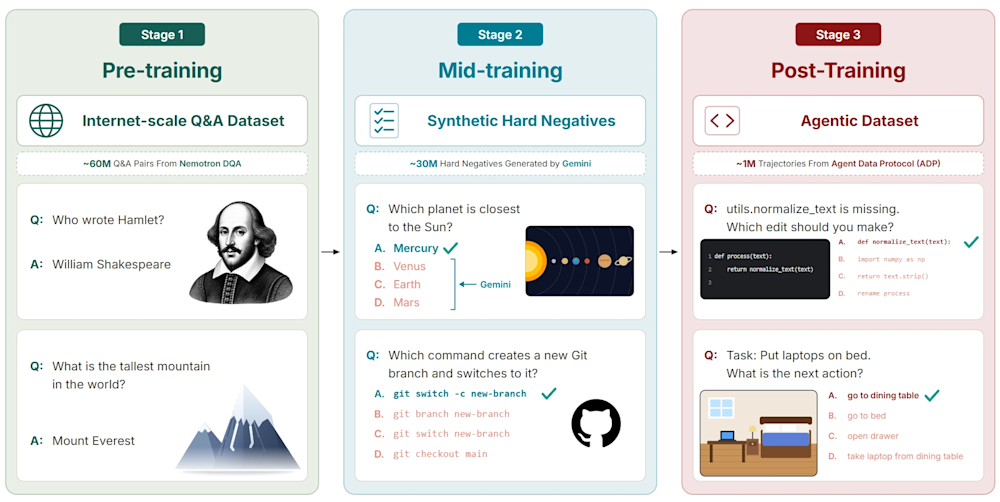
Конвейер обучения CLM (источник: команда CLM)
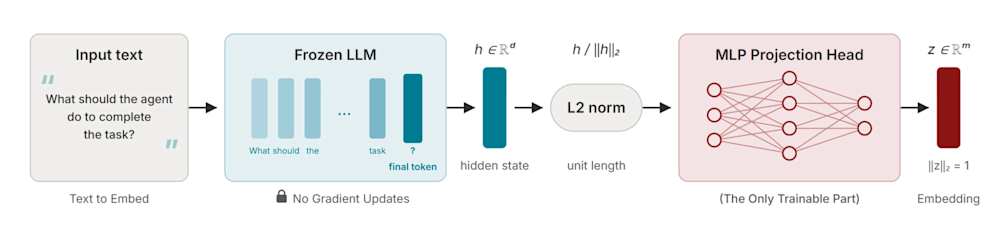
В выпущенной модели CLM-8B используется замороженная базовая модель Qwen3-8B с отдельными проекционными головами для состояний и действий. Такое разделение позволяет оптимизировать развертывание. Если приложение неоднократно выбирает из одних и тех же действий, CLM может закодировать их один раз и закэшировать эмбеддинги. Каждый новый запрос тогда потребует лишь кодирования изменяющегося состояния и его сравнения с закэшированными действиями.
Например, компания может захотеть использовать CLM для внутреннего ИТ-агента с 50 одобренными действиями, такими как сброс пароля, предоставление доступа, открытие тикета или передача запроса в службу безопасности. Вместо того чтобы постоянно обрабатывать все 50 вариантов в составе генеративного промпта, CLM может держать их представления наготове и оценивать каждую новую ситуацию по отношению к ним.
Место CLM в корпоративном стеке ИИ
Выпущенная модель поддерживает несколько ограниченных шаблонов принятия решений: выбор между вариантами, возврат вероятности «да/нет», оценку по упорядоченной шкале и ранжирование произвольных кандидатов. Это делает CLM применимой для таких задач, как маршрутизация инструментов, триаж тикетов, предварительный отбор при поиске и выбор из нескольких предложенных вариантов ответа.
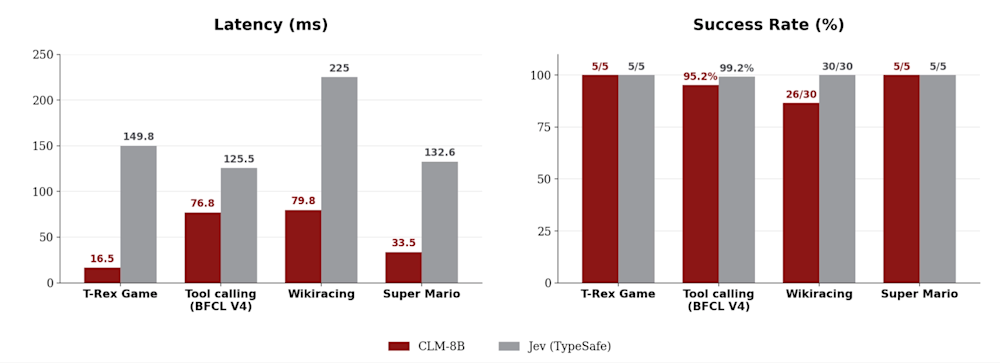
Производительность CLM в задачах принятия решений (источник: команда CLM)
Генеративные модели уже можно настраивать на выбор из фиксированного набора инструментов или вариантов вывода. API для структурированного вывода и вызова функций сделали такие ответы гораздо более надежными, но они по-прежнему заставляют генеративную модель вести себя как систему принятия решений. CLM же изначально исходит из самой задачи принятия решений: имея состояние и фиксированный набор действий, ранжировать доступные действия и сделать выбор среди них.
Это также способно изменить экономику мультимодельных систем. Перенаправление запроса через генеративную LLM требует, чтобы модель обработала промпт, а затем сгенерировала ответ, даже если на выходе требуется только название одного инструмента. CLM позволяет избежать авторегрессионной генерации текста.
Исследователи не приводят прямого сравнения стоимости в долларах с передовыми API, поэтому релиз не дает точной оценки снижения затрат на хостинг. CLM-8B все еще задействует кодировщик с 8 миллиардами параметров. Однако ее схема инференса исключает вычисления, которые генеративные модели выполняют для ограниченных решений.
Одно из важнейших преимуществ CLM — снижение задержки в многошаговых агентских задачах. Задержка в одном вызове маршрутизации может быть незначительной. Но когда агент совершает десятки операций маршрутизации, ранжирования и проверки перед возвратом ответа, эти затраты суммируются.
Другое преимущество заключается в том, что адаптация CLM к конкретной задаче не требует дообучения всей 8-миллиардной модели. Базовая модель Qwen3-8B остается замороженной, в то время как разработчики обучают значительно меньшие проекционные головы состояний и действий.
CLM в задачах верификации кода (источник: команда CLM)
В комментариях для VentureBeat руководитель проекта Джеки Квок (Jacky Kwok) из Стэнфорда отметил, что цель контрастного обучения также имеет преимущества для специализированных задач принятия решений. «Мы обнаружили, что контрастный подход может быть особенно эффективен для принятия решений по сравнению со стандартным дообучением с учителем (SFT) с использованием функции потерь на основе перекрестной энтропии (cross-entropy loss), — заявил он. — Мы также выяснили, что инициализация с предварительно обученной контрольной точки CLM позволяет модели быстро адаптироваться к целевым или специализированным задачам».
Например, агенту техподдержки может потребоваться решить, следует ли оформить возврат средств, передать вопрос человеку, запросить дополнительную информацию или закрыть тикет. Благодаря контрастному подходу CLM модель настраивается на сближение правильной пары «состояние-действие» и удаление конкурирующих действий.
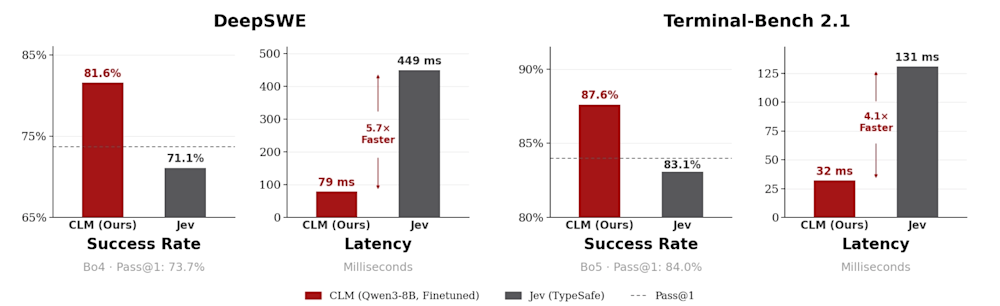
Команда протестировала этот подход, дообучив CLM в качестве верификатора для задач программирования. В экспериментах исследователей более крупные модели сначала генерировали несколько вариантов решений. Opus 5 создавала кандидатов для DeepSWE, а Fable 5 — для Terminal-Bench 2.1. Затем дообученная модель CLM ранжировала этих кандидатов и выбирала одного для отправки.
На отложенных подмножествах данных исследователи зафиксировали, что CLM достигла 81,6% на 38 задачах DeepSWE и 87,6% на 30 задачах Terminal-Bench 2.1 по сравнению с 71,1% и 83,1% у Jev на тех же подмножествах. Они сообщают, что задержка верификатора CLM была в 4,1–5,7 раза ниже, чем у Jev. Важно отметить, что CLM не решала задачи DeepSWE с нуля — более крупная модель создавала варианты решений, а CLM выбирала среди них.
CLM используют замороженную основу LLM и обучаемый компонент проекционной головы (источник: команда CLM)
Квок описывает общее разделение труда следующим образом: «Используйте крупные модели рассуждений для генерации и логических выводов, а CLM — для дешевого отбора, верификации и мониторинга их результатов».
Одна из возможных схем предполагает, что несколько экономичных моделей с открытым исходным кодом генерируют варианты ответов или действий, после чего модель CLM быстро ранжирует их и выбирает лучший. Квок утверждает, что это может быть более рентабельно, чем полагаться на передовую модель при принятии большинства решений.
CLM также может служить уровнем мониторинга для агентов. По словам Квока, команда часто наблюдает четкое разделение между оценками CLM для успешных и неуспешных траекторий. «CLM может непрерывно оценивать действия или траектории, производимые агентом, и сигнализировать о необычном или потенциально неудачном поведении», — пояснил он. Это может дать корпоративным системам дополнительный инструмент для обнаружения моментов, когда долго работающие агенты сбиваются с пути, хотя данный метод не следует рассматривать как гарантированный механизм безопасности.
Это также определяет границы понятия «верификатор». CLM оценивает только тех кандидатов, которых получает, и ее вероятности рассчитываются относительно этого набора кандидатов. Если каждое из предложенных действий неверно, модели все равно придется их ранжировать.
Существуют также задачи, для которых CLM попросту не подходит. «Я бы не стал использовать CLM в качестве замены модели общего назначения для рассуждений в задачах, требующих серьезных открытых размышлений, таких как решение математических задач, генерация объемных текстов или высокоуровневое планирование», — говорит Квок. Модели CLM лучше подходят для случаев, когда возможные варианты уже известны и модели необходимо выбрать, проранжировать или проверить их.
Разработчики могут протестировать этот паттерн уже сегодня. Команда выпустила веса CLM-8B под лицензией Apache 2.0 вместе с открытым исходным кодом, совместимым с TypeSafe API, инструментами для дообучения и песочницей (playground) для интерактивного тестирования состояний, типизированных вопросов и ранжирования кандидатов.
Чем CLM отличается от других моделей принятия решений
CLM — один из нескольких проектов, выпущенных в рамках недавней концепции «Системы один». TypeSafe представила Jev 15 сентября как модель для быстрых структурированных решений, обученную с помощью метода, который компания называет «Обучение с подкреплением для откалиброванных решений» (Reinforcement Learning for Calibrated Decisions). Laya использует другой подход на базе меньших двунаправленных энкодеров. CUA-S1 устроена еще более узко: ее первая модель сфокусирована на выборе ограниченных действий для задач по заполнению форм.
Однако они различаются по способу реализации этого уровня принятия решений. «Ключевое различие между CLM и такими моделями, как Jev или Laya, заключается в архитектуре», — отмечает Квок. По его словам, Jev и Laya в основном поддерживают кэширование представления состояния, в то время как двухэнкодерная архитектура CLM позволяет независимо вычислять и кэшировать эмбеддинги как состояний, так и действий.
Это архитектурное различие становится особенно важным, когда и контекст, и возможные действия велики по объему. CLM может кодировать эти две стороны раздельно и пакетно обрабатывать их вычисления. А когда возможные действия предопределены — например, инструменты компании, API или рабочие процессы, — их представления могут быть вычислены заранее и повторно использоваться для разных запросов. Как выразился Квок, «CLM особенно хорошо подходит для приложений с длинным контекстом / пространствами повторно используемых действий».
Проект также выходит за рамки текущей 8-миллиардной модели. Квок сообщил, что CLM-8B является частью линейки масштабирования, которую команда использует для изучения зависимости производительности от размера модели. По его словам, в настоящее время идет обучение мультимодальной модели CLM-35B-A3B с использованием бо́льших объемов данных и вычислительных ресурсов, а ее релиз запланирован на начало октября. Команда также добавляет значительно больше данных агентского обучения.
«Мы также проводим ее посттренировку на существенно большем объеме агентских данных с целью сделать модель оптимально приспособленной для интеграции в существующие инфраструктуры и рабочие процессы», — добавил Квок.