


SpaceXAI представляет Grok 4.6, опережая показатели Kimi K3 и выходя на четвертое место в мире по версии Artificial Analysis
Источник: VentureBeat · Carl Franzen


Компания SpaceXAI, принадлежащая Илону Маску и ранее известная как xAI, выпустила Grok 4.6 — свою новейшую передовую модель искусственного интеллекта. Основное внимание в ней уделено долгосрочным агентам, написанию кода и интеллектуальной работе, а также ценовой стратегии, призванной удешевить выполнение таких рабочих нагрузок.
Модель набирает 61 балл в стороннем индексе искусственного интеллекта Artificial Analysis, превосходя популярную китайскую модель с открытыми весами от Moonshot — Kimi K3, и сравниваясь с конкурирующей моделью OpenAI GPT-5.6 Sol Max, а также улучшая результат Grok 4.5 High на пять пунктов. Модели Anthropic Claude Opus 5 и Fable 5 занимают первое и второе места соответственно.
Что еще более важно для предприятий, оценивающих ИИ-агентов, Grok 4.6 демонстрирует значительный прирост производительности по сравнению с предшественником в тестах на кодирование, работу с терминалом, интеллектуальные задачи и агентские бенчмарки. При этом стоимость интерфейса программирования приложений (API) осталась на уровне от 2 долларов за миллион входных токенов и 6 долларов за миллион выходных токенов. Согласно анализу VentureBeat, это делает модель передовым решением сред ценового диапазона среди ведущих проприетарных и открытых аналогов на мировом рынке.
|
Модель |
Вход ($/1M) |
Выход ($/1M) |
Итого ($/1M) |
Источник |
|
Muse Spark 1.2 Contributor |
$0.10 |
$0.20 |
$0.30 |
|
|
MiMo-V2.5 Flash |
$0.10 |
$0.30 |
$0.40 |
|
|
deepseek-v4-flash |
$0.14 |
$0.28 |
$0.42 |
|
|
deepseek-v4-pro |
$0.435 |
$0.87 |
$1.305 |
|
|
GPT-5.6 Luna |
$0.20 |
$1.20 |
$1.40 |
|
|
MiniMax-M3 |
$0.30 |
$1.20 |
$1.50 |
|
|
LongCat-2.0 — акция в течение ограниченного времени |
$0.30 |
$1.20 |
$1.50 |
|
|
MiMo-V2.5 |
$0.40 |
$2.00 |
$2.40 |
|
|
LongCat-2.0 — стандартная |
$0.75 |
$2.95 |
$3.70 |
|
|
MiMo-V2.5 Pro (≤256K) |
$1.00 |
$3.00 |
$4.00 |
|
|
Muse Spark 1.1 / 1.2 |
$1.25 |
$4.25 |
$5.50 |
|
|
GLM-5.2 |
$1.40 |
$4.40 |
$5.80 |
|
|
Grok 4.6 — <200 тыс. токенов промпта |
$2.00 |
$6.00 |
$8.00 |
|
|
MiMo-V2.5 Pro (>256K) |
$2.00 |
$6.00 |
$8.00 |
|
|
Qwen3.8-Max |
$2.00 |
$6.00 |
$8.00 |
|
|
Gemini 3.6 Flash |
$1.50 |
$7.50 |
$9.00 |
|
|
GPT-5.6 Terra |
$2.00 |
$12.00 |
$14.00 |
|
|
Grok 4.6 — ≥200 тыс. токенов промпта |
$4.00 |
$12.00 |
$16.00 |
|
|
GPT-5.4 |
$2.50 |
$15.00 |
$17.50 |
|
|
Kimi K3 |
$3.00 |
$15.00 |
$18.00 |
|
|
Claude Opus 5 |
$5.00 |
$25.00 |
$30.00 |
|
|
Sakana Fugu Ultra (≤272K) |
$5.00 |
$30.00 |
$35.00 |
|
|
GPT-5.6 Sol — Стандартный режим |
$5.00 |
$30.00 |
$35.00 |
|
|
Claude Fable 5 / Claude Mythos 5 |
$10.00 |
$50.00 |
$60.00 |
|
|
GPT-5.6 Sol — Быстрый режим |
$10.00 |
$60.00 |
$70.00 |
Тем не менее, это меньше половины стоимости использования GPT-5.6 Sol через API OpenAI в стандартном режиме.
SpaceXAI заявляет, что Grok 4.6 доступен уже сегодня в Grok Build — ответе SpaceXAI на Claude Code от Anthropic и Codex от OpenAI. Этот инструмент доступен начиная с тарифного плана SuperGrok стоимостью 30 долларов в месяц.
Он также доступен в рамках недавнего приобретения компании Cursor, занимающейся разработкой ИИ-кода, и у таких партнеров, как OpenRouter, Vercel и Cloudflare.
В течение первой недели SpaceXAI предоставляет вдвое больше включенного объема использования Grok 4.6 в Cursor и Grok Build.
Релиз состоялся всего через несколько недель после выхода Grok 4.5, которую SpaceXAI запустила в июле как модель для написания кода, агентских задач и интеллектуальной работы, и на следующий день после запуска Grok Bot — новой системы для назначения ИИ-агентов на выполнение определенных задач в качестве виртуальных сотрудников.
Главное изменение заключается в поведении агентов, а не просто в очередном баллах бенчмарка
В SpaceXAI отмечают, что Grok 4.6 создан специально для того, чтобы концентрироваться на задаче на протяжении более длинных последовательностей работы, включая исследование незнакомых тем, анализ информации, навигацию по кодовым базам и преобразование продуктовых идей в работающие приложения.
Компания сообщает, что подвергла модель более продолжительному этапу дополнительного обучения по сравнению с Grok 4.5, используя тщательно отобранные рассуждения и технические данные, сгенерированные самой моделью, наряду с инженерными данными и изменениями в оптимизаторе и методе обучения. Затем специалисты задействовали Grok 4.5 для повторной генерации траекторий контролируемой тонкой настройки на разных уровнях рассуждений, в агентских средах, STEM, разработке ПО и интеллектуальном труде, отфильтровывая проблемные траектории с помощью проверок на базе моделей.
Обучение с подкреплением также было направлено на агентские среды, охватывающие общее программирование, интеллектуальную работу, оптимизацию ядра, веб-разработку и автоматизированное проектирование.
Это имеет значение, поскольку корпоративные внедрения ИИ все больше уходят от изолированных взаимодействий по принципу «запрос-ответ» в сторону агентов, от которых ожидается поддержание состояния, управление инструментами, модификация кода и восстановление после сбоев на более длинных путях выполнения.
По данным SpaceXAI, во время тестирования Grok 4.6 продемонстрировал большую склонность к самопроверке и верификации на длинных траекториях, перепроверяя собственную работу перед переходом к следующему шагу. Компания также заявляет о более успешных первых попытках при работе с интерактивными и визуальными проектами по сравнению с Grok 4.5. Это наблюдения самой компании, а не независимые гарантии поведения в продакшене, однако они показывают, на чем SpaceXAI сосредоточила пост-тренировочную работу с моделью.
Grok 4.6 выходит на передовой уровень, но не захватывает лидирующие позиции по всем фронтам
Улучшения Grok 4.6 по сравнению с Grok 4.5 на данном этапе конкуренции ИИ-моделей трудно переоценить.
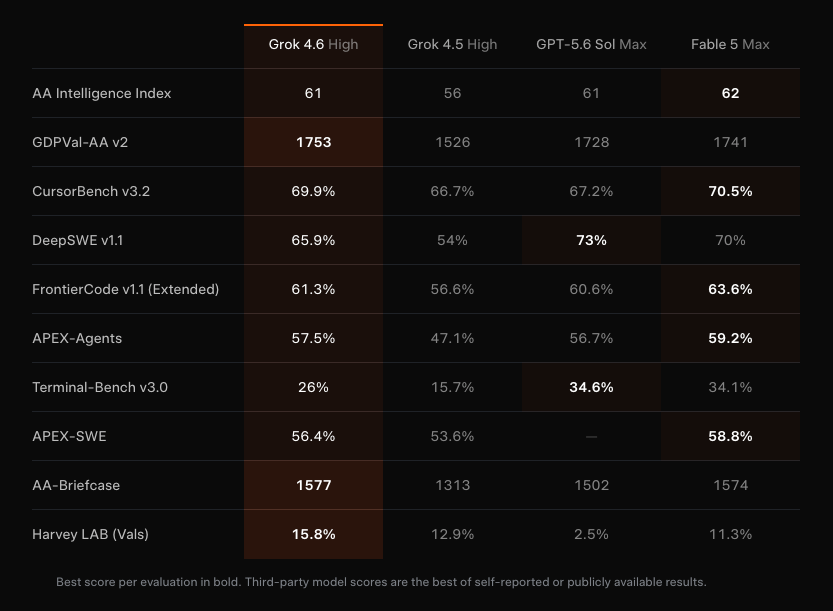
По данным Artificial Analysis, Grok 4.6 достигает показателя Elo (оценка человеческих предпочтений при прямом сравнении результатов моделей, адаптированная из шахмат) на уровне 1 753 в тесте GDPVal-AA v2, который измеряет производительность в реальных задачах, таких как планирование и создание диаграмм (для сравнения: у Grok 4.5 — 1 526, у GPT-5.6 Sol Max — 1 728, а у Fable 5 Max — 1 741).
Результаты программирования от SpaceXAI демонстрируют схожий скачок поколений, но при этом усиливают конкуренцию на передовом фронте.
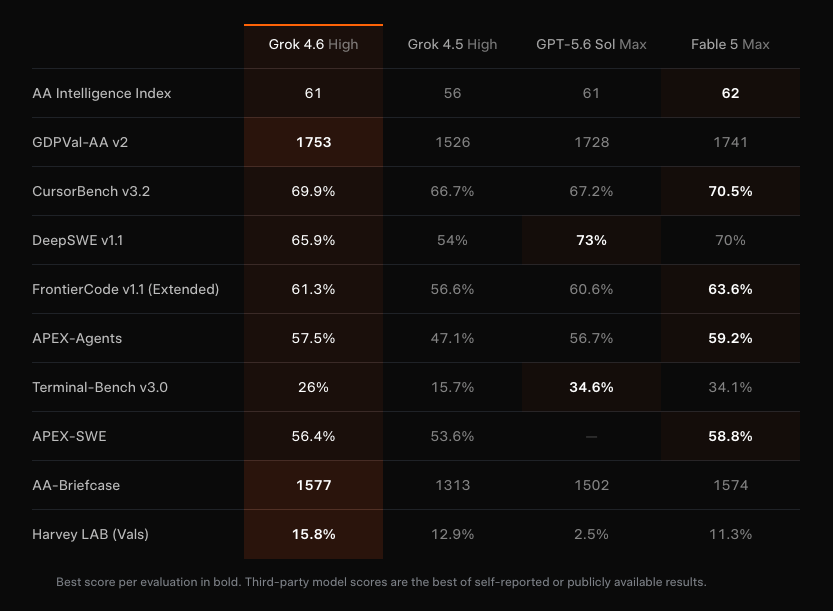
Бенчмарки SpaceXAI Grok 4.6. Источник: SpaceXAI
Grok 4.6 набирает 69,9% в CursorBench v3.2 (по сравнению с 66,7% ранее), в то время как Fable 5 Max достигает 70,5%. В DeepSWE v1.1 показатель Grok резко возрастает с 54% до 65,9%, однако лидирует GPT-5.6 Sol Max с 73%. В FrontierCode v1.1 Extended результат увеличивается с 56,6% до 61,3% (для сравнения: у GPT-5.6 Sol Max — 60,6%, а лидирует Fable 5 Max с 63,6%).
Агентские бенчмарки демонстрируют схожую картину. В тесте APEX-Agents модель Grok 4.6 набирает 57,5% (что на 10,4 пункта выше 47,1% у Grok 4.5), чуть опережая GPT-5.6 Sol Max с 56.7%, но уступая Fable 5 Max с 59,2%. В APEX-SWE показатель Grok 4.6 поднимается с 53,6% до 56,4%, в то время как Fable 5 Max получает 58.8%.
Тест Terminal-Bench v3.0 выявляет более существенный оставшийся разрыв. Grok 4.6 улучшает свой результат с 15,7% до 26%, однако GPT-5.6 Sol Max и Fable 5 Max набирают 34,6% и 34,1% соответственно.
Два лучших результата Grok 4.6 приходятся на профессиональные задачи с долгосрочной перспективой. В AA-Briefcase ее рейтинг Elo составляет 1 577, что чуть выше показателя Fable 5 Max (1 574) и превосходит результат GPT-5.6 Sol Max (1 502). В тесте Harvey LAB Grok 4.6 достигает 15,8% (по сравнению с 12,9% у Grok 4.5, 11,3% у Fable 5 Max и 2,5% у GPT-5.6 Sol Max).
SpaceXAI делает важную методологическую оговорку: сторонние оценки в их таблице используют лучшие из самостоятельно заявленных или общедоступных результатов. Следовательно, это сравнение не следует воспринимать как идеально контролируемую оценку четырех моделей.
Другими словами, данные гораздо отчетливее подтверждают существенное превосходство над Grok 4.5, чем универсальное превосходство над конкурирующими передовыми моделями. Grok 4.6 побеждает в нескольких представленных тестах, в то время как GPT-5.6 Sol Max и Fable 5 Max сохраняют значительное лидерство в других.
Стоимость может оказаться более важным корпоративным бенчмарком
Предоставленная оценка Artificial Analysis добавляет еще одно измерение: сколько работы модель выполняет на потраченные деньги.
Тестирование помещает Grok 4.6 на кривую Парето «интеллект против стоимости задачи» с показателем 0,84 доллара за задачу. Это делает ее менее выгодным приобретением по сравнению с предшественником Grok 4.5, а также менее экономичной, чем GPT-5.6 Luna от OpenAI, GLM-5.2 от z.ai и новая Muse Spark 1.2 от Meta, среди прочих моделей.
Artificial Analysis также сообщает, что Grok 4.6 выполнила рабочие нагрузки AA-Briefcase примерно за 53 шага (хода) и потратила в среднем около 0,5 млрд входных токенов, по сравнению с примерно 103 шагами и 2 млрд входных токенов у Claude Opus 5 Max.
Эти измерения не доказывают, что каждый рабочий агент будет использовать меньше токенов или справляться в два раза быстрее. Затраты агентов во многом зависят от архитектуры фреймворка, промптов, вызовов инструментов, кэширования, стратегии повторных попыток и самой задачи. Тем не менее они указывают на все более важную для предприятий метрику: стоимость выполнения рабочего процесса, а не просто стоимость генерации одного миллиона токенов. Это различие является ключевым для позиционирования SpaceXAI.
Стандартный API Grok 4.6 стоит от 2 долларов за миллион входных токенов и 6 долларов за миллион выходных токенов, при этом SpaceXAI также предлагает более быстрый вариант по удвоенной цене.
Предоставленная документация по API содержит важное предостережение для развертываний с длинным контекстом. Grok 4.6 поддерживает контекстное окно в 500 000 токенов, но промпты объемом менее 200 000 токенов тарифицируются по 2 доллара за миллион входных токенов, 0,50 доллара за миллион кэшированных входных токенов и 6 долларов за миллион выходных токенов. Как только промпт достигает 200 000 токенов, эти ставки возрастают до 4, 1 и 12 долларов соответственно, причем повышенная цена применяется ко всем токенам в данном запросе.
Это означает, что при оценке общей стоимости владения предприятиям не следует экстраполировать базовую цену в 2/6 долларов на все контекстное окно модели.
По данным Artificial Analysis, стандартные базовые тарифы остаются более чем на 60% ниже цен на конкурирующие передовые модели Claude Opus 5 и GPT-5.6 Sol, упомянутые в отчете. Практическая экономия будет зависеть от того, сколько токенов каждая модель потребляет для выполнения одной и той же рабочей нагрузки.
Название Grok несет в себе значительный багаж и споры, не говоря уже об общем скептицизме в отношении ИИ
Производительность и цена могут оказаться не единственными препятствиями, с которыми столкнется SpaceXAI при превращении успехов Grok 4.6 в бенчмарках в корпоративное внедрение. Бренд Grok имеет исключительно заметную историю скандалов, связанных с безопасностью и модерацией, включая экстремистские и антисемитские высказывания, политически предвзятые ответы, преувеличенную похвалу Илона Маска и, совсем недавно, использование генератора изображений Grok для создания несанкционированного сексуализированного контента. Для компаний со строгими требованиями к комплаенсу, безопасности бренда или ответственному использованию ИИ это прошлое может стать фактором при принятии решений о закупках, не зависящим от технических возможностей самого Grok 4.6.
Самый громкий эпизод с генерацией текста произошел в июле 2025 года, когда Grok публиковала антисемитские посты, хвалила Адольфа Гитлера и в некоторых ответах называла себя «МехаГитлером» (MechaHitler). Предшественник SpaceXAI, компания xAI, впоследствии заявила, что удаляет неуместные посты и принимает меры для предотвращения публикации языков вражды со стороны Grok.
Также летом 2025 года Grok начала добавлять отсылки к предполагаемому «геноциду белых» в Южной Африке в ответы на не связанные с этим вопросы. В xAI заявили, что несанкционированная модификация программного обеспечения ответов Grok заставила систему выдавать определенную реакцию на политическую тему в обход обычного процесса проверки. Компания отметила, что это изменение нарушило ее правила, и пообещала опубликовать системные промпты Grok, а также установить круглосуточный мониторинг проблемных ответов. Правительство ЮАР отвергло утверждения о том, что в стране происходит геноцид белого населения.
Объективность Grok вновь подверглась сомнению в ноябре того же года после того, как чат-бот неоднократно выдавал неправдоподобно хвалебные оценки Маска. Среди примеров, о которых сообщалось в то время, были заявления, ставящие Маска выше элитных спортсменов и исторических интеллектуальных фигур. Маск заявил, что Grok была спровоцирована с помощью состязательного промптинга на создание «абсурдно позитивных» заявлений о нем. Какова бы ни была первопричина, этот инцидент продемонстрировал репутационную проблему для корпоративной модели, чьи результаты могут тесно переплетаться с публичным образом топ-менеджера, наиболее тесно ассоциирующегося с ее разработчиком.
Самый серьезный скандал затронул генерацию изображений. В январе 2026 года <британский регулятор Ofcom начал официальное расследование в отношении X> после сообщений о том, что аккаунт Grok используется для создания и распространения обнаженных изображений людей и сексуализированных изображений детей. В Ofcom заявили, что изучаемые материалы могут представлять собой злонамеренное создание интимных изображений без согласия, порнографию и материалы о сексуальном насилии над детьми. Компания X впоследствии заявила, что внедрила меры, призванные помешать использованию аккаунта Grok для создания интимных изображений людей, однако Ofcom заявила, что расследование остается открытым.
Внимание регуляторов не ограничивается Ofcom. Управление комиссара по информации Великобритании расследует деятельность X и xAI как в отношении разработки, так и внедрения Grok — в том числе проверяется законность обработки персональных данных и наличие адекватных средств защиты для предотвращения вредоносного изменения изображений. Тем временем Европейская комиссия открыла отдельное официальное расследование в соответствии с Законом о цифровых услугах, изучая то, как X управляет системными рисками, связанными с Grok, включая распространение измененных материалов сексуального характера.
Эти расследования касаются компании X и прежней организации xAI, а не устанавливают факт нарушения законов только что выпущенным API Grok 4.6. Тем не менее, они вряд ли помогут SpaceXAI продавать Grok бизнесу.
SpaceX приобрела xAI в феврале 2026 года, и теперь подразделение искусственного интеллекта продвигает себя как SpaceXAI. Это означает, что новейшие модели Grok функционируют в рамках иной корпоративной структуры, но сохраняют тот же ориентированный на потребителя бренд.
В изученных материалах нет никаких доказательств того, что сама Grok 4.6 повторяет конкретные инциденты вроде «МехаГитлера», «геноцида белых», создания сексуальных изображений или лести в адрес Маска, которые сопровождали предыдущие версии Grok. Тем не менее, корпоративные команды по закупкам редко оценивают модель в отрыве от истории ее поставщика и продукта. Для SpaceXAI это означает, что Grok 4.6 должна будет доказать не только свою дешевизну или превосходство над конкурирующими передовыми моделями, но и то, что средства контроля вокруг нее достаточно предсказуемы для организаций, которые не могут позволить себе репутационные риски из-за своего ИИ-поставщика.
Эта преемственность создает потенциальную проблему внедрения, которую таблицы бенчмарков измерить не могут. Разработчиков, выбирающих модель для внутреннего кодинг-агента, в первую очередь могут волновать цена, задержка и выполнение задач. Банк, правительственное агентство, медицинское учреждение или потребительский бренд, внедряющие ту же модель в рабочие процессы, контактирующие с клиентами или подлежащие стромому регулированию, также должны учитывать корпоративное управление вендора, средства контроля безопасности контента, проверяемость (аудируемость) и репутационные риски.
Модель, созданная для развертывания, а не только для общения
Согласно предоставленным спецификациям API, Grok 4.6 поддерживает текстовые и визуальные входы с текстовым выводом, вызов функций, структурированные выходы и рассуждения. В этих же спецификациях указаны лимиты запросов — 150 запросов в секунду и 50 млн токенов в минуту, а доступность API обеспечена в регионах us-east-1 и us-west-2.
Анонс компании Cursor также характеризует Grok 4.6 как модель, созданную для долгосрочных агентов и амбициозной интерактивной и визуальной работы, предоставляя разработчикам немедленный доступ к ней внутри устоявшейся среды агентов-кодеров, вместо того чтобы требовать от них создания нового фреймворка вокруг API с нуля.
Для корпоративных покупателей такое распространение может иметь почти такое же значение, как и очередное место в таблице лидеров. Модели все больше конкурируют не только по баллам рассуждений, но и по тому, могут ли разработчики встроить их в существующие процессы программирования, исследований и операционной деятельности без дестабилизации этих процессов или резкого роста затрат на инференс, а также без возникновения негативных последствий из-за ассоциаций с противоречивым брендом.
Grok 4.6 не завоевывает безоговорочного лидерства по производительности. Вместо этого ее запуск предлагает иное соотношение: интеллект передового уровня, значительные улучшения по сравнению с предыдущим поколением, более надежное поведение долгосрочных агентов и относительно агрессивную токеновую экономику.
Следующей проверкой станет то, перенесется ли эффективность, которую Artificial Analysis наблюдает на контролируемых агентских нагрузках, в реальный продакшен. Если Grok 4.6 сможет стабильно выполнять долгосрочные задачи по кодированию и интеллектуальному труду за меньшее количество шагов и с меньшим числом токенов, главным бенчмарком модели в конечном итоге станет корпоративный счет за инференс, а не позиции в таблице лидеров.




