


Представлен GPT-5.5 от OpenAI, и это не шутка: модель с небольшим отрывом опережает Claude Mythos Preview от Anthropic в Terminal-Bench 2.0
Источник: VentureBeat · Carl Franzen


После месяцев слухов и сообщений о том, что OpenAI разрабатывает новую, более мощную большую языковую модель ИИ для использования в ChatGPT и через свой программный интерфейс приложений (API), которая внутри компании предположительно носила кодовое имя «Spud», сегодня компания представила свою новейшую разработку под более официальным названием GPT-5.5.
И, к чему-то удивлению, это вовсе не «картошка» (potatо) в уничижительном смысле этого слова: GPT-5.5 возвращает компании OpenAI лидерство среди общедоступных языковых моделей, опережая новейшие публичные предложения конкурентов Anthropic и Google, и даже немного обходя закрытую модель Anthropic Claude Mythos Preview в одном из бенчмарков (что по сути является статистической ничьей).
«Это определенно наша самая сильная модель на сегодняшний день в написании кода — как по результатам бенчмарков, так и на основе отзывов, полученных от проверенных партнеров, а также нашего собственного опыта», — пояснила Амелия «Миа» Глез (Amelia «Mia» Glaese), вице-президент по исследованиям в OpenAI, в видеоразговоре с журналистами в преддверии сегодняшнего запуска.
OpenAI позиционирует GPT-5.5 как фундаментальный редизайн того, как искусственный интеллект взаимодействует с операционной системой компьютера и профессиональными программными стеками.
«Что действительно особенного в этой модели, так это то, сколько всего она может делать при минимальном вмешательстве», — заявил соучредитель и президент OpenAI Грег Брокман (Greg Brockman) на том же совещании. — Ею намного интуитивнее пользоваться. Она может проанализировать неясную проблему и понять, что нужно делать дальше».
Далее Брокман подчеркнул те области, в которых пользователи могут ожидать прироста эффективности от использования GPT-5.5 по сравнению с предыдущей передовой моделью OpenAI — GPT-5.4, которая пока остается доступной для пользователей и предприятий по цене API вдвое ниже стоимости ее нового преемника.
«Она чрезвычайно хороша в программировании», — сказал Брокман о GPT-5.5. — Она также отлично справляется с более широкими компьютерными задачами, использованием компьютера, научными исследованиями — приложениями такого рода, которые являются очень серьезными интеллектуальными узкими местами».
Генеральный директор и соучредитель OpenAI Сэм Альтман также высказался о запуске и философии компании в посте на X, написав, в частности: «Мы хотим, чтобы у наших пользователей был доступ к лучшим технологиям, а у каждого — равные возможности».
Модель доступна в двух вариантах: GPT-5.5 и GPT-5.5 Pro. Последняя отличается повышенной точностью и специализированной логикой для решения самых сложных когнитивных задач.
В то время как стандартная версия служит универсальным флагманом для общих интеллектуальных задач, модель Pro создана специально для критически важных сред, таких как юридические исследования, наука о данных и продвинутая бизнес-аналитика, где точность имеет первостепенное значение. Этот премиальный уровень обеспечивает заметно более исчерпывающие и структурированные ответы при поддержке специализированной оптимизации задержек, которая гарантирует высокое качество работы в ходе сложных многоэтапных рабочих процессов.
К сожалению для сторонних разработчиков программного обеспечения, доступ к API для GPT-5.5 и GPT-5.5 Pro пока недоступен и появится «совсем скоро», согласно блогу компании с анонсом.
«Развертывание API требует дополнительных мер безопасности, и мы тесно сотрудничаем с партнерами и клиентами над требованиями безопасности и защиты для масштабного предоставления модели», — пишет OpenAI.
В настоящее время GPT-5.5 доступна только платящим подписчикам ChatGPT Plus ($20 в месяц), Pro ($100–$200 в месяц), а также корпоративным пользователям (Business и Enterprise), причем доступ к GPT-5.5 Pro начинается с уровня Pro и выше.
Фокус на автономности
В основе GPT-5.5 лежит упор на «агентную» производительность — в частности, в написании кода, использовании компьютера и научных исследованиях.
В отличие от своих предшественниц, которые часто требовали детальных пошаговых подсказок во избежание «галлюцинаций» на пути к цели, GPT-5.5 разработана для автономного решения сложных многосоставных задач.
Она превосходно справляется с поиском информации в сети, отладкой сложных кодовых баз и перемещением между документами и электронными таблицами без вмешательства человека.
Одним из наиболее значительных технических скачков является эффективность модели. Хотя более крупные модели обычно страдают от увеличения задержки (latency), GPT-5.5 сохраняет задержку на токен на уровне предыдущей GPT-5.4, обеспечивая при этом более высокий уровень интеллекта.
Это было достигнуто благодаря глубокой совместной разработке аппаратного и программного обеспечения. OpenAI развернула GPT-5.5 на системах NVIDIA GB200 и GB300 NVL72, используя пользовательские эвристические алгоритмы, написанные самим ИИ, для распределения и балансировки работы между ядрами графического процессора.
Сообщается, что эта оптимизация увеличила скорость генерации токенов более чем на 20%. Для рассуждений в критически важных ситуациях режим «GPT-5.5 Thinking» в ChatGPT выдает более умные и точные ответы, позволяя модели выделять больше внутреннего «времени вычислений» на проверку собственных предположений перед ответом.
Эта способность особенно заметна в результатах модели в «Expert-SWE» — внутреннем бенчмарке OpenAI для долгосрочных задач по программированию, на выполнение которых у человека-эксперта в среднем уходит 20 часов. GPT-5.5 заметно превзошла GPT-5.4 по этому показателю, используя при этом значительно меньше токенов.
Бенчмарки показывают, что OpenAI вернула себе лидерство среди самых мощных общедоступных языковых моделей, обогнав Claude Opus 4.7 (однако невыпущенная Mythos все еще превосходит ее)
Рынок ведущих американских передовых моделей превратился в жесткую гонку между OpenAI, Anthropic и Google.
Ровно неделю назад, день в день, конкурент OpenAI компания Anthropic выпустила Opus 4.7, свою самую мощную общедоступную модель, захватив лидерство по количеству сторонних тестов в бенчмарках, в которых она побеждает.
Тем не менее, сегодня GPT-5.5 превзошла ее и даже сильно ограниченную, более мощную модель Anthropic Claude Mythos Preview, хотя и только в одном бенчмарке — Terminal-Bench 2.0, который проверяет «способность модели ориентироваться и выполнять задачи в изолированной среде терминала (sandbox)».
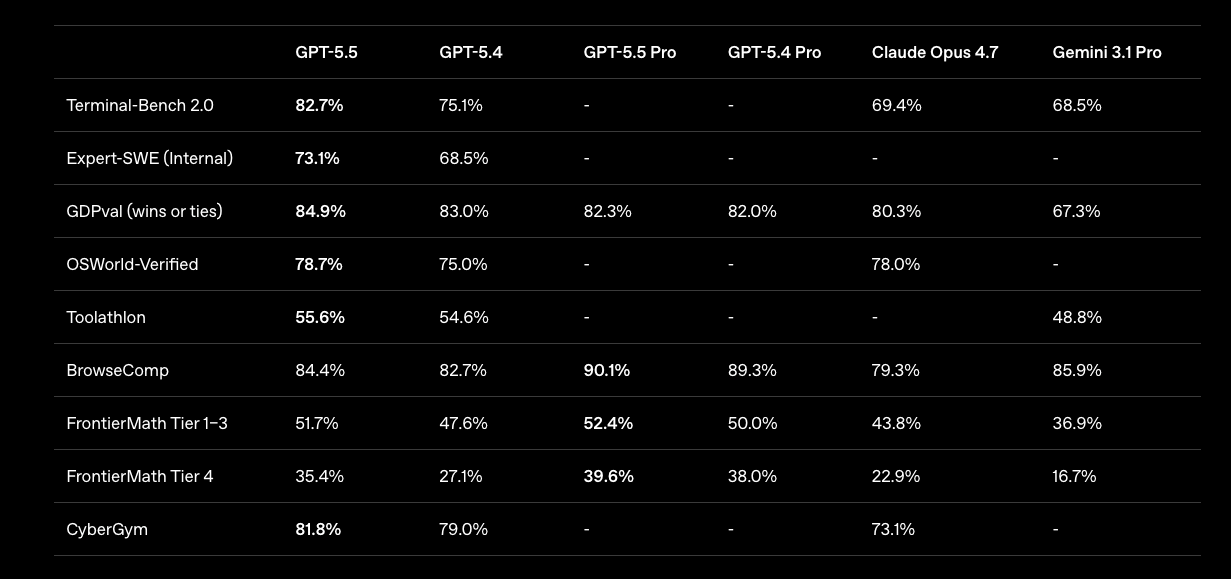
GPT-5.5 показала точность 82,7% в Terminal-Bench 2.0, легко опередив Opus 4.7 (69,4%) и незначительно обогнав Mythos Preview (82,0%).
Сравнительная таблица бенчмарков OpenAI GPT-5.5. Источник: OpenAI
Однако в междисциплинарных рассуждениях без использования инструментов ситуация выглядит более конкурентной. В тесте Humanity’s Last Exam без использования инструментов GPT-5.5 Pro набрала 43,1%, отстав от Opus 4.7 (46,9%) и Mythos Preview (56.8%).
|
Бенчмарк |
GPT-5.5 |
Claude Opus 4.7 |
Gemini 3.1 Pro |
Mythos Preview* |
|
Terminal-Bench 2.0 |
82.7 |
69.4 |
68.5 |
82.0 |
|
Expert-SWE (Внутренний) |
73.1 |
— |
— |
— |
|
GDPval (победы или ничьи) |
84.9 |
80.3 |
67.3 |
— |
|
OSWorld-Verified |
78.7 |
78.0 |
— |
79.6 |
|
Toolathlon |
55.6 |
— |
48.8 |
— |
|
BrowseComp |
84.4 |
79.3 |
85.9 |
86.9 |
|
FrontierMath Tier 1–3 |
51.7 |
43.8 |
36.9 |
— |
|
FrontierMath Tier 4 |
35.4 |
22.9 |
16.7 |
— |
|
CyberGym |
81.8 |
73.1 |
— |
83.1 |
|
Tau2-bench Telecom (исходные промпты) |
98.0 |
— |
— |
— |
|
OfficeQA Pro |
54.1 |
43.6 |
18.1 |
— |
|
Задачи финансового моделирования в инвестиционном банкинге (Внутренние) |
88.5 |
— |
— |
— |
|
MMMU Pro (без инструментов) |
81.2 |
— |
80.5 |
— |
|
MMMU Pro (с инструментами) |
83.2 |
— |
— |
— |
|
GeneBench |
25.0 |
— |
— |
— |
|
BixBench |
80.5 |
— |
— |
— |
|
Задачи соревнования Capture-the-Flags (Внутренние) |
88.1 |
— |
— |
— |
|
ARC-AGI-2 (Проверенный) |
85.0 |
75.8 |
77.1 |
— |
|
SWE-bench Pro (Публичный) |
58.6 |
64.3 |
54.2 |
77.8 |
Это говорит о том, что в то время как OpenAI побеждает в категориях «использование компьютера» и «автономность», другие модели все еще могут сохранять преимущество в сфере чистых академических знаний без предварительного обучения (zero-shot).
Важно уточнить, что Mythos Preview не является общедоступным продуктом: Anthropic классифицировала его как стратегический защитный актив из-за высоких рисков в сфере кибербезопасности, ограничив к нему доступ небольшой и узкой аудиторией проверенных партнеров и государственных ведомств.
Поскольку Mythos исключена из широкого коммерческого использования, основная рыночная конкуренция по-прежнему разворачивается между GPT-5.5, Gemini 3.1 Pro и Claude Opus 4.7.
Таким образом, когда речь заходит о моделях, доступных широкой публике, GPT-5.5 вернула себе корону для OpenAI, достигнув передового уровня в 14 бенчмарках против 4 у Claude Opus 4.7 и 2 у Google Gemini 3.1 Pro.
Она доминирует в агентном использовании компьютера, экономической умственной работе (GDPval), специализированной кибербезопасности (CyberGym) и сложной математике (Frontier Math).
В сравнении с этим Claude Opus 4.7 лидирует в разработке программного обеспечения и рассуждениях без инструментов, а Gemini 3.1 Pro лидирует в трех категориях, особенно преуспевая в академических рассуждениях и финансовом анализе.
Рост затрат для пользователей
Повышение уровня интеллекта сопровождается значительным ростом цен для разработчиков API, согласно материалам, которыми OpenAI поделилась перед публичным релизом модели.
OpenAI фактически удвоила начальную цену своей флагманской модели по сравнению с предыдущим поколением и снова удвоила ее для самого передового варианта модели — GPT-5.5 Pro:
|
Модель |
Цена за вход (за 1 млн токенов) |
Цена за выход (за 1 млн токенов) |
|
GPT-5.4 |
$2.50 |
$15.00 |
|
GPT-5.5 |
$5.00 |
$30.00 |
|
GPT-5.5 Pro |
$30.00 |
$180.00 |
Чтобы смягчить эти расходы, OpenAI подчеркивает, что GPT-5.5 более «эффективна с точки зрения токенов», что означает использование меньшего количества токенов для выполнения той же задачи по сравнению с GPT-5.4.
Для пользователей, которым важнее скорость, а не глубина анализа, OpenAI также представила быстрый режим (Fast mode) в Codex, который генерирует токены в 1,5 раза быстрее, но с наценкой в 2,5 раза.
Уровни «mini» и «nano», существовавшие в эпоху GPT-5.4 (стоимостью $0,75 и $0,20 за 1 млн входных токенов соответственно), в настоящее время не имеют аналогов в линейке GPT-5.5, хотя компания отмечает, что GPT-5.5 внедряется на всех уровнях подписки, включая Plus, Pro и Enterprise.
Лицензирование и «кибер-снисходительный» передовой рубеж
Подход OpenAI к безопасности и лицензированию GPT-5.5 представляет новую концепцию: доверенный доступ для сферы кибербезопасности (Trusted Access for Cyber). Поскольку теперь модель способна выявлять и устранять сложные уязвимости в системе безопасности, OpenAI внедрила более строгие «классификаторы киберрисков» для обычных пользователей.
Однако для легитимных специалистов по безопасности OpenAI предлагает специализированную «кибер-снисходительную» лицензию. Эта программа позволяет проверенным защитникам — лицам, отвечающим за критическую инфраструктуру, такую как электросети или водоснабжение — использовать такие модели, как GPT-5.4-Cyber, или неограниченные версии GPT-5.5 с меньшим числом отказов на запросы, связанные с безопасностью.
Эта концепция двойного назначения признает, что хотя ИИ может ускорить киберзащиту, он также может быть превращен в оружие. В соответствии с Рамочной программой готовности OpenAI (Preparedness Framework), GPT-5.5 классифицируется как модель с «высоким» уровнем риска в отношении биологических угроз и кибербезопасности.
Для управления этими рисками развертывание API в настоящее время требует иных мер безопасности, чем ориентированный на потребителя ChatGPT, и OpenAI сотрудничает с правительственными партнерами, чтобы гарантировать, что эти инструменты используются для укрепления, а не подрыва цифровой устойчивости.
Первые реакции: потеря доступа ощущается как «ампутация конечности»
Первые отзывы опытных пользователей и инженеров свидетельствуют о том, что GPT-5.5 перешла психологический рубеж в полезности ИИ. Для разработчиков отличительной особенностью модели стала ее способность сохранять «концептуальную ясность» в огромных кодовых базах.
«Первая модель для программирования из всех, что я использовал, обладающая серьезной концептуальной ясностью», — отметил Дэн Шиппер (Dan Shipper), генеральный директор Every.
Шиппер протестировал модель, попросив ее отладить сложный системный сбой, для устранения которого ранее требовалась команда инженеров-людей, переписавшая код; GPT-5.5 самостоятельно создала аналогичное исправление. Аналогичным образом Пьетро Ширано (Pietro Schirano), генеральный директор MagicPath, описал «качественный скачок» в производительности, когда модель успешно объединила ветку с сотнями изменений рефакторинга в основную ветку за один 20-летний минутный проход. Пожалуй, самая яркая реакция последовала от анонимного инженера из NVIDIA, у которого был ранний доступ к модели:
«Потеря доступа к GPT-5.5 ощущается так, будто мне ампутировали конечность».
Это мнение разделяют и в научном сообществе. Дерья Унутмаз (Derya Unutmaz), профессор Лаборатории Джексона по геномной медицине, использовал GPT-5.5 Pro для анализа набора данных из 28 000 генов, подготовив за считанные минуты отчет, на составление которого у его команды обычно уходят месяцы.
Брэндон Уайт (Brandon White), генеральный директор Axiom Bio, пошел еще дальше, заявив, что если OpenAI продолжит двигаться с таким темпом, «основы разработки лекарств изменятся уже к концу года».
GPT-5.5 — это больше, чем просто поэтапное обновление; это инструмент, созданный для мира, в котором люди делегируют целые рабочие процессы, а не отдельные промпты. Хотя затраты выше, а меры безопасности жестче, прирост производительности в агентной работе говорит о том, что ИИ наконец выходит за рамки чат-бота и интегрируется непосредственно в операционную систему.
Что, пожалуй, самое поразительное: по словам исследователей компании, ограничения масштабирования (когда модели обучаются на все большем числе графических процессоров) еще далеко не исчерпаны.
«У нас фактически все еще есть потенциал для обучения гораздо более умных моделей, чем эта», — заявил главный научный сотрудник OpenAI Якуб Пахоцкий (Jakub Pachocki).




