NVFP4 от Nvidia сокращает использование памяти языковыми моделями вдвое


Исследователи из Nvidia разработали новый подход к обучению больших языковых моделей (LLM) в 4-битном квантованном формате с сохранением их стабильности и точности на уровне высокоточных моделей. Их методика, получившая название NVFP4, позволяет обучать модели, которые не только превосходят другие ведущие 4-битные форматы, но и не уступают по производительности более крупному 8-битному формату FP8, используя при этом вдвое меньше памяти и лишь малую долю вычислительных ресурсов.
Успех NVFP4 показывает, что компании могут и дальше снижать затраты на инференс, запуская более компактные модели, не уступающие по производительности более крупным аналогам. Это также намекает на будущее, в котором стоимость обучения LLM снизится настолько, что значительно больше организаций смогут обучать собственные заказные модели с нуля, а не просто дорабатывать (fine-tuning) существующие.
Проблема квантования
Квантование моделей — это метод, используемый для снижения вычислительных затрат и затрат памяти на запуск и обучение моделей ИИ. Он работает путем преобразования параметров модели (или весов) из высокоточных форматов, таких как 16- и 32-битная плавающая запятая (BF16 и FP32), в форматы с более низкой точностью. Главная задача квантования заключается в уменьшении размера модели при сохранении как можно большей части ее знаний и возможностей.
В последние годы 8-битные форматы с плавающей запятой (FP8) стали популярным отраслевым стандартом, предлагая хороший баланс между производительностью и эффективностью. Они значительно снижают вычислительные затраты и требования к памяти для обучения LLM без существенного падения точности.
Следующим логичным шагом является 4-битная плавающая запятая (FP4), которая обещает снова сократить использование памяти вдвое и еще больше повысить производительность на современном «железе». Однако этот переход оказался сложным. Существующие 4-битные форматы, такие как MXFP4, часто с трудом поддерживают тот же уровень точности, что и их 8-битные аналоги, что вынуждает идти на сложный компромисс между стоимостью и производительностью.
Как работает NVFP4
NVFP4 преодолевает проблемы стабильности и точности, свойственные другим методам FP4, благодаря более продуманному дизайну и целенаправленной методологии обучения. Ключевая проблема 4-битной точности заключается в ее крайне ограниченном диапазоне: она может представлять только 16 различных значений. При конвертации из высокоточного формата выбросы (outlier values) могут исказить весь набор данных, ухудшив точность модели. В NVFP4 используется более сложный многоуровневый подход к масштабированию, который лучше справляется с такими выбросами, обеспечивая «более точное и корректное представление значений тензоров в процессе обучения», заявляют в Nvidia.
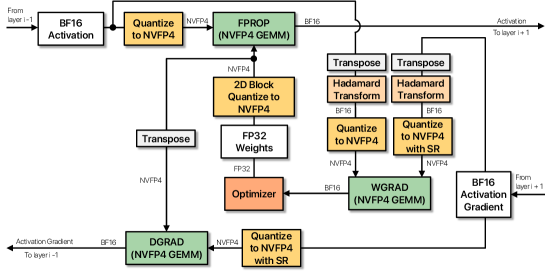
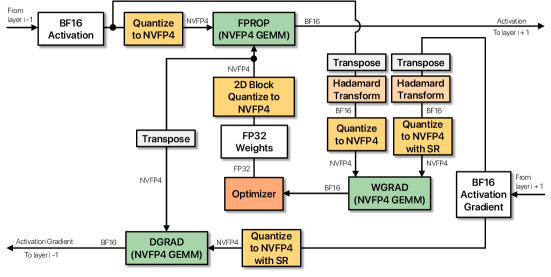
Архитектура NVFP4 (источник: arXiv)
Помимо самого формата, исследователи представили 4-битную схему обучения, которая обеспечивает точность, сопоставимую с FP8. Центральным компонентом является их «стратегия смешанной точности». Вместо преобразования всей модели в NVFP4, большинство слоев квантуются, в то время как небольшая часть чувствительных к числам слоев сохраняется в формате повышенной точности, таком как BF16. Это позволяет сохранить стабильность там, где это наиболее важно. Методология также корректирует способ вычисления градиентов во время обратного распространения ошибки (фазы обучения модели) для уменьшения смещений, которые могут накапливаться из-за арифметики пониженной точности.
NVFP4 на практике
Для проверки своего подхода команда Nvidia обучила мощную гибридную модель Mamba-Transformer с 12 миллиардами параметров на колоссальном объеме в 10 триллионов токенов. Затем они напрямую сравнили ее производительность с базовой моделью, обученной в популярном формате FP8. Результаты показали, что потери при обучении (training loss) и точность на прикладных задачах у модели NVFP4 тесно следовали за версией FP8 на протяжении всего процесса.
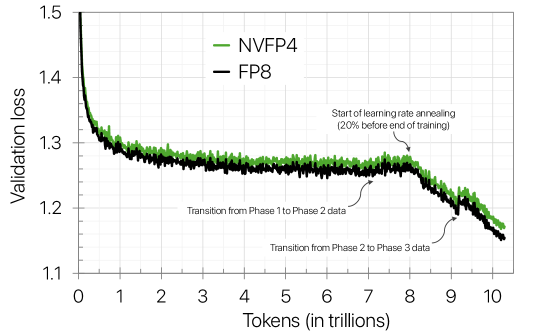
Кривая обучения NVFP4 практически совпадает с кривой высокоточного формата FP8 (источник: arXiv)
Производительность сохранялась в самых разных областях, включая ресурсоемкие рассуждения, математику и задачи на основе здравого смысла, с лишь небольшим отставанием на бенчмарках по программированию на поздних этапах обучения.
«Насколько нам известно, это первая успешная демонстрация обучения языковых моделей с миллиардами параметров с 4-битной точностью на горизонте в несколько триллионов токенов, что закладывает основу для более быстрого и эффективного обучения будущих передовых моделей», — пишут исследователи.
По словам директора по продукции Nvidia в области ИИ и графических процессоров для дата-центров Шар Нарасимхан (Shar Narasimhan), на практике 4-битный формат точности NVFP4 позволяет разработчикам и предприятиям обучать и развертывать модели ИИ практически с той же точностью, что и традиционные 8-битные форматы.
«Осуществляя обучение весов модели непосредственно в 4-битном формате с сохранением точности, мы даем разработчикам возможность экспериментировать с новыми архитектурами, быстрее проводить итерации и находить инсайты, не упираясь в ограничения ресурсов», — рассказал он VentureBeat.
В то же время FP8 (хотя уже и являясь шагом вперед по сравнению с FP16) по-прежнему накладывает ограничения на размер моделей и производительность инференса из-за повышенных требований к памяти и пропускной способности. «NVFP4 преодолевает этот барьер, предлагая эквивалентное качество при значительно больших возможностях для роста и экспериментов», — отметил Нарасимхан.
По сравнению с альтернативным 4-битным форматом MXFP4, преимущества NVFP4 становятся еще более очевидными. В эксперименте с моделью на 8 миллиардов параметров NVFP4 сошлась к лучшей оценке потерь (loss score), чем MXFP4. Чтобы достичь того же уровня производительности, что и модель NVFP4, модель MXFP4 пришлось обучать на 36% большем объеме данных, что существенно увеличило время и стоимость обучения.
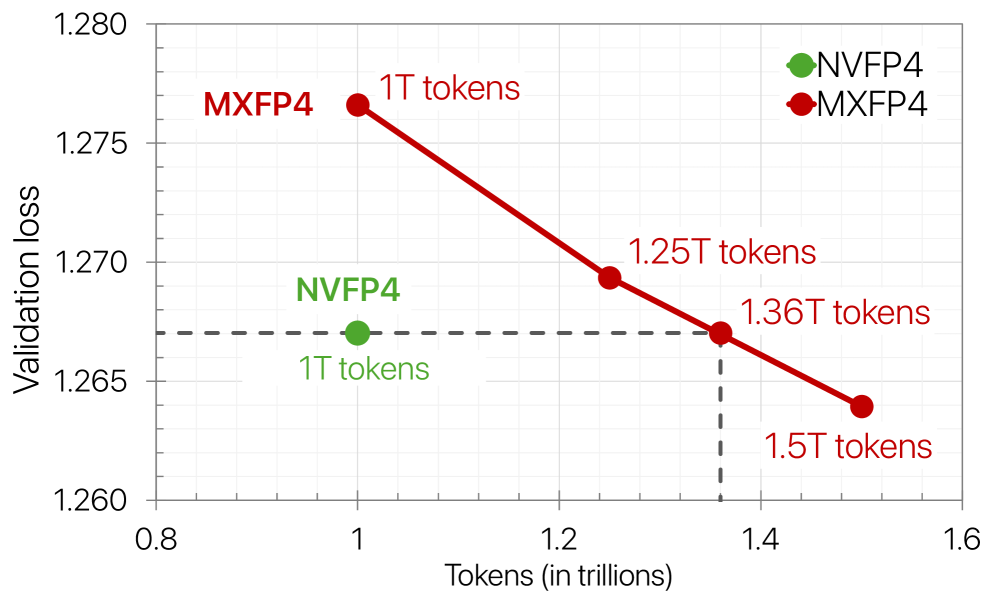
Для MXFP4 требуется в 1,36 раза больше токенов, чем для NVFP4 (источник: arXiv)
Помимо повышения эффективности предварительного обучения, NVFP4 также переосмысливает то, что считается возможным. «Тот факт, что 4-битная точность способна сохранять качество модели в масштабе, открывает дверь в будущее, где высокоспециализированные модели смогут обучаться с нуля средними предприятиями или стартапами, а не только гиперскейлерами», — сказал Нарасимхан, добавив, что со временем можно ожидать перехода от разработки универсальных LLM-моделей к «разнообразной экосистеме кастомных высокопроизводительных моделей, создаваемых более широким кругом инноваторов».
За пределами предварительного обучения
Хотя в научной работе основное внимание уделяется преимуществам NVFP4 на этапе предварительного обучения, ее влияние распространяется и на инференс.
«Модели, обученные на NVFP4, могут не только обеспечить более быстрый инференс и высокую пропускную способность, но и сократить время, необходимое ИИ-фабрикам для достижения окупаемости инвестиций (ROI), ускоряя цикл от разработки модели до ее развертывания в реальном мире», — заявил Нарасимхан.
Поскольку эти модели меньше по размеру и эффективнее, они открывают новые возможности для обработки сложных высококачественных ответов в реальном времени — даже в токеноемких агентских приложениях — без увеличения затрат на электроэнергию и вычисления.
Нарасимхан отметил, что видит будущее эффективности моделей не только в снижении точности, но и в создании более умных систем.
«Существует множество возможностей для расширения исследований в области еще более низких точностей, а также модификации архитектур для оптимизации компонентов, которые во все большей мере доминируют в вычислениях в крупномасштабных моделях», — сказал он. «Эти направления сулят огромные возможности, особенно по мере нашего перехода к агентским системам, требующим высокой пропускной способности, низкой задержки и адаптивных рассуждений. NVFP4 доказывает, что точность можно оптимизировать без ущерба для качества, и закладывает основу для новой эры интеллектуального и эффективного проектирования ИИ».