Инструмент W&L от Google Cloud ускоряет обучение CUA


Новый фреймворк, разработанный исследователями из Google Cloud и DeepMind, призван решить одну из главных проблем разработки агентов для работы с компьютером (computer use agents, CUA) — сбор качественных обучающих примеров в больших объемах.
Фреймворк, получивший название Watch & Learn (W&L), решает задачу генерации обучающих данных способом, который не требует участия человека для аннотирования и позволяет автоматически извлекать демонстрации из «сырых» видеозаписей.
Их эксперименты показывают, что данные, сгенерированные с помощью W&L, можно использовать для обучения или дообучения существующих агентов и базовых моделей для работы с компьютером с целью повышения их эффективности в профильных задачах. Но что не менее важно, этот же подход можно применять для создания примеров контекстного обучения (in-context learning, ICL) для компьютерных агентов, позволяя компаниям создавать CUA для специализированных внутренних задач без необходимости дорогостоящего обучения узкоспециализированных моделей.
Узкое горлышко данных для CUA
В интернете полно видеоуроков и скринкастов, описывающих сложные рабочие процессы при использовании приложений. Эти видео — настоящая золотая жила, которая может обеспечить агентов для работы с компьютером предметными знаниями и инструкциями для выполнения различных задач через взаимодействие с пользовательским интерфейсом.
Однако прежде чем их можно будет использовать для обучения агентов CUA, эти видео необходимо преобразовать в аннотированные траектории (то есть набор описаний задач, скриншотов и действий). Этот процесс вручную оказывается чрезвычайно дорогим и трудоемким.
Существующие подходы к решению этой проблемы нехватки данных опираются на аннотирование таких видео с помощью мультимодальных языковых моделей, что обычно приводит к низкой точности и ошибочным примерам. Другой подход использует агентов самообучения (self-play), которые автономно исследуют интерфейсы для сбора траекторий. Тем не менее, методы на основе этого подхода обычно создают простейшие примеры, бесполезные в непредсказуемых ситуациях реального мира.
Как отмечают исследователи в своей работе: «В целом эти подходы либо опираются на хрупкие эвристики, либо дороги, поскольку требуют исследований в реальных средах, либо генерируют демонстрации низкой сложности, не соотносимые с намерениями человека».
Watch & Learn
Фреймворк Watch & Learn пытается решить проблемы создания демонстраций для CUA за счет переосмысления формулировки самой задачи.
Вместо прямой генерации траекторий или использования сложных многоэтапных пайплайнов исследователи формулируют проблему как «целевую обратную динамику»: по двум последовательным наблюдениям предсказать промежуточное действие, которое привело к этому переходу.
По словам исследователей, такая формулировка «проще для обучения, позволяет избежать созданных вручную эвристик и надежно генерализуется в различных приложениях».
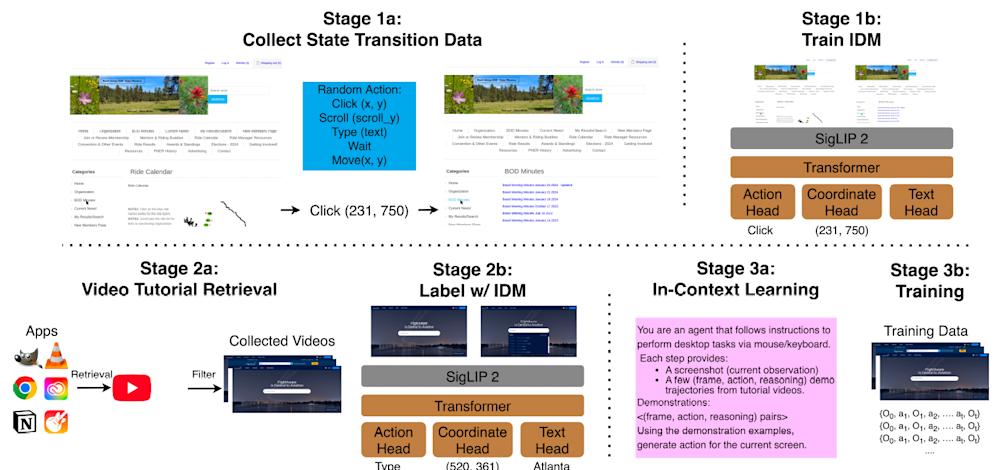
Фреймворк W&L можно разделить на три ключевых этапа: обучение модели обратной динамики (inverse dynamics model, IDM), извлечение исходных видео и обучение агентов CUA.
Фреймворк Watch & Learn (источник: arXiv)
На первом этапе исследователи использовали агентов для взаимодействия с реальными веб-страницами, чтобы собрать обширный корпус из 500 000 состояний переходов (два последовательных наблюдения и действие, приведшее к переходу). Затем они использовали эти данные (наряду с 132 000 аннотированными человеком переходами из существующих открытых наборов данных) для обучения модели обратной динамики (IDM), которая принимает на вход два последовательных наблюдения и прогнозирует действие перехода. Обученная ими IDM, представляющая собой небольшую модель-трансформер, превзошла готовые базовые модели в прогнозировании действий при переходе.
Затем исследователи разработали конвейер (пайплайн), который извлекает видео с таких платформ, как YouTube, и пропускает их через IDM для генерации высококачественных траекторий. IDM принимает последовательные кадры видео и определяет действия (прокрутка, клик), которые вызвали изменения в окружении, после чего они упаковываются в аннотированные траектории. Используя этот метод, они сгенерировали 53 125 траекторий с высокоточными метками действий.
Эти примеры можно использовать для обучения эффективных компьютерных моделей для конкретных задач. Однако исследователи также обнаружили, что траектории, извлеченные с помощью IDM, могут служить примерами для контекстного обучения, улучшая производительность CUA при решении специализированных задач на этапе инференса. Для ICL они используют Gemini 2.5 Flash, чтобы добавить дополнительные аннотации рассуждений к примерам наблюдений/действий в траекториях, которые затем могут быть встроены в промпт агента CUA (обычно 3–5 примеров) во время инференса.
«Эта двойная роль (обучение и контекстное руководство) обеспечивает гибкую интеграцию как с открытыми моделями, так и с агентами общего назначения», — пишут исследователи.
W&L в действии
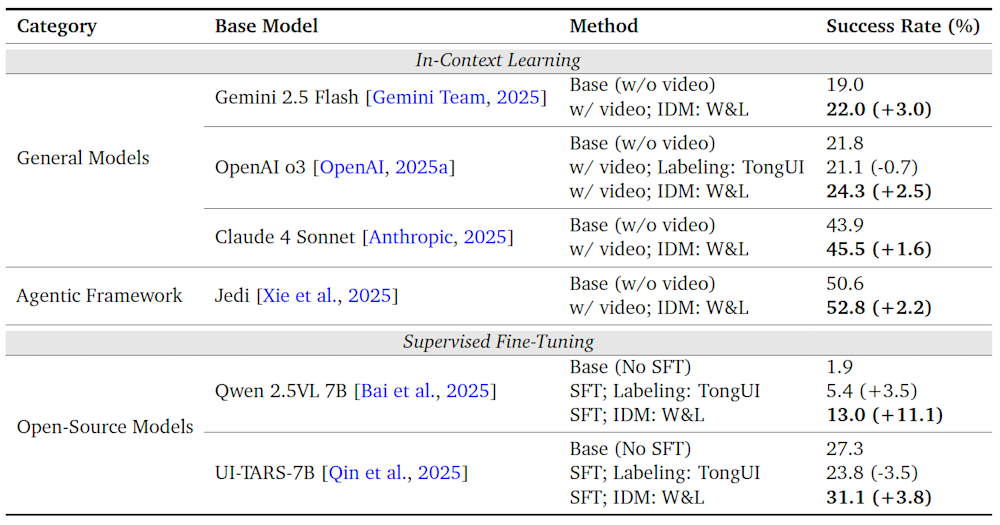
Чтобы проверить полезность W&L, исследователи провели серию экспериментов с моделями с закрытым и открытым исходным кодом на бенчмарке OSWorld, который оценивает агентов в реальных средах настольных ПК и операционных систем при выполнении различных задач, включая работу с продуктивностью, программирование и дизайн.
Для дообучения (fine-tuning) они использовали свой корпус из 53 000 траекторий для обучения двух моделей с открытым исходным кодом: UI-TARS-1.5, мощной открытой видео-языковой модели действия, разработанной специально для работы за компьютером, и Qwen 2.5-VL — мультимодальной LLM с открытыми весами.
Для тестов контекстного обучения они применили примеры W&L к мультимодальным моделям общего назначения, таким как Gemini 2.5 Flash, OpenAI o3 и Claude Sonnet 4.
Модели, обученные или дополненные с помощью W&L, демонстрируют значительное улучшение в задачах работы за компьютером (источник: arXiv)
W&L привел к улучшениям на OSWorld во всех категориях моделей, включая рост до 3 баллов для ICL на моделях общего назначения и до 11 баллов для дообученных моделей с открытым исходным кодом.
Что еще более важно, эти преимущества были достигнуты без какого-либо ручного аннотирования, «демонстрируя, что рабочие процессы человека в масштабах интернета могут служить практической и масштабируемой основой для продвижения CUA к развертыванию в реальном мире», пишут исследователи.
Это может иметь важные последствия для реальных приложений, позволяя предприятиям превращать существующие массивы видео и записей конференций в обучающие данные для CUA. Это также упрощает создание новых обучающих траекторий. Все, что вам нужно будет сделать, — это записать видео выполнения различных задач и передать их на аннотирование модели IDM. По мере того как передовые модели постоянно совершенствуются и становятся дешевле, вы можете рассчитывать на большую отдачу от имеющихся данных по мере развития этой области.