TabFM от Google обходится без обучения для каждого набора данных


Подавляющее большинство бизнес-данных представляют собой таблицы — они хранятся в хранилищах данных, CRM и финансовых журналах, — однако создание надежной модели на их основе до сих пор подразумевает обучение новой модели с нуля для каждого набора данных, с последующим поддержанием циклов настройки гиперпараметров, инженерии признаков и конвейеров дообучения для борьбы с дрейфом данных. Google Research предлагает альтернативный подход: новую базовую модель под названием TabFM, которая рассматривает табличное прогнозирование как задачу обучения в контексте (in-context learning).
Она может генерировать предсказания для новой, ранее не встречавшейся таблицы за один проход вперед. Для корпоративных разработчиков и инженеров по ИИ это сокращает время вывода на рынок с недель проектирования конвейеров до всего одного вызова API.
Проблема традиционного машинного обучения
Чтобы получать надежные прогнозы с помощью деревьев с градиентным бустингом, специалистам по работе с данными приходится создавать и обслуживать сложные конвейеры данных. Им нужно очищать «грязные» входные данные, заполнять пропущенные значения, кодировать категориальные переменные в числовые форматы и вручную создавать перекрестные признаки.
Как только данные готовы, они должны запускать повторяющиеся циклы оптимизации гиперпараметров, перебирая скорости обучения, глубину деревьев, коэффициенты подвыборки и сетки регуляризации для поиска наилучшей конфигурации.
После развертывания эти традиционные модели «порождают постоянный операционный долг за счет мониторинга дрейфа данных и конвейеров дообучения для поддержания точности», — рассказал VentureBeat Вэйхао Конг (Weihao Kong), научный сотрудник Google Research.
Между тем остальная часть индустрии ИИ уже движется дальше. Генеративные модели ИИ для текста и компьютерного зрения плавно перешли к инференсу в условиях нулевого обучения (zero-shot), когда модель может выполнять абсолютно новую задачу просто по текстовой подсказке с контекстом.
Большие языковые модели (LLM) уже преуспели в обучении в контексте, так почему же мы не можем просто передавать таблицы в готовую LLM?
Поскольку LLM обучены на естественном языке, а не на структурированных данных, им трудно напрямую обрабатывать таблицы. Во-первых, их контекстные лимиты быстро исчерпываются на средних таблицах, содержащих всего несколько тысяч строк и сотни столбцов. Во-вторых, LLM страдают от неэффективности токенизации, неловко разбивая числовые значения и разрушая математическую точность. Наконец, они страдают от структурной слепоты. Когда двумерная таблица сериализуется в одномерную текстовую строку, LLM теряют понимание того, какому ряду и столбцу принадлежит то или иное значение по мере роста таблицы.
«Вот почему сегодня гораздо эффективнее использовать LLM для написания кода, который обрабатывает инженерию признаков и вызывает XGBoost, чем просить LLM саму читать таблицу», — отметил Конг.
Что такое TabFM?
Для запуска инференса с помощью TabFM вам не нужно обновлять веса модели. Вместо этого вы берете свои исторические примеры (обучающие строки с известными метками) и целевые строки (новые данные, которые нужно спрогнозировать) и передаете их модели в виде единого объединенного промпта. Модель учится интерпретировать взаимосвязи между столбцами и строками непосредственно из этого контекста во время выполнения.
Например, рассмотрим корпоративного аналитика, пытающегося спрогнозировать отток клиентов. Вместо создания специализированного конвейера данных и обучения модели XGBoost он может просто передать образец исторических данных пользовательских сессий вместе с новой активной сессией в TabFM. За один проход модель выдает мгновенную вероятность оттока.
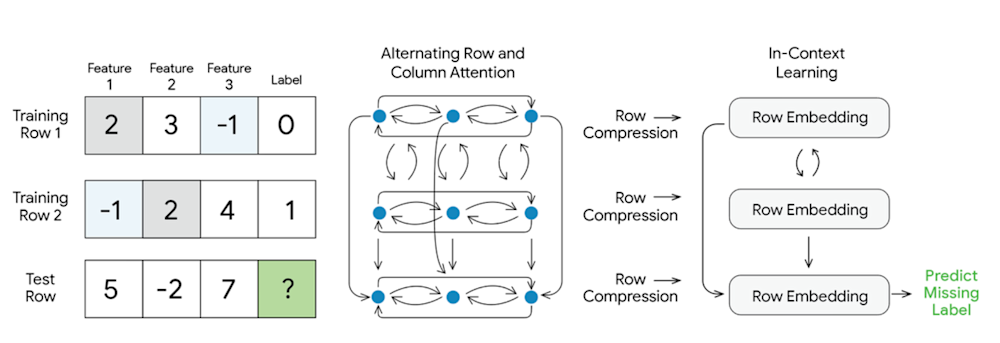
Архитектура TabFM (источник: Google Research)
TabFM преодолевает ограничения LLM, рассматривая данные как сетку, сохраняя их структурную целостность без принудительного преобразования в одномерную текстовую строку.
Для эффективной обработки разнообразных табличных структур и обеспечения масштабируемого прогнозирования в режиме zero-shot, TabFM объединяет сильные стороны более ранних экспериментальных архитектур — TabPFN и TabICL. Модель TabPFN, разработанная Prior Labs, первой доказала, что архитектура трансформера способна выполнять классификацию без предварительного обучения на небольших таблицах, хотя ей было сложно масштабироваться на более крупранные наборы данных.
Позже TabICL, созданная Национальным исследовательским институтом цифровых наук и технологий Франции (Inria), устранила это узкое место за счет внедрения сжатия строк, позволив обучению в контексте эффективно обрабатывать гораздо более крупные таблицы.
TabFM сочетает в себе глубокую контекстуализацию признаков из TabPFN и эффективное сжатие из TabICL в новой гибридной конструкции, построенной на трех ключевых механизмах:
1. Чередующееся внимание по строкам и столбцам: Исходная таблица сначала обрабатывается через многослойный модуль внимания, который чередуется как по столбцам (признакам), так и по строкам (примерам). Благодаря постоянному отслеживанию этих двух измерений модель нативно улавливает сложные взаимодействия признаков. Эта глубокая контекстуализация выполняет сложную работу, которая обычно требует утомительного ручного создания признаков специалистами по данным.
2. Сжатие строк: После этой контекстуализации информация по каждой строке, собранная с помощью перекрестного внимания, сжимается в единое плотное векторное представление. TabICL впервые применил это, используя CLS-токены для сжатия богатой информации строки в один вектор, «в отличие от TabPFN v2, v2.5 и v2.6, которые применяют механизм внимания по всей сетке ячеек во всей сети», — пояснил Конг. Это радикально сокращает объем используемых вычислений.
3. Обучение в контексте (ICL): Казуальный трансформер затем работает с этой последовательностью сжатых вложений. Эта модель-трансформер использует механизм внимания TabICL для работы с этими векторами плотных строк, что значительно снижает вычислительные затраты и позволяет модели эффективно обрабатывать большие наборы данных.
Главным достоинством TabFM является рецепт предварительного обучения. Модель обучалась исключительно на сотнях миллионов синтетических наборов данных. Эти данные генерировались динамически с помощью структурных причинно-следственных моделей (SCM), которые включают в себя самые разные случайные функции. Обучаясь исключительно на синтетических SCM, TabFM усвоила фундаментальные математические априорные представления о том, как взаимодействуют табличные признаки, без необходимости загрузки реальных конфиденциальных CSV-файлов.
TabFM в действии
Чтобы проверить возможности модели, исследователи Google провели бенчмаркинг TabFM на TabArena — комплексном наборе для оценки, охватывающем 51 разнообразный табличный датасет для 38 задач классификации и 13 задач регрессии.
На этих публичных бенчмарках нулевые прогнозы TabFM уже соответствуют или превосходят тщательно настроенные базовые модели с учителем. Тем не менее, Google подчеркивает, что это автоматически не означает, что TabFM повсеместно вытеснит специализированные, гипер-оптимизированные производственные модели для каждой корпоративной рабочей нагрузки.
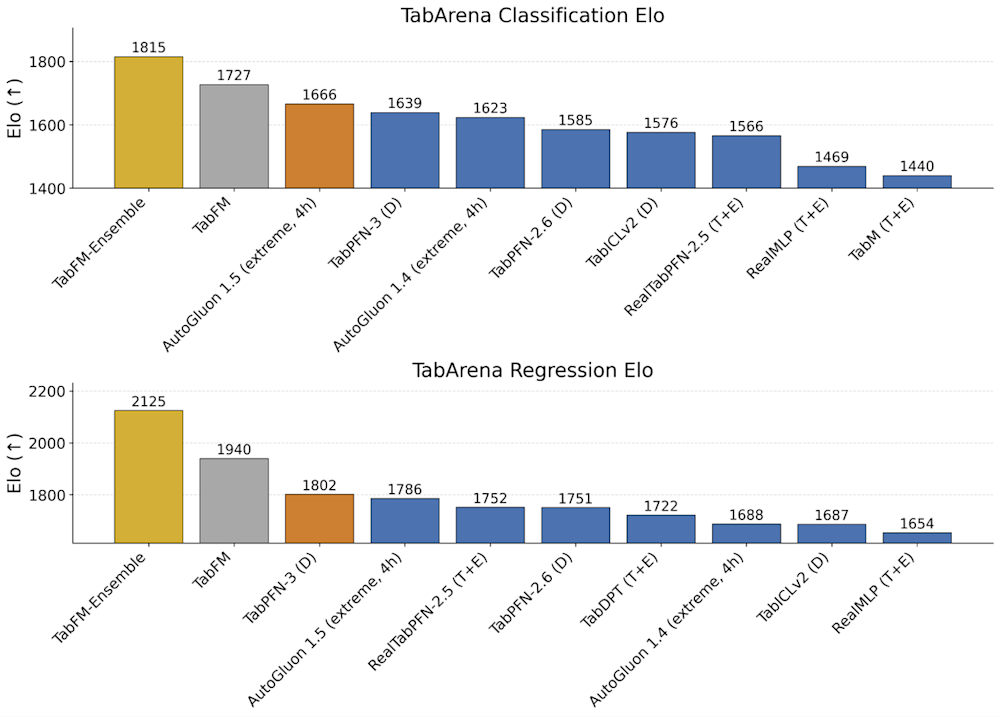
Производительность TabFM на отраслевых бенчмарках (источник: Google Research)
«Вместо замены гипер-оптимизированных производственных моделей, реальная практическая ценность, которую она дает бережливым инженерным командам, — это скорость», — сказал Конг. «Она позволяет дата-аналитикам и бэкенд-инженерам мгновенно разворачивать высококачественные базовые модели без выделенной команды Data Science, управляющей сложным жизненным циклом».
Для опытных практиков, стремящихся выжать максимум точности, исследовательская группа также представила конфигурацию «TabFM-Ensemble». Запуская модель через 32 различных варианта и объединяя результаты, TabFM поднимает производительность на еще более высокий уровень.
С чего начать, компромиссы и облачное будущее
Переход к обучению в контексте для таблиц влечет за собой новый экономический компромисс, который инженерным командам необходимо учитывать.
В традиционных алгоритмах обучение идет медленно и дорого, зато инференс молниеносен и дешев. TabFM меняет эту динамику местами. Время обучения падает до нуля, но инференс становится значительно тяжелее. Поскольку модель должна обрабатывать весь исторический набор данных в качестве контекста при каждом отдельном предсказании, во время работы ей требуется больше вычислительных ресурсов и памяти.
В этой новой парадигме «традиционное обучение машинному обучению становится фазой «предзагрузки» (кэширования KV) в окне контекста», — отметил Конг. Хотя эти затраты на предзагрузку высоки, они оплачиваются только один раз для каждой таблицы, а кэш переиспользуется при последующих запросах. «Подвох заключается в задержке предсказаний, которую не устранит никакой объем кэширования», — добавил Конг. Каждое новое предсказание требует прогона через крупный трансформер. «Любое продакшн-API, требующее времени отклика в единицы миллисекунд, не сможет выдержать накладные расходы TabFM на проход вперед».
Для разработчиков, желающих оценить модель сегодня, барьер входа невелик. Google разработала TabFM как замену традиционным рабочим процессам ML с поддержкой интерфейса, совместимого со scikit-learn (TabFMClassifier и TabFMRegressor). Она нативно работает со смешанными числовыми и категориальными столбцами, взаимодействует напрямую с pandas DataFrame и не требует ручных порядковых кодировщиков или числовых скейлеров. Библиотека поддерживает бэкенды как JAX, так и PyTorch.
Тем не менее, корпоративным командам необходимо помнить о текущих ограничениях и лицензионных требованиях. Архитектура модели имеет жесткое ограничение в 10 классов вывода для задач классификации, и она оптимизирована для таблиц с числом признаков до 500. Что еще важнее, хотя Google выпустила исходную кодовую базу под мягкой лицензией Apache 2.0, предварительно обученные веса моделей опубликованы на Hugging Face под строгой лицензией tabfm-non-commercial-v1.0. Разработчики могут тестировать модель внутри компании, но ее нельзя развертывать в коммерческих продуктах прямо сейчас.
Заглядывая в будущее, Google решает проблему трений при коммерческом развертывании через свою облачную экосистему. TabFM интегрируется напрямую в Google BigQuery, позволяя аналитикам запускать предикты zero-shot нативно через команду «AI.PREDICT». Разместив инференс базовой модели прямо рядом с хранилищем данных, Google вскоре сможет сделать сложный табличный машинный анализ столь же доступным, как и простой запрос к базе данных.
На практике TabFM отлично проявляет себя в быстром прототипировании, средах с высоким дрейфом данных и на малых и средних наборах данных размером до 100 000 строк. И наоборот, командам стоит придерживаться традиционных моделей для жестких API с ультранизкой задержкой или массивных таблиц, превышающих миллион строк, для которых в настоящее время требуется агрессивная выборка строк, снижающая конкурентное преимущество базовой модели.