Google Cloud и Калифорнийский университет в Лос-Анджелесе повышают эффективность рассуждений языковых моделей
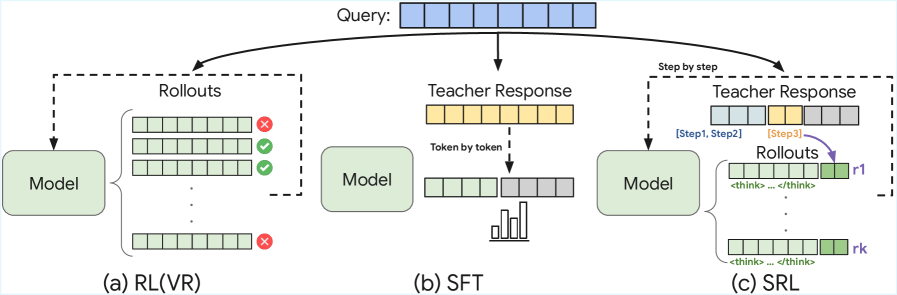


Исследователи из Google Cloud и Университета Калифорнии в Лос-Анджелесе (UCLA) предложили новый фреймворк обучения с подкреплением, который значительно повышает способность языковых моделей справляться со сложнейшими задачами многошагового рассуждения. Обучение с подкреплением на основе учителей (Supervised Reinforcement Learning, SRL) представляет процесс решения проблем как последовательность логических «действий», обеспечивая насыщенные сигналы обучения в ходе тренировки.
Этот подход позволяет моделям меньшего размера справляться со сложными задачами, которые ранее были недоступны при использовании других распространенных методов обучения. Эксперименты показывают, что SRL не только превосходно справляется с бенчмарками математических рассуждений, но и эффективно переносится на задачи агентной программной инженерии.
SRL — это универсальный тренировочный фреймворк, способный поднять более компактные и дешевые модели на новый уровень способностей к рассуждению.
Пределы текущего обучения LLM рассуждениям
Недавние успехи в обучении больших языковых моделей (LLM) рассуждениям во многом обусловлены обучением с подкреплением с верифицируемыми наградами (RLVR) — методом, при котором модель получает вознаграждение в зависимости от правильности своего окончательного ответа. Многократно пытаясь решать задачи и получая обратную связь по итоговому результату, модель постепенно вырабатывает эффективные стратегии решения.
Однако успех этого подхода, основанного на конечном результате, зависит от способности модели найти правильное решение за ограниченное число попыток (или «прогонов»). Поскольку каждый прогон требует больших вычислительных затрат, модели не могут экспериментировать бесконечно. Этот метод заходит в тупик, когда задачи настолько сложны, что модель редко (или вообще никогда) не находит правильный ответ в рамках выделенного лимита.
Это создает серьезное «бутылочное горлышко» в обучении. Во многих задачах на многошаговые рассуждения модель может успешно пройти несколько шагов, но оступиться из-за одной ошибки, что приведет к неверному ответу. В случае с RLVR все эти усилия получают отрицательную награду, и модель ничего не извлекает из своей частично правильной работы. Это подход «все или ничего», который не дает детальной обратной связи и обеспечивает лишь редкие награды.
Альтернативным методом является контролируемая доработка (SFT), при которой модель учится на примерах, где экспертами полностью расписан весь процесс рассуждений. Хотя SFT способна привить навыки рассуждения, она часто приводит к переобучению (модель просто учится копировать траектории из обучающих данных вместо того, чтобы обобщать знания на задачи, выходящие за рамки виденных примеров). Ситуация усугубляется тем, что качественные обучающие данные, созданные человеком, дефицитны и дороги в производстве.
Как отмечается в исследовании, эти ограничения оставляют «критический пробел в обучении небольших моделей с открытым исходным кодом эффективному решению сложных задач».
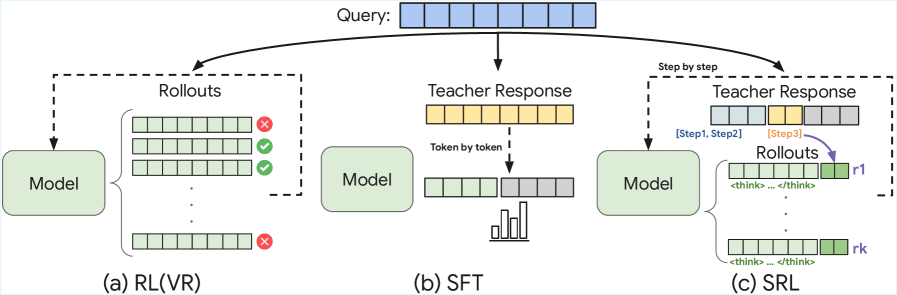
RLVR против SFT против SRL (источник: arXiv)
Как работает обучение с подкреплением на основе учителей
SRL представляет фреймворк, который переосмысляет решение задач как «процесс принятия последовательных решений», находя баланс между чистым RL на основе результатов и чистым обучением по демонстрациям. Вместо того чтобы оптимизировать модель только по финальному ответу или заставлять ее имитировать весь ход мыслей эксперта, SRL учит модель воспроизводить последовательность ключевых действий, составляющих основу экспертных рассуждений. Это позволяет модели совершать действия, подобные экспертным, одновременно вырабатывая собственный внутренний стиль рассуждений.
В рамках фреймворка SRL экспертные демонстрации разбиваются на серию промежуточных конкретных действий, каждое из которых представляет собой значимый шаг. Для математической задачи таким действием может быть алгебраическое преобразование. Для агента в области программной инженерии — команда, выполняемая в репозитории кода. Для генерации тренировочных данных SRL использует мощную модель-учитель, которая создает траектории решений, используемые затем для обучения более компактной модели.
По словам Ай-Хун Сю (I-Hung Hsu), научного сотрудника Google и соавтора статьи, этот срединный подход является ключом к его эффективности в реальных сценариях. «SRL занимает промежуточное положение: он отражает структурную гибкость реального решения задач, где существует множество жизнеспособных стратегий, но при этом на каждом шаге есть четкое понимание того, как выглядят „хорошие рассуждения“, — рассказал Сю в интервью VentureBeat. — Это делает SRL подходящим для таких областей, как автоматизация науки о данных или, возможно, оптимизация цепочек поставок — задач, которые вознаграждают надежные промежуточные рассуждения, а не просто финальные ответы».
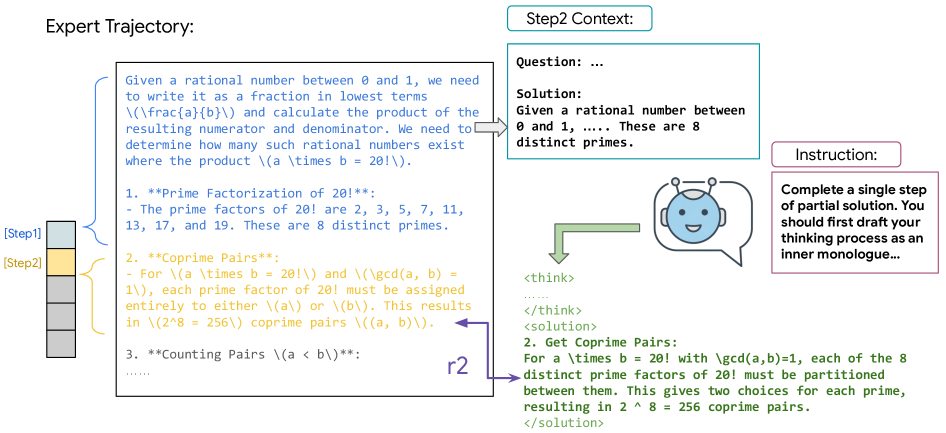
Пример траектории SRL (источник: arXiv)
Во время обучения модель сначала генерирует «внутренний монолог» (свой внутренний процесс рассуждения, заключенный в теги
SRL в действии
Эксперименты исследователей показывают, что SRL существенно превосходит сильные базовые методы как в сложных математических рассуждениях, так и в бенчмарках агентной программной инженерии. Они также заметили, что SRL стимулирует в моделях более гибкие и изощренные паттерны рассуждений, такие как чередование планирования и самопроверки, которые повышают качество решений без простого удлинения вывода.
Для бизнес-лидеров прирост производительности ценен только тогда, когда он не сопровождается неконтролируемым ростом затрат. Сю уточняет, что модели, обученные с помощью SRL, более эффективны в своих рассуждениях. «Прирост достигается за счет лучшего качества и структуры рассуждений, а не многословности, — отметил он. — С точки зрения эффективности SRL-обученные модели примерно сопоставимы с базовой моделью по потреблению токенов… хотя SRL не предназначена для снижения затрат на инференс, она достигает более высоких показателей рассуждения без их увеличения».
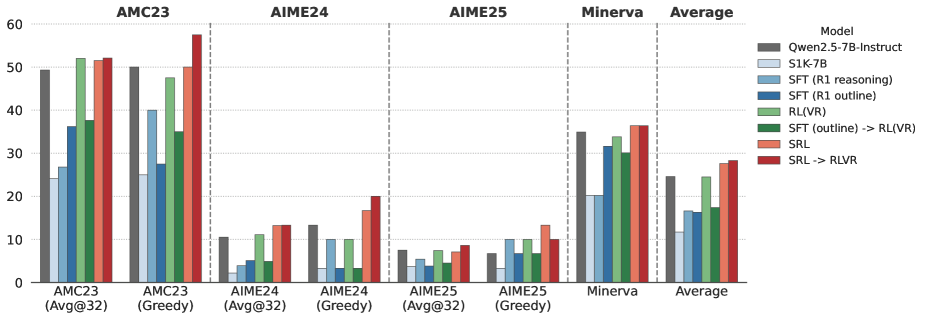
Производительность SRL по сравнению с другими базовыми методами (источник: arXiv)
Для проверки математических навыков команда дообучила модель Qwen2.5-7B-Instruct на датасете из 1 000 сложных математических вопросов. Они сравнили ее производительность с моделями, обученными с помощью SFT и RLVR (с использованием алгоритма GRPO, распространенного в таких моделях, как DeepSeek-R1), на четырех математических бенчмарках соревновательного уровня. Модель, обученная с помощью SRL, показала существенный средний прирост производительности на 3,0% по сравнению с другими методами.
Команда распространила SRL на агентную программную инженерию — область, критически важную для корпоративной автоматизации. Они обучили модель, специализированную на написании кода — Qwen2.5-Coder-7B-Instruct, на 5 000 экспертных траекторий взаимодействия агентов со средой разработки. SRL-обученная модель тестировалась в сравнении с исходной базовой моделью и SWE-Gym-7B — сильным базовым решением, дообученным с помощью SFT. SRL достигла показателя успешного решения задач в 14,8%, что представляет собой 74-процентное относительное улучшение по сравнению с моделью на базе SFT. Это демонстрирует способность SRL обучать более компетентных ИИ-агентов для сложных задач программирования в реальном мире.
Новый стандарт для ИИ в критически важных сферах?
Наиболее впечатляющие результаты исследования были получены при комбинировании методов: сначала использование SRL для привития базовых навыков рассуждения, а затем применение RLVR для их шлифовки. В своих экспериментах, когда исследователи использовали SRL в качестве претренинга, а затем применяли RLVR на этапе постренинга, они зафиксировали средний прирост на 3,7%, продемонстрировав мощную стратегию учебного планирования (curriculum learning).
Это поднимает вопрос о том, может ли данный подход стать новым стандартом для создания специализированного ИИ.
«Мы рассматриваем SRL как надежный фундамент, — заявил Сю. — В определенном смысле SRL обеспечивает учебный план — обучая модели мыслить и действовать шаг за шагом, — прежде чем мы доработаем эти паттерны с помощью обучения с подкреплением на основе результатов. Такой подход, где SRL идет в первую очередь, не только стабилизирует последующий этап RL, но и делает рассуждения более интерпретируемыми и обобщаемыми, что крайне важно для критически важных приложений».
Заглядывая в будущее, Сю признает, что масштабирование этого пайплайна по-прежнему сопряжено с трудностями, в частности с высокой стоимостью и сложностью сквозного RLVR для агентных задач. Тем не менее, он с оптимизмом смотрит на дальнейший путь. «Хотя качественные экспертные траектории остаются важными, — заключил он, — мы полагаем, что следующий большой прорыв произойдет за счет автоматизации их генерации и фильтрации — с привлечением мощных моделей-учителей или даже самосовершенствующихся моделей-учеников для бутстраппинга новых данных».