Метод вложенного обучения от Google переопределяет процесс тренировки ИИ


Исследователи из Google разработали новую парадигму искусственного интеллекта, направленную на преодоление одного из главных ограничений современных больших языковых моделей — их неспособности учиться или обновлять свои знания после завершения обучения. Эта парадигма, получившая название вложенного обучения (Nested Learning), представляет модель и процесс ее обучения не как единый линейный процесс, а как систему вложенных многоуровневых задач оптимизации. Исследователи утверждают, что такой подход позволяет создавать более выразительные алгоритмы обучения, что ведет к улучшению контекстного обучения и памяти.
В качестве доказательства своей концепции исследователи использовали вложенное обучение для создания новой модели под названием Hope. Первые эксперименты показали, что она демонстрирует превосходную производительность в задачах языкового моделирования, непрерывного обучения и рассуждений на длинных контекстах, что потенциально открывает путь к созданию эффективных систем ИИ, способных адаптироваться к условиям реального мира.
Проблема памяти больших языковых моделей
Алгоритмы глубокого обучения помогли избавиться от необходимости кропотливого проектирования и глубоких предметных знаний, которые требовались при традиционном машинном обучении. Предоставив моделям огромные объемы данных, ученые позволили им самостоятельно изучать необходимые репрезентации. Однако этот подход породил собственный набор проблем, которые нельзя было решить простым добавлением новых слоев или созданием более крупных сетей. К ним относятся генерализация на новых данных, непрерывное изучение новых задач и предотвращение попадания в субоптимальные решения в процессе обучения.
Попытки преодолеть эти трудности привели к инновациям, в результате которых появились трансформеры — фундамент современных больших языковых моделей (LLM). Эти модели ознаменовали «смену парадигмы от специализированных моделей к более универсальным системам с различными эмерджентными возможностями в результате масштабирования „правильных“ архитектур», пишут исследователи. Тем не менее, фундаментальное ограничение остается: языковые модели остаются в основном статичными после обучения и не могут обновлять свои базовые знания или приобретать новые навыки на основе новых взаимодействий.
Единственным адаптируемым компонентом LLM является ее способность к контекстному обучению, которая позволяет выполнять задачи на основе информации, предоставленной в непосредственном промте. Это делает современные LLM похожими на человека, который не способен формировать новые долгосрочные воспоминания. Их знания ограничиваются тем, что они усвоили во время предварительного обучения (далекое прошлое), и тем, что находится в их текущем окне контекста (непосредственное настоящее). Как только разговор выходит за пределы окна контекста, эта информация теряется навсегда.
Проблема заключается в том, что у сегодняшних LLM на базе трансформеров нет механизма «онлайн-консолидации». Информация в окне контекста никогда не обновляет долгосрочные параметры модели — веса, хранящиеся в ее полносвязных слоях. В результате модель не может навсегда усвоить новые знания или навыки из взаимодействий: все, чему она учится, исчезает, как только окно контекста обновляется.
Вложенный подход к обучению
Вложенное обучение (Nested Learning, NL) разработано для того, чтобы позволить вычислительным моделям учиться на данных, используя разные уровни абстракции и временные масштабы, подобно человеческому мозгу. Оно рассматривает отдельную модель машинного обучения не как единый непрерывный процесс, а как систему взаимосвязанных задач обучения, которые оптимизируются одновременно с разной скоростью. Это отход от классического подхода, в котором архитектура модели и алгоритм ее оптимизации рассматриваются как два раздельных компонента.
В рамках этой парадигмы процесс обучения рассматривается как развитие «ассоциативной памяти» — способности соединять и вспоминать связанные между собой кусочки информации. Модель учится соотносить точку данных с ее локальной ошибкой, которая измеряет, насколько «неожиданной» была эта точка данных. Даже ключевые архитектурные компоненты, такие как механизм внимания в трансформерах, можно рассматривать как простые модули ассоциативной памяти, которые изучают соответствия между токенами. Задавая частоту обновления для каждого компонента, эти вложенные задачи оптимизации можно упорядочить по разным «уровням», что и составляет ядро парадигмы NL.
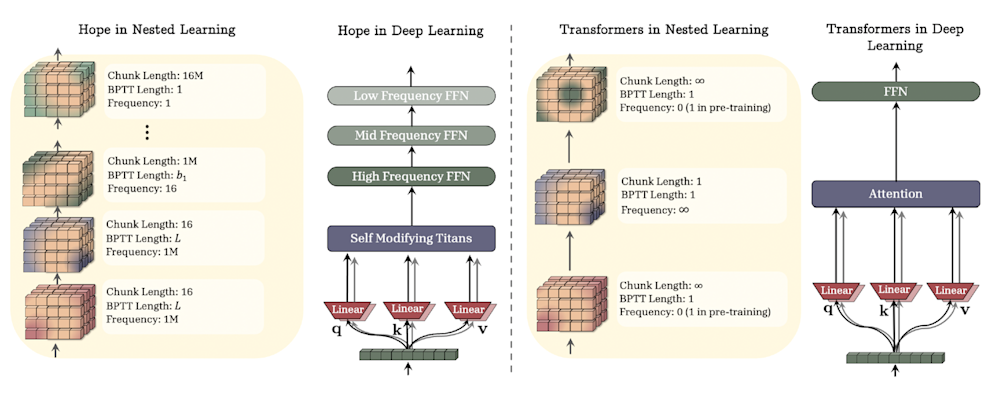
Hope (слева) использует многоуровневое вложенное обучение, в то время как трансформеры (справа) взаимодействуют только между механизмом внимания и полносвязными сетями (источник: Google)
Надежда на непрерывное обучение
Исследователи применили эти принципы на практике в модели Hope — архитектуре, созданной для реализации концепции вложенного обучения. Hope представляет собой модифицированную версию Titans — другой архитектуры, представленной Google в январе для преодоления ограничений памяти моделей-трансформеров. Хотя Titans обладала мощной системой памяти, ее параметры обновлялись всего с двумя разными скоростями: в модуле долгосрочной памяти и в механизме кратковременной памяти.
Hope — это самомодифицирующаяся архитектура, дополненная «системой континуальной памяти» (Continuum Memory System, CMS), которая обеспечивает неограниченные уровни контекстного обучения и масштабируется до больших окон контекста. CMS работает как серия банков памяти, каждый из которых обновляется с разной частотой. Быстро обновляющиеся банки обрабатывают непосредственную информацию, в то время как более медленные консолидируют более абстрактные знания в течение длительных периодов времени. Это позволяет модели оптимизировать собственную память в самореферентном цикле, создавая архитектуру с теоретически бесконечными уровнями обучения.
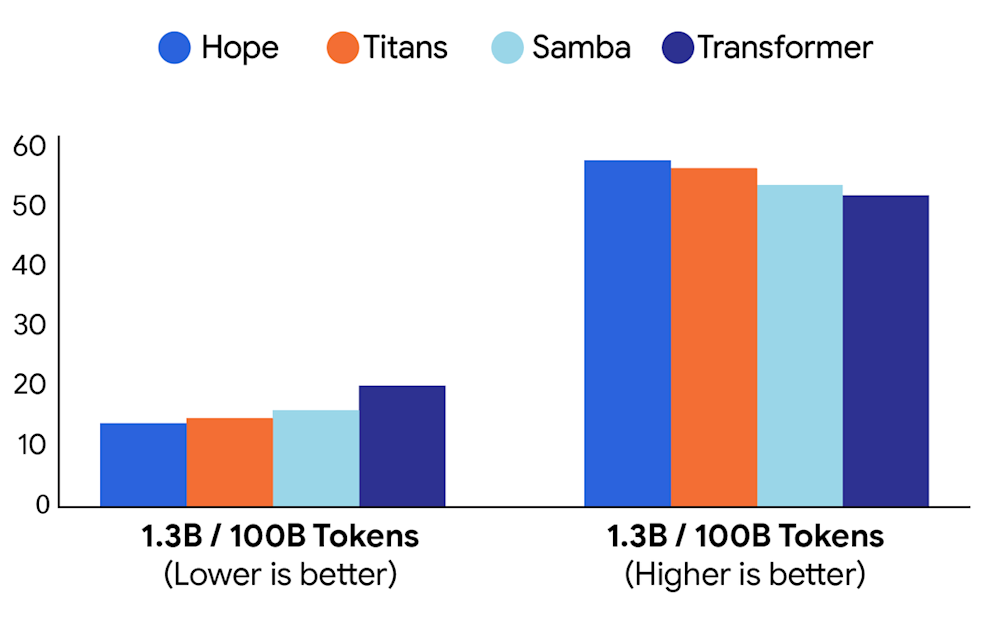
Hope демонстрирует более низкую перплексию и более высокую точность по сравнению с другими архитектурами (источник: Блог Google)
На разнообразном наборе задач языкового моделирования и проверки здравого смысла Hope продемонстрировала более низкую перплексию (показатель того, насколько хорошо модель предсказывает следующее слово в последовательности и поддерживает связность генерируемого текста) и более высокую точность по сравнению как со стандартными трансформерами, так и с другими современными рекуррентными моделями. Hope также показала лучшие результаты в задачах поиска длинного контекста по типу «иголка в стоге сена» (Needle-In-Haystack), где модель должна найти и использовать конкретную информацию, спрятанную в большом объеме текста. Это говорит о том, что ее CMS предлагает более эффективный способ обработки длинных последовательностей информации.
Это лишь одно из нескольких усилий по созданию систем ИИ, обрабатывающих информацию на разных уровнях. Иерархическая модель рассуждений (Hierarchical Reasoning Model, HRM) от Sapient Intelligence использует иерархическую архитектуру для повышения эффективности модели в задачах рассуждения. Крошечная модель рассуждений (Tiny Reasoning Model, TRM) от Samsung совершенствует HRM за счет архитектурных изменений, улучшая ее производительность и делая более эффективной.
Несмотря на перспективность, вложенное обучение сталкивается с теми же проблемами, что и другие подобные парадигмы на пути к раскрытию своего полного потенциала. Текущие аппаратные и программные стеки ИИ сильно оптимизированы под классические архитектуры глубокого обучения и особенно под модели-трансформеры. Широкое внедрение вложенного обучения может потребовать фундаментальных изменений. Тем не менее, если этот подход получит распространение, он может привести к появлению гораздо более эффективных LLM, способных к непрерывному обучению — возможности, критически важной для реальных корпоративных приложений, где среды, данные и потребности пользователей постоянно меняются.