


Поиск и извлечение данных (Retrieval) как инфраструктура ИИ на предприятиях


Предприятия быстро внедряют RAG для привязки LLM к проприетарным данным. Однако на практике многие организации обнаруживают, что поиск больше не является второстепенной функцией, добавленной к инференсу моделей — он стал фундаментальной системной зависимостью.
Как только системы ИИ развертываются для поддержки принятия решений, автоматизации рабочих процессов или работы в полуавтономном режиме, сбои в поиске напрямую трансформируются в бизнес-риски. Устаревший контекст, нерегламентированные пути доступа и плохо оцененные поисковые конвейеры не просто ухудшают качество ответов — они подрывают доверие, соответствие требованиям и эксплуатационную надежность.
В этой статье поиск переосмысляется как инфраструктура, а не как логика приложения. В ней представлена системная модель проектирования поисковых платформ, в которых актуальность, управление и оценка рассматриваются как архитектурные приоритеты высшего порядка. Цель состоит в том, чтобы помочь корпоративным архитекторам, лидерам ИИ-платформ и командам по работе с данными подходить к поисковым системам с той же строгостью, которая исторически применялась к вычислениям, сетям и хранению данных.
Предоставлено автором
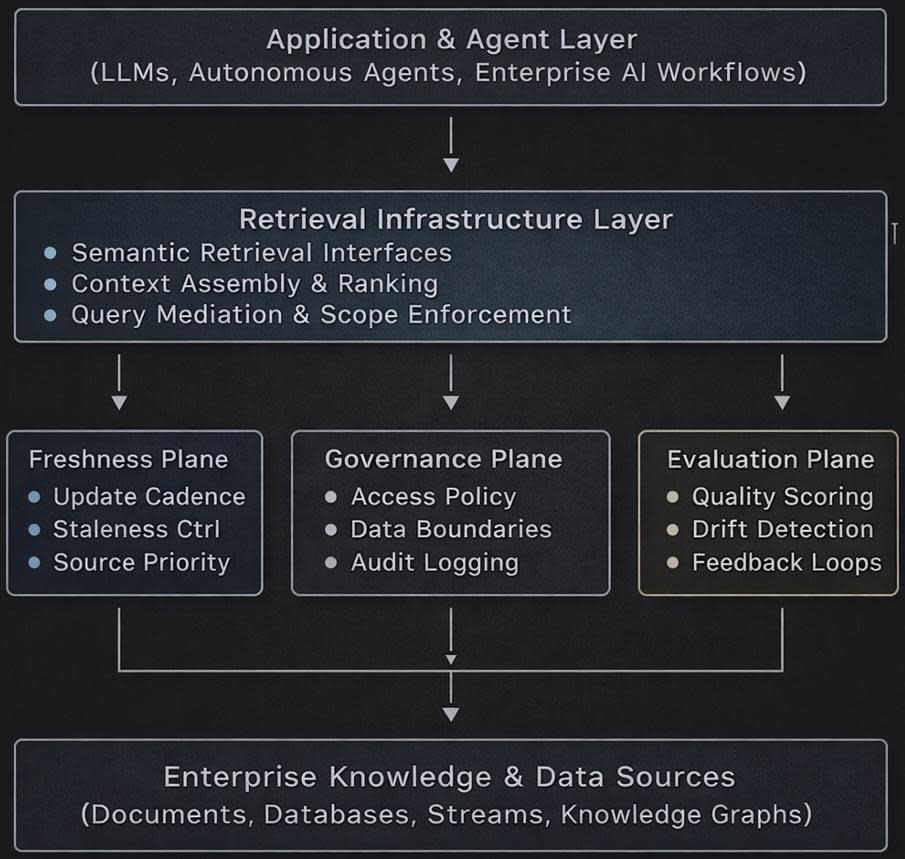
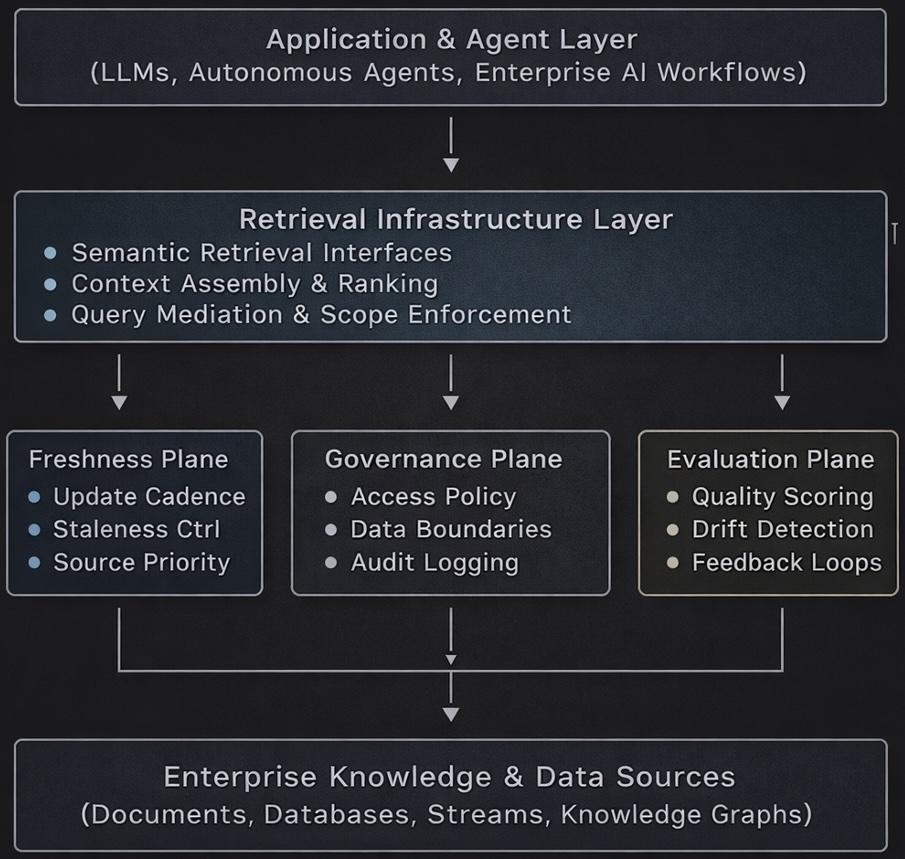
Поиск как инфраструктура — Эталонная архитектура, иллюстрирующая, как актуальность, управление и оценка функционируют как системные уровни первого порядка, а не как встроенная логика приложения. Концептуальная диаграмма создана автором.
Почему RAG дает сбой в масштабах предприятия
Ранние <реализации RAG href=»https://venturebeat.com/orchestration/conversational-ai-doesnt-understand-users-intent-first-architecture-does»>были разработаны для узких вариантов использования: поиска по документам, внутренних вопросов и ответов и вторых пилотов (copilots), работающих в строго определенных доменах. Эти проекты предполагали относительно статические корпуса данных, предсказуемые паттерны доступа и участие человека в качестве контроллера. Эти предположения больше не работают.
Современные корпоративные системы ИИ все больше полагаются на:
-
Непрерывно изменяющиеся источники данных
-
Многоэтапные рассуждения в различных доменах
-
Управляемые агентами рабочие процессы, которые извлекают контекст автономно
-
Нормативные требования и требования аудита, связанные с использованием данных
В таких средах сбои поиска накапливаются очень быстро. Единственный устаревший индекс или политика доступа с неверной областью действия может повлечь за собой лавинообразную реакцию в нескольких последующих решениях. Рассмотрение поиска как легкого улучшения логики инференса затмевает его растущую роль как поверхности системного риска.
Актуальность поиска — это проблема систем, а не проблема настройки
Сбои в актуальности редко происходят из-за моделей встраивания (эмбеддингов). Их истоки кроются в окружающей системе.
Большинство корпоративных поисковых стеков с трудом отвечают на базовые операционные вопросы:
-
Как быстро изменения в источнике распространяются на индексы?
-
Какие потребители все еще делают запросы к устаревшим представлениям?
-
Какие гарантии существуют при изменении данных в середине сеанса?
В зрелых платформах актуальность обеспечивается с помощью явных архитектурных механизмов, а не периодических пересборок. К ним относятся переиндексация на основе событий, версионируемые эмбеддинги и учет устаревания данных во время поиска.
В корпоративных развертываниях повторяется закономерность: сбои в актуальности редко возникают из-за качества эмбеддингов; они проявляются, когда исходные системы постоянно изменяются, в то время как конвейеры индексации и эмбеддингов обновляются асинхронно, из-за чего потребители поиска непреднамеренно работают с устаревшим контекстом. Поскольку система по-прежнему выдает беглые, правдоподобные ответы, эти пробелы часто остаются незамеченными до тех пор, пока автономные рабочие процессы не начинают постоянно зависеть от поиска, и проблемы с надежностью не проявляются в масштабном режиме.
Управление должно распространяться на уровень поиска
Большинство моделей корпоративного управления были разработаны независимо друг от друга для доступа к данным и использования моделей. Поисковые системы занимают промежуточное положение между ними.
Нерегламентированный поиск создает ряд рисков:
-
Модели получают доступ к данным за пределами предназначенной для них области видимости
-
Конфиденциальные поля утекают через эмбеддинги
-
Агенты извлекают информацию, на работу с которой у них нет прав
-
Невозможность восстановить, какие именно данные повлияли на решение
В архитектурах, ориентированных на поиск, управление должно осуществляться на семантических границах, а не только на уровне хранилища или API. Это требует обеспечения соблюдения политик, привязанных к запросам, эмбеддингам и последующим потребителям, а не только к наборам данных.
Эффективное управление поиском обычно включает в себя:
-
Индексы с доменной областью действия и четким правом владения
-
Поисковые API с поддержкой политик
-
Журналы аудита, связывающие запросы с извлеченными артефактами
-
Элементы управления междоменным поиском со стороны автономных агентов
Без этих средств контроля поисковые системы незаметно обходят механизмы защиты, которые, как предполагают организации, у них внедрены.
Оценка не должна ограничиваться качеством ответов
Традиционная оценка RAG фокусируется на том, выглядят ли ответы правильными. Для корпоративных систем этого недостаточно.
Сбои поиска часто проявляются еще до получения окончательного ответа:
-
Извлекаются нерелевантные, но правдоподобные документы
-
Отсутствует критически важный контекст
-
Чрезмерное представление устаревших источников
-
Молчаливое исключение авторитетных данных
Поскольку системы ИИ становятся все более автономными, команды должны оценивать поиск как независимую подсистему. Сюда входит измерение полноты выдачи (recall) в условиях ограничений политик, мониторинг дрейфа актуальности и обнаружение предвзятости, вносимой поисковыми путями.
В производственных средах оценка имеет свойство нарушаться, как только поиск становится автономным, а не инициируемым человеком. Команды продолжают оценивать качество ответов по выборочным промптам, но не имеют видимости того, что было извлечено, что было упущено или повлиял ли устаревший либо несанкционированный контекст на принятие решений. Поскольку поисковые пути динамически развиваются в продакшене, скрытый дрейф накапливается на ранних этапах, и к моменту обнаружения проблем сбои часто ошибочно приписывают поведению модели, а не самой поисковой системе.
Оценка, которая игнорирует поведение поиска, оставляет организации в неведении относительно истинных причин сбоев системы.
Плоскости управления, регулирующие поведение поиска
Предоставлено автором
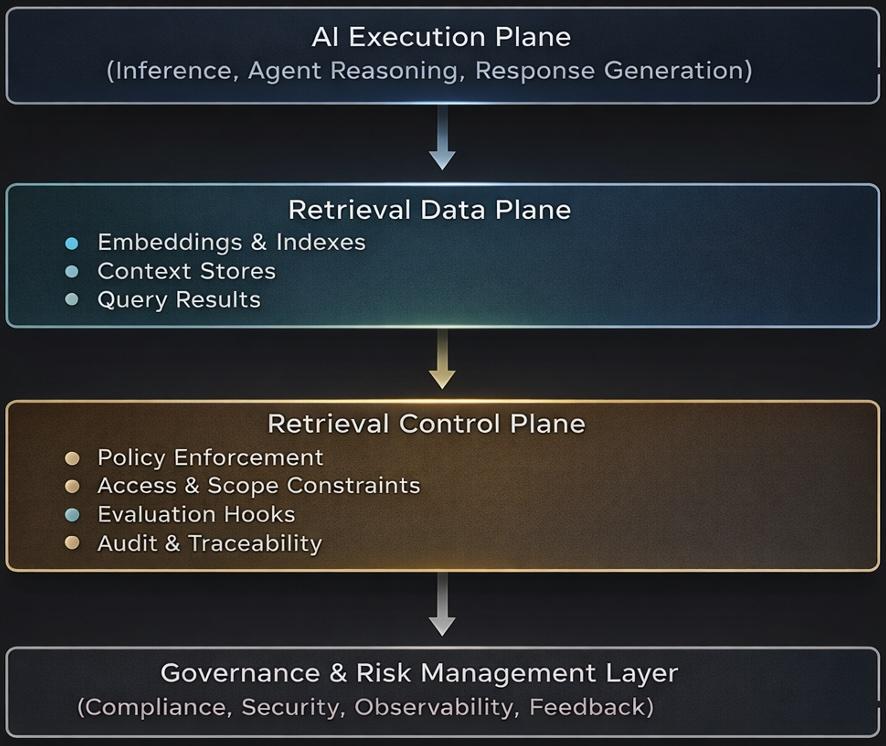
Модель плоскости управления для корпоративных поисковых систем, отделяющая выполнение от управления для обеспечения соблюдения политик, возможности аудита и непрерывной оценки. Концептуальная диаграмма создана автором.
Эталонная архитектура: Поиск как инфраструктура
Поисковая система, предназначенная для корпоративного ИИ, обычно состоит из пяти взаимозависимых слоев:
<
-
Слой приема источников: Обрабатывает структурированные, неструктурированные и потоковые данные с отслеживанием происхождения.
-
Слой встраивания и индексации: Поддерживает версионирование, изоляцию доменов и контролируемое распространение обновлений.
-
Слой политик и управления: Обеспечивает контроль доступа, семантические границы и возможность аудита во время поиска.
-
Слой оценки и мониторинга: Измеряет актуальность, полноту и соблюдение политик независимо от вывода модели.
-
Слой потребления: Обслуживает людей, приложения и автономные агенты с учетом контекстуальных ограничений.
Эта архитектура рассматривает поиск как общую инфраструктуру, а не как логику для конкретного приложения, обеспечивая согласованное поведение в различных сценариях использования.
Почему поиск определяет надежность ИИ
По мере того как предприятия переходят к агентским системам и долгосрочным рабочим процессам ИИ, поиск становится основой, от которой зависят рассуждения. Модели могут быть ровно настолько надежными, насколько надежен предоставленный им контекст.
Организации, которые продолжают рассматривать поиск как второстепенную задачу, столкнутся со следующими трудностями:
-
Необъяснимое поведение модели
-
Пробелы в соблюдении нормативов (комплаенс)
-
Несогласованная производительность системы
-
Эрозия доверия со стороны заинтересованных сторон
Те же, кто возводит поиск в ранг инфраструктурной дисциплины — управляемой, оцениваемой и спроектированной с расчетом на изменения, — получают фундамент, который масштабируется как вместе с автономией, так и с рисками.
Заключение
Поиск больше не является вспомогательной функцией корпоративных систем ИИ. Это инфраструктура.
Актуальность, управление и оценка — это не опциональные оптимизации; это предварительные условия для развертывания систем ИИ, которые надежно функционируют в реальных условиях. По мере того как организации выходят за рамки экспериментальных развертываний RAG в сторону автономных систем и систем поддержки принятия решений, архитектурный подход к поиску будет все больше определять успех или неудачу.
Предприятия, которые осознают этот сдвиг на ранней стадии, окажутся в лучшем положении для ответственного масштабирования ИИ, выдерживания нормативного контроля и поддержания доверия по мере того, как системы становятся все более способными — и все более значимыми.
ВАРУН РАДЖ (Varun Raj) — руководитель отдела облачной и ИИ-инженерии, специализирующийся на корпоративной облачной модернизации, архитектурах с поддержкой ИИ и крупномасштабных распределенных системах.
Добро пожаловать в сообщество VentureBeat!
Наша программа гостевых публикаций — это площадка, где технические эксперты делятся идеями и проводят непредвзятый, независимый глубокий анализ ИИ, инфраструктуры данных, кибербезопасности и других передовых технологий, формирующих будущее бизнеса.
Читайте далее из нашей программы гостевых публикаций — и ознакомьтесь с нашими рекомендациями если вы заинтересованы в публикации собственной статьи!




