


DeepSeek снижает цены на V4-Pro на 75%
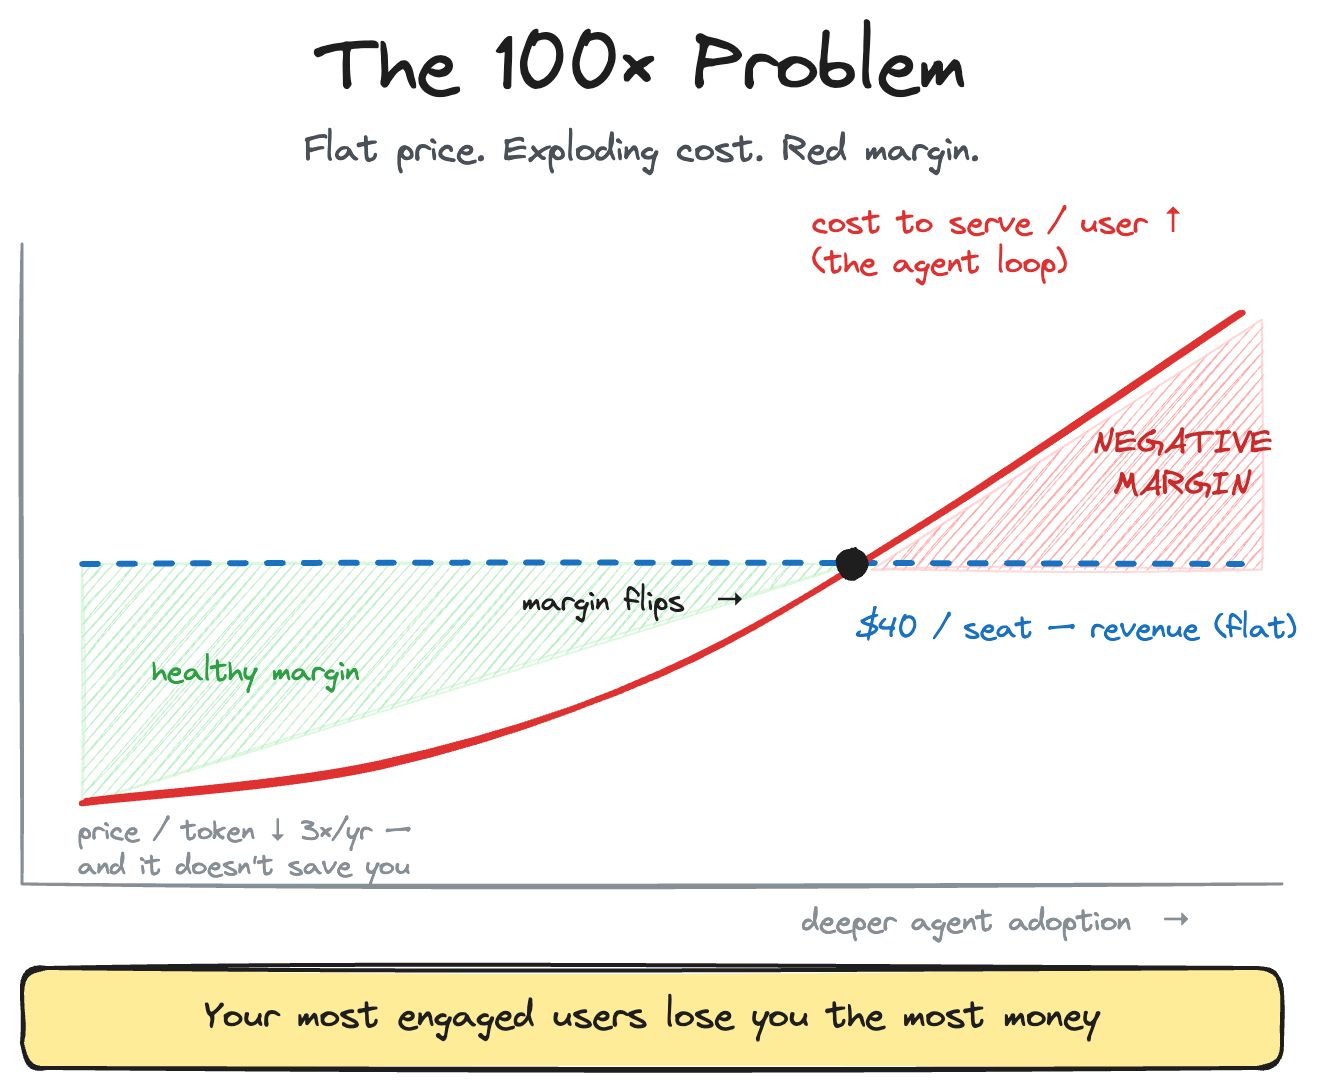


Предоставлено авторами
Недавнее решение DeepSeek радикально снизить цены на свою модель V4-Pro на 75% должно было стать несомненно хорошей новостью для корпоративных ИИ-вендоров и разработчиков. Вместо этого многие обнаруживают, что более дешевые модели не автоматически означают рост маржинальности.
Причина проста: в то время как затраты на инференс падают, агентские системы прожорливо потребляют токенов больше и быстрее, чем снижаются цены. Последние два десятилетия экономика программного обеспечения подчинялась одному и тому же правилу: инфраструктура с каждым годом дешевела, а приложения становились функциональнее. Первоначально предполагалось, что ИИ будет следовать тому же паттерну. По мере совершенствования передовых моделей и падения цен на токены многие полагали, что инференс станет незначительной операционной расходной статьей. Это предположение начало стремительно рушиться.
Чат-бот обычно превращает один вопрос пользователя в один вызов модели. Агент превращает его в цепочку из планирования, извлечения данных, использования инструментов, верификации, суммаризации и последующих решений. Пользователь видит один ответ. Вендор платит за весь цикл. В этом и заключается проблема 100-кратного роста: обслуживание того же видимого пользователем запроса в рамках агентского рабочего процесса может обойтись значительно дороже, чем ответ чат-бота или системы дополненной генерации (RAG). В более долгих рабочих процессах этот множитель еще выше. Падение цен на модели помогает, но оно не исправляет архитектуру продукта, которая превращает один промпт в десятки оплачиваемых операций.
Масштаб того, что поставлено на карту в настоящее время, отчетливо виден по тому, как сами провайдеры моделей выстраивают ценообразование во взаимоотношениях с разработчиками. Предложенная OpenAI программа по выделению каждому стартапу из инкубатора Y Combinator 2 миллионов долларов в виде кредитов на API (сумма, которой в любой предыдущий технологический цикл хватило бы на весь раунд посевного финансирования, в то время как аналогичные когорты обходились несколькими тысячами долларов кредитов AWS) — это не столько бонус для привлечения талантов, сколько признание того, во что сегодня обходится обеспечение работы ИИ-компании в течение ее первого года на рынке. Для устоявшихся корпораций, внедряющих агентов в существующие линейки продуктов, абсолютные цифры еще выше.
Что такое амплификация токенов
В одношаговом чат-бот-сценарии одно сообщение пользователя порождает примерно один вызов модели. Соотношение входных данных к оплачиваемым составляет примерно 1:5.
В многошаговом агенте, развернутом в сфере поддержки клиентов, торговых операций, финансов, юридического анализа и разработки, это соотношение регулярно достигает 1:700 или выше. Каждая итерация цикла переносит кумулятивный разговор, результаты работы инструментов и трассировки рассуждений. Каждый шаг добавляет новые данные; ничто не отбрасывается.
«Простой» агентский запрос вроде «Что спрашивал наш главный клиент на прошлой неделе?» обычно задействует семь платных операций перед возвратом ответа:
-
Промпт пользователя (~50 токенов)
-
Системный промпт и описания инструментов (~3000 токенов, повторяются при каждом вызове)
-
Извлечение данных (~5000 токенов контекста)
-
Вызов модели № 1 — выбор инструмента (8000 входных / 200 выходных)
-
Выполнение инструмента (~4000 возвращенных токенов)
-
Вызов модели № 2 — суммаризация (12 000 входных / 400 выходных)
-
Вызов модели № 3 — решение о дальнейших действиях (12 400 входных / 100 выходных)
Одно предложение на входе, примерно 35 000 выставленных к оплате входных токенов. От 0,10 до 0,40 доллара за запрос на передовой модели. Умножьте это на миллион запросов в месяц — обязательный объем для любой корпоративной B2B-функции — и в графе расходов появятся шесть знаков.
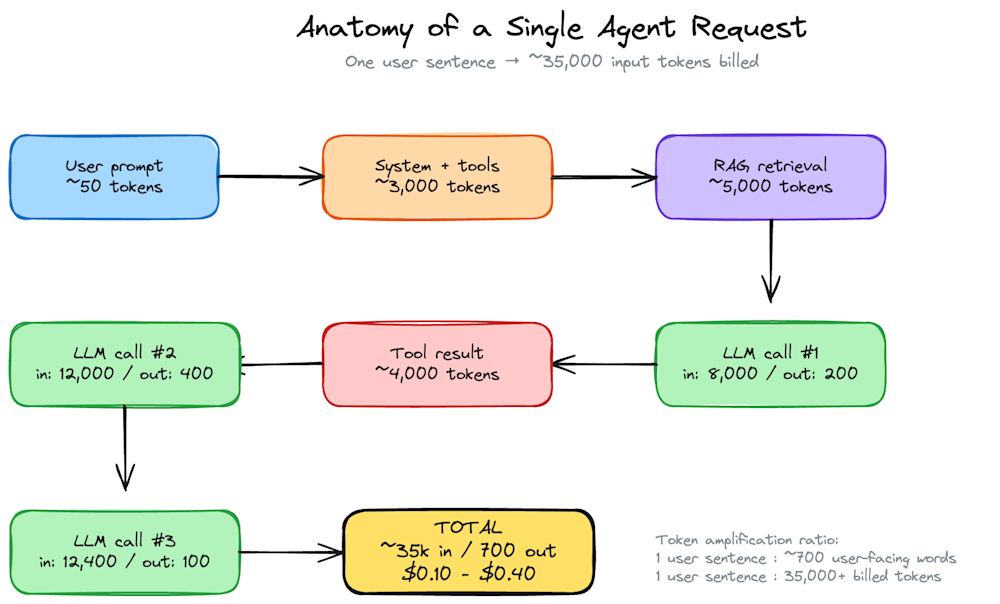
Изображение предоставлено автором
Почему это разрушает существующую бизнес-модель ИИ
Доминирующей историей ценообразования для корпоративного ИИ была SaaS на основе подписки за рабочих мест (seat-based): плата за пользователя в месяц, предоставление агентских возможностей, получение маржи. Эта модель предполагает относительно ограниченную стоимость затрат на одного пользователя.
Амплификация токенов разрушает это предположение. Активный пользователь, выполняющий 50 агентских вызовов в день по тарифному плану за 40 долларов в месяц, может обойтись по инференсу дороже, чем стоимость самого тарифа. Амплификация токенов разрушает традиционную модель ценообразования SaaS. Когда ежедневная активность агента активного пользователя обходится дороже в части инференса, чем его ежемесячная плата за подписку, валовая маржа вендора становится отрицательной — парадокс, который усугубляется по мере того, как клиенты углубляют использование агентов (именно ту кривую использования, которую вендоры продают своим советам директоров). Несколько вендоров теперь конфиденциально сообщают об отрицательной валовой марже на тяжелых пользователях, что отражает недавние отчеты о расходах на облака от когорты Bessemer «Supernova», где корреляция между внедрением ИИ-агентов и сокращением валовой маржи перешла из разряда теоретических рисков в главную проблему отчета о прибылях и убытках.
Видимые симптомы начали просачиваться в публичные СМИ. Издание Bloomberg на этой неделе задокументировало растущий разрыв между маркетинговыми демоверсиями Salesforce Agentforce и возможностями, которые реально поставляются клиентам. Это тот самый разрыв, который предсказуемо возникает, когда обещанная функциональность технически возможна, но неэкономична для обслуживания по цене, подразумеваемой тарифным планом. Salesforce — наиболее часто упоминаемый пример, но далеко не единственный.
«Для моей команды стоимость вычислений далеко превосходит затраты на сотрудников». — Брайан Катанзаро (Bryan Catanzaro), вице-президент по прикладному глубокому обучению, Nvidia
Стратегический вывод заключается вовсе не в том, что «ИИ — это дорого». Он заключается в том, что доминирующая бизнес-модель, заложенная в планы большинства ИИ-нативных компаний, не выдерживает столкновения с агентскими рабочими нагрузками.
Простой пример
Рассмотрим разработчика корпоративного ПО, взимающего 40 долларов за пользователя в месяц за помощника техподдержки на базе ИИ. Традиционный чат-бот может стоить всего несколько центов на пользователя в день в части инференса, оставляя здоровую валовую маржу.
Теперь заменим этого чат-бота полноценным агентским рабочим процессом, способным расследовать тикеты, опрашивать внутренние системы, составлять проекты ответов, проверять результаты и эскалировать исключения. Если активный пользователь выполняет от 50 до 100 агентских запросов в день, потребление инференса может возрасти на порядок. То, что раньше было незначительными инфраструктурными расходами, превращается в существенные операционные затраты.
Это создает необычную динамику: клиенты, получающие наибольшую пользу от продукта, часто оказываются теми же клиентами, которые генерируют самые высокие затраты на инференс. В крайних случаях вендоры могут столкнуться с ситуацией, когда их самые вовлеченные пользователи приносят наименьшую прибыль. В результате в корпоративном сегменте ПО растет осознание того, что внедрение агентов и расширение маржи больше не связаны автоматически.
Оркестрация агентов — новый ров (moat)
Технические решения известны и сходятся в единую концепцию. Они не новы, но критически важны для выживания:
-
Маршрутизация с учетом затрат: Эта техника предполагает использование небольшой классифицирующей модели, которая решает, какой уровень (эквиваленты Haiku, Sonnet, Opus) должен обрабатывать каждый запрос. Хорошо настроенные маршрутизаторы сокращают счета за инференс примерно на 60% без какого-либо ухудшения качества
-
Кэширование промптов: Anthropic, OpenAI и Google теперь предлагают скидки от 75 до 90% на кэшируемые префиксы.
-
Дисциплина контекста: Вы можете усекать выводы инструментов, удалять лишние трассировки рассуждений и ограничивать глубину вызовов инструментов, чтобы предотвратить уход вашего агента «в кроличью нору» (дебри)
-
Спекулятивное декодирование: для развертываний на собственном оборудовании эта техника гарантирует увеличение эффективной пропускной способности в 2–3 раза на тех же графических процессорах.
«Организации, использующие управление на основе оркестрации, сообщают о более сильном росте производительности: комплексный уровень оркестрации связан с шестикратным увеличением влияния на производительность по сравнению с подходами, ориентированными исключительно на соответствие требованиям» — IBM
Компании, которые хорошо строят этот уровень, начинают выглядеть меньше как операторы микросервисов и больше как финансовые торговые системы: каждое решение маршрутизации имеет свою цену, каждый путь — собственный отчет о прибылях и убытках, а каждый арендатор работает в рамках лимитированного бюджета.
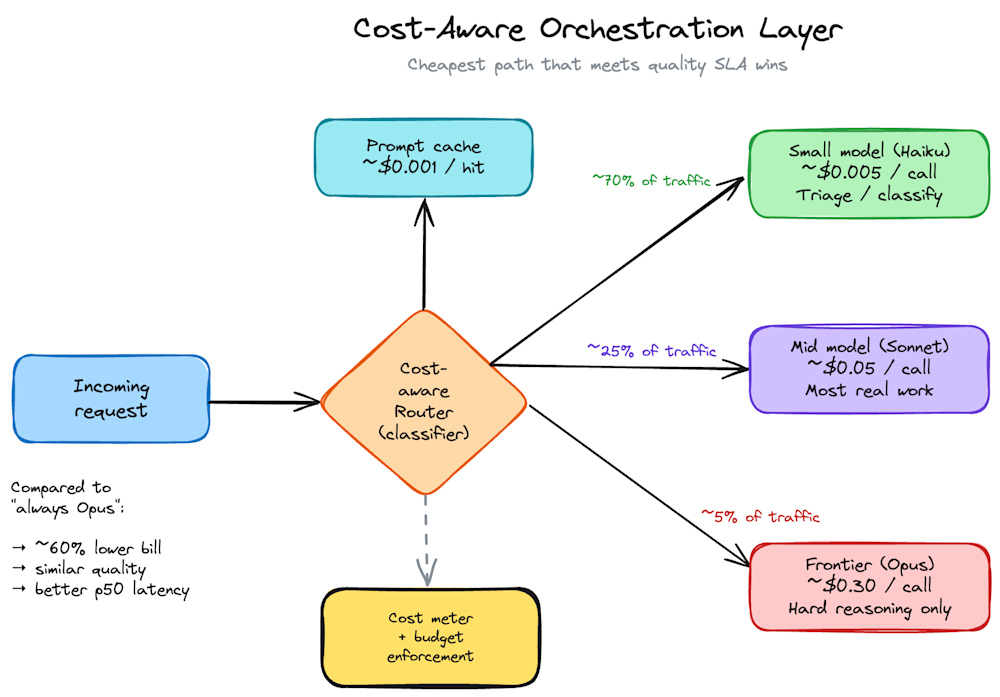
Предоставлено автором
Что на самом деле должны делать корпоративные лидеры
Четыре шага отделяют компании, у которых через 24 месяца все еще будет маржа, от тех, у кого ее не останется:
-
Сделайте затраты на инференс первоклассной метрикой. Отслеживайте их в разрезе функций, арендаторов (тенантов) и классов запросов точно так же, как облачные расходы начали отслеживать с середины 2010-х годов.
-
Формируйте бюджет как медиабайер. Установите потолки стоимости за тысячу запросов для каждой функции. Ограничивайте их. Настройте оповещения о превышении. Инженерный отдел не будет контролировать это самостоятельно.
-
Относитесь к маршрутизатору как к базовой инфраструктуре, а не к оптимизации. Это новый балансировщик нагрузки.
-
Проводите аудит промптов ежеквартально. Системный промпт на 4000 токенов, который органично разрастался в течение шести месяцев, — это шестизначный счет в замедленной съемке. Большинство команд никогда не читали свои собственные производственные промпты от корки до корки.
-
Заблаговременно согласовывайте объемы закупок. Провайдеры передовых моделей теперь предлагают предоплаченные контракты в стиле зарезервированных инстансов со значительными скидками. Прейскурантная цена — это худшая цена, которую когда-либо заплатит любое предприятие.
Следующие 24 месяца
Структурный сдвиг, лежащий в основе агентного ИИ, заключается вовсе не в его дороговизне. Как подчеркивает сегодняшнее снижение цен от DeepSeek, удельные затраты на передовой инференс падают примерно в 3 раза в год, и эта кривая не замедляется.
Изменение заключается в том, что амплификация опережает падение цен. Снижение затрат на токен на 75% не помогает компании, чьи агенты обрабатывают на 700 раз больше токенов на один запрос пользователя, чем предполагала ее модель ценообразования. Впервые с начала облачной эры архитектурные решения вновь стали финансовыми решениями в реальном времени. Редизайн промпта — это событие, влияющее на маржу. Плохо ограниченный цикл агента — это авария, к которой привязана кредитная карта.
Компании, которые переживут следующие 24 месяца ценообразования на ИИ-инфраструктуру, будут не теми, кто запускает самую дешевую модель. Это будут те компании, чьи агенты умны и точно знают, во сколько им обходится процесс мышления.
В этом и заключается проблема 100-кратного роста. И она наступает быстрее, чем падение цен может это замаскировать.
Майтрейи Чаттерджи (Maitreyi Chatterjee) — старший инженер-программист в крупной технологической компании.
Деванш Агарвал (Devansh Agarwal) работает инженером по машинному обучению в ведущей технологической компании.
Добро пожаловать в сообщество VentureBeat!
Наша программа гостевых публикаций — это площадка, где технические эксперты делятся инсайтами и представляют нейтральные, непредвзятые глубокие обзоры об ИИ, инфраструктуре данных, кибербезопасности и других передовых технологиях, формирующих будущее корпоративного сектора.
Читайте больше материалов из нашей программы гостевых публикаций и ознакомьтесь с нашими рекомендациями, если вы хотите написать собственную статью!




