


ИИ-агенты создают скрытые инфраструктурные риски


Существует категория производственных инцидентов, которые инженерные команды еще не отслеживают, — потому что они не вписываются ни в один существующий шаблон разбора полетов (постмортема).
Агент инициировал действие. Действие было технически правильным с точки зрения контекста агента. Контекст был неполным. Инфраструктура дала сбой по цепочке. И к моменту разбора инцидента три команды спорили о том, был ли это сбой агента или сбой инфраструктуры, поскольку методологии осмысления этих двух вещей никогда не были связаны между собой.
Масштаб этого риска уже не носит теоретический характер. Семьдесят девять процентов организаций в настоящее время используют ту или иную форму ИИ-агентов в продакшене, а 96% планируют расширение. По прогнозам Gartner, к 2028 году 33% корпоративного ПО будет включать агентный ИИ, однако в отдельном предупреждении отмечается, что 40% таких проектов будут отменены из-за слабого контроля рисков.
Ни одна из этих статистических величин не отражает тот тип сбоев, который происходит между этими двумя цифрами: агенты, которые работают, не отменяются и при этом незаметно генерируют инфраструктурные события, которые никто не классифицировал как риск.
Я посвятил шесть лет созданию систем автоматизации инфраструктуры в масштабах предприятия — сначала в Cisco (где я руководил развертыванием платформ жизненного цикла на базе ИИ у более чем 20 глобальных корпоративных клиентов), а затем в Splunk (проектируя рабочие процессы анализа первопричин и наблюдаемости с помощью ИИ для тысяч корпоративных сред).
За это время я также подал заявку на патент на методологию хаос-инжиниринга на основе намерений (intent-based chaos engineering). И на протяжении всего этого времени я наблюдал, как организации совершают одну и ту же структурную ошибку: они рассматривают автономных агентов и хаос-инжиниринг как отдельные дисциплины. Это не так. Это одна и та же дисциплина, и разрыв между ними тихо порождает новую волну крупных производственных инцидентов.
Принятие решений, которые агенты пропускают
Чтобы понять, почему это важно, нужно разобраться, что именно не так в том, как предприятия управляют хаосом сегодня, еще до того, как мы добавляем в эту картину агентов.
Большинство зрелых инженерных команд инвестировали в программы хаос-инжиниринга. Игровые дни (game days), средства контроля радиуса поражения (blast radius), эксперименты, ограниченные по SLO (соглашениям об уровне обслуживания). Когда инженер-человек инициирует эксперимент по хаосу, эта последовательность обладает важнейшим свойством: человек принимает осознанное решение о том, есть ли у системы сейчас емкость для поглощения возмущения. Он проверяет дашборды. Смотрит на скорость исчерпания бюджета ошибок (error budget burn rate). Оценивает стабильность зависимостей. Это несовершенно и часто интуитивно, но по крайней мере в контуре есть человек, который задает правильный вопрос перед тем, как что-либо запустить.
Когда вы внедряете автономного агента исправления неполадок — того, который может перезапускать сервисы, перенаправлять трафик, масштабировать ресурсы или изменять конфигурации в ответ на обнаруженные аномалии, — этот вопрос исчезает. Агент видит аномалию. Агент предпринимает действие. Действие является хаос-событием. Никакой проверки скорости исчерпания SLO. Никакого расчета радиуса поражения. Никакого человеческого суждения о том, является ли данный момент подходящим временем для создания дополнительной стрессовой нагрузки на систему, которая и так может находиться под давлением с трех других сторон.
Вот конкретный сценарий сбоя, за которым я наблюдал. Агент по устранению неполадок обнаруживает повышенную задержку в микросервисе и реагирует на это перезапуском кластера сервисов — вполне разумное действие, учитывая его обучающие данные и узкий взгляд на инцидент. Чего агент не знает: три других сервиса находятся в процессе обработки пикового трафика. Общий пул соединений уже загружен на 87%. Зависимая база данных выполняет фоновую перестройку индекса. Перезапуск вызывает лавинообразный шквал запросов (thundering herd) к восстанавливающемуся сервису.
То, что начиналось как всплеск задержки, который агент был призван устранить, превращается в каскадный сбой, моделировать который агент никогда не был запрограммирован. Радиусом поражения этого действия агента был вовсе не перезапуск сервиса. Им стало все, что находится ниже по цепочке от этого перезапуска — в состоянии системы, о котором у агента не было полной картины.
Ни одна программа хаос-инжиниринга не тестировала эту конкретную комбинацию. Ни один расчет радиуса поражения не включал агента в качестве действующего лица. Потому что мы не воспринимаем агентов как инжекторов хаоса. А стоило бы.
Согласно данным Базы данных инцидентов ИИ (AI Incidents Database), число зарегистрированных инцидентов, связанных с ИИ, выросло с 2024 по 2025 год на 21%. Эта цифра почти наверняка занижает реальные масштабы рисков, поскольку у большинства организаций нет классификации инцидентов, которая фиксировала бы действие автономного агента в качестве первопричины каскада. Инцидент регистрируется как перезапуск службы, насыщение пула соединений или событие задержки. Сам агент в постмортеме отсутствует.
Емкость поглощения — это ресурс; большинство систем к ней так не относятся
Основная проблема заключается в том, что у корпоративных систем нет общего языка для описания емкости поглощения (absorb capacity) — оценки в реальном времени того, какое дополнительное напряжение система способна выдержать до того, как нарушит свои обязательства по SLO. Программы хаос-инжиниринга управляют этим неявно: через человеческую интуицию и статические пороги, которые срабатывают уже после того, как лимит был превышен. Агенты не управляют этим вовсе.
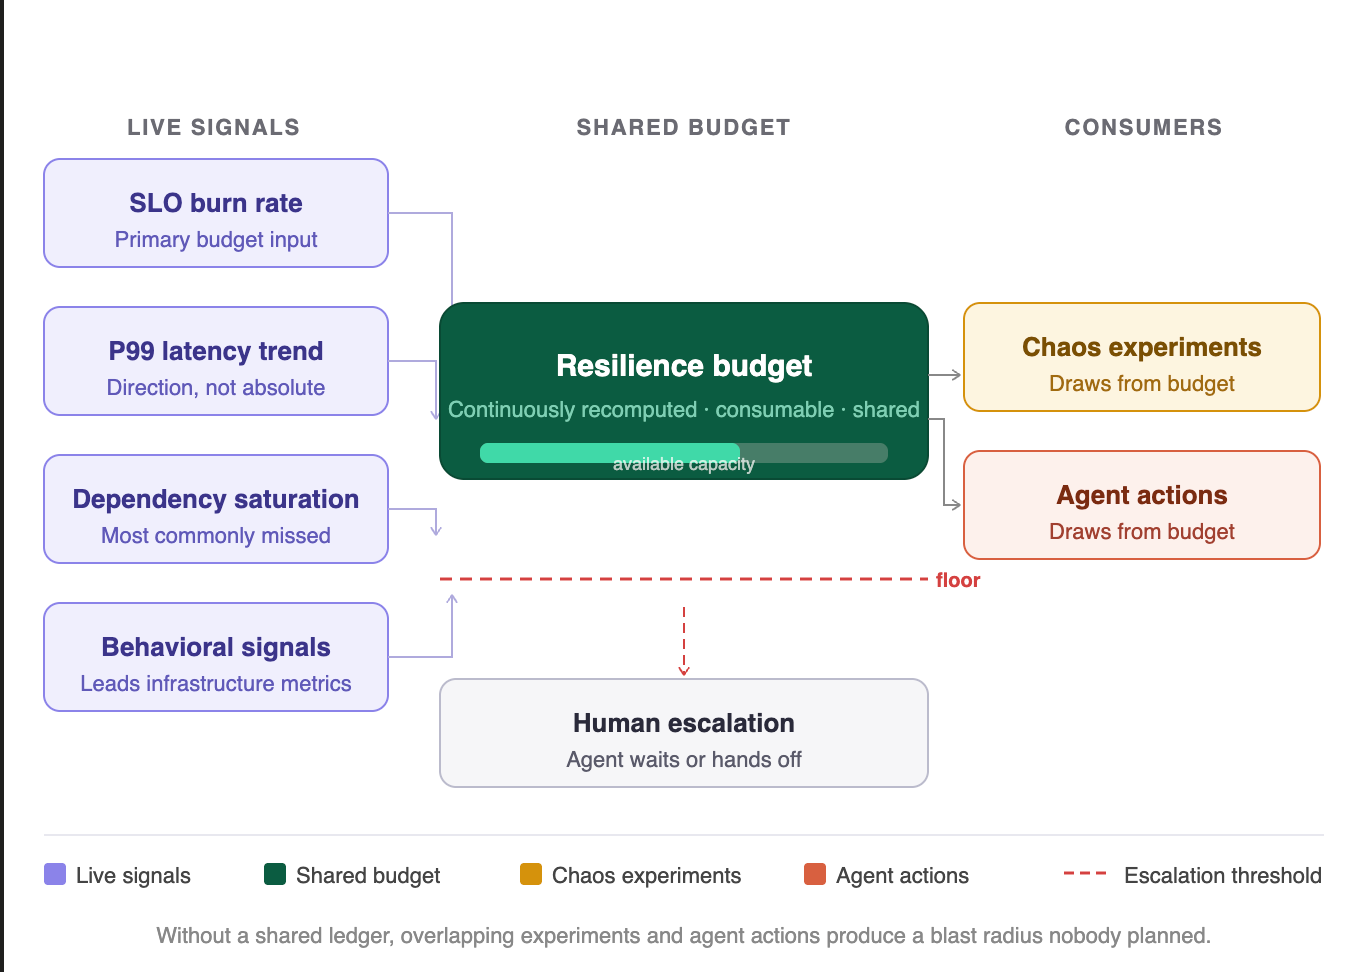
Проведя структурированные первичные исследования с практиками в области SRE (надежности сайтов) и платформенной инженерии из таких организаций, как Intuit и GPTZero, я занялся разработкой модели бюджета устойчивости (resilience budget). Основная идея заключается в том, чтобы относиться к емкости поглощения как к непрерывно пересчитываемому потребляемому ресурсу, а не как к статическому порогу, который стараешься не переступить.
Бюджет устойчивости опирается на четыре класса сигналов в реальном времени.
-
Скорость исчерпания SLO является основным входным данными, поскольку она напрямую кодирует расстояние между текущим поведением системы и обязательством, которое действительно имеет значение. Если система расходует свой ежемесячный бюджет ошибок в пять раз быстрее ожидаемого, бюджет устойчивости близок к нулю независимо от того, как выглядит загрузка ЦП.
-
Тренды P99 задержки важнее абсолютной задержки, потому что сервис, демонстрирующий рост в течение сорока минут, говорит вам о другом, нежели сервис, стабильный на том же абсолютном значении.
-
Состояние насыщения зависимостей — это сигнал, который упускают из виду чаще всего; хаос-эксперимент или действие агента, которые предполагают, что общий пул соединений свободно доступен, в то время как он загружен на 87%, приведут к сценариям сбоев, к которым никто не готовился.
-
Сигналы поведения приложений — показатели завершения сеансов, изменения паттернов вызовов API, деградация конверсии — сигнализируют о стрессе системы раньше, чем инфраструктурные метрики, потому что пользователи ощущают деградацию раньше, чем ее зафиксирует Prometheus.
То, что делает это бюджетом, а не пороговым значением, заключается в его расходуемости. Каждый хаос-эксперимент забирает часть доступной емкости. Каждое действие агента забирает ее. В мультикомандных организациях, где одновременно могут действовать несколько экспериментов и несколько агентов, этот бюджет является общим.
Без общей книги учета потребления две команды, проводящие эксперименты с пересекающимися зависимостями, создают совокупный радиус поражения, который ни одна из команд не планировала. Добавьте сюда автономных агентов, действующих полностью вне этой книги учета, и бухгалтерский учет рушится.
Изображение предоставлено автором.
Где языковые модели помогают и где именно они терпят неудачу
В настоящее время ряд инженерных команд проводит эксперименты с использованием больших языковых моделей (LLM) для генерации гипотез хаоса на основе графов зависимостей и корпоративных баз разборов инцидентов (постмортемов). Результаты полезны в заданном направлении. Языковые модели выявляют правдоподобные сценарии сбоев, которые опытные SRE считают целесообразным протестировать, и генерируют гипотезы быстрее, чем ручные процессы, особенно при работе с богатой историей постмортемов.
Предел кроется в устаревании графа зависимостей, и это непреодолимый предел. Гипотеза, сгенерированная на основе графа, который не отражает извлечение сервиса в прошлом месяце или новую зависимость от общей библиотеки, добавленную два спринта назад, предложит эксперимент с неверными допущениями о радиусе поражения. Проблема не в том, что модель совершает ошибку, а в том, что модель не знает, что она ее совершает. Она будет с уверенностью заблуждаться относительно границ системы, которых больше не существует, а в хаос-инжиниринге уверенная неверность в продакшене означает незапланированный сбой.
Лаборатория исследования надежного ИИ Стэнфордского университета (Stanford’s Trustworthy AI Research Lab) обнаружила, что защитных барьеров на уровне модели самих по себе недостаточно: атаки путем тонкой настройки (fine-tuning attacks) обходили ведущие модели в большинстве протестированных случаев. Из этого следует прямой вывод для генерации гипотез хаоса: модель, которая не может надежно удерживать собственные границы безопасности, не может считаться надежной для точного моделирования радиуса поражения действия, которого она никогда не видела в графе зависимостей, который она не проверила.
Когда генерация гипотез вместо этого опирается на базы данных постмортемов, проблема устаревания существенно уменьшается. Постмортемы описывают сбои, которые действительно происходили в системе в определенный момент времени. Сигнал изначально подтвержден реальностью продакшена. Это жизнеспособное краткосрочное применение ИИ в данной области, и оно действительно полезно для организаций с устоявшейся практикой документирования инцидентов.
Чего ИИ не может делать и о чем его не следует просить, так это принимать решение о выполнении в условиях двусмысленных сигналов. Это суждение требует осведомленности о вещах, которые существуют полностью вне любой системы мониторинга: предстоящие развертывания, которые изменили ландшафт зависимостей час назад, уровень дежурного персонала в праздничные выходные, обязательства перед клиентом, из-за которых любые дополнительные риски недопустимы до понедельника.
Модель, не имеющая доступа к этому контексту, не должна принимать такое решение. Это не временное ограничение в ожидании более способной модели, а структурное ограничение того, что может представлять машинная наблюдаемость, и создание архитектуры агента, которая игнорирует это, означает создание архитектуры, которая в конечном итоге примет судьбоносное решение на основе неполной информации — и без человека в контуре, который мог бы ее подстраховать.
Что это значит для управления агентами в продакшене на уровне предприятия
Импликацию для управления описать просто, но реализовать ее сложнее, чем кажется. Каждое действие автономного агента, затрагивающее инфраструктуру, должно регистрироваться в том же слое сигналов реального времени, который управляет хаос-экспериментами. Те же скорости исчерпания SLO, тренды задержек, состояния насыщения зависимостей, которые проверил бы инженер-человек перед инициированием эксперимента, должны служить барьером для того, что агенту разрешено делать и когда. Если бюджет устойчивости ниже определенного минимального порога (floor), агент ждет или эскалирует проблему. Он не предпринимает действий.
Действия агентов также должны моделироваться как эксперименты, а не просто регистрироваться как события. Когда агент перезапускает сервис, вопрос заключается не только в том, успешно ли завершился перезапуск. Вопрос в том, был ли радиус поражения этого действия соразмерен доступной емкости поглощения и какие каскадные эффекты он вызвал в зависимостях. Это данные хаос-инжиниринга. Они должны находиться в модели бюджета, подпитывая следующее решение, которое необходимо принять агенту или команде.
И когда сигналы действительно неоднозначны — когда оценка бюджета неясна, когда недавнее развертывание изменило топологию так, как не улавливает окно контекста агента, когда состояния зависимостей нестабильны — решение о выполнении должно передаваться человеку. Не как временное ограничение автономности агента, а как жесткое инженерное требование для текущего уровня технологии.
Автоматический выключатель (circuit breaker), передающий двусмысленные кейсы человеку, — это не слабость в архитектуре агента. Это то самое, что делает архитектуру достаточно надежной для реальной работы в продакшене. Верификация на основе намерений формализует именно это: определение того, как выглядит правильное поведение агента до развертывания, с последующим непрерывным зондированием того, сохраняются ли эти границы в условиях живой системы.
Организации, которые надежно управляют автономными агентами в масштабе, — это не те, у которых самые изощренные модели. Это те, кто понял, прежде чем что-то пошло не так, что каждое действие агента является хаос-собоятийным фактором, и выстроил свой уровень управления соответствующим образом.
Практический первый шаг лишен лоска: проведите аудит каждого автономного агента, который в настоящее время затрагивает инфраструктуру, сопоставьте его поверхность действий с вашими сигналами скорости исчерпания SLO в реальном времени и определите явные пороговые условия, ниже которых агент обязан ждать или эскалировать. Этот аудит выявит агентов, действующих полностью вне вашего бухгалтерского учета устойчивости.
Большинство организаций, использующих агентов в масштабе сегодня, имеют таких немало. Найдите их раньше, чем это сделает продакшн.
Саяли Патил (Sayali Patil) более 6 лет проработала в Cisco Systems и Splunk, создавая системы надежности и автоматизации, обеспечивающие масштабную работу корпоративной инфраструктуры ИИ.
Добро пожаловать в сообщество VentureBeat!
Наша программа гостевых публикаций предназначена для технических экспертов, которые делятся своими идеями и предоставляют нейтральные, непредвзятые глубокие обзоры ИИ, инфраструктуры данных, кибербезопасности и других передовых технологий, формирующих будущее бизнеса.
Читайте далее в рамках нашей программы гостевых постов — и ознакомьтесь с нашими рекомендациями, если вы заинтересованы в публикации собственной статьи!




